AXI4 与 AXI4-Lite 区别:什么时候该用哪一个
更新时间:2026-10-28。本文是「集成电路大类 · 芯片设计」入门层的一篇辨析短文。在 AMBA 总线入门 里我们认识了 AMBA 家族,动手写过 AXI4-Lite 从机 和 AXI4 全功能主机 之后,最常被问的一句话就是:这两个名字只差一个后缀的协议,到底差在哪、选错会怎样?这篇只回答这一个问题,协议细节不重复展开。
本文要回答的问题
- AXI4 与 AXI4-Lite 区别到底在哪几条?只是「砍掉了 burst」吗?
- 为什么配置寄存器清一色用 AXI4-Lite,而 DDR 控制器一律用 AXI4?
- 用错协议(给数据通路挂 Lite、给寄存器挂全功能)会有什么实际损失?
简短结论
一句话:AXI4-Lite 是 AXI4 的「单次传输子集」——去掉了突发(burst,一次地址带多拍数据)、去掉了事务 ID 与乱序完成、去掉了独占访问等高级特性,只保留「一次握手读写一个数据」的能力。配寄存器用 Lite,搬数据用 AXI4,这是业界默认分工。
一、四条核心区别
1. 突发传输(burst)——最本质的一条。 AXI4 一次地址相位可以声明 1 到 256 拍的连续传输(INCR 类型),地址只发一次,数据拍一拍接一拍流过去;AXI4-Lite 没有 AWLEN/ARLEN、AWSIZE/ARSIZE、AWBURST/ARBURST 这组信号,每次事务恰好一拍数据。想搬 4KB 数据,AXI4 用十几个事务就够,Lite 得发一千多次完整握手,地址通道开销占了绝对大头。
2. 事务 ID 与乱序。 AXI4 的每个通道带 AWID/BID/ARID/RID,主机可以同时挂出多个未完成事务(outstanding),不同 ID 的响应允许乱序返回,从机可以按自己的节奏重排;AXI4-Lite 全部砍掉 ID 信号,同一时刻只允许一个未完成事务(或靠实现自定,但协议不保证排序之外的任何并发收益)。这直接决定了 Lite 无法隐藏从机延迟。
3. 数据位宽与信号集规模。 AXI4 数据总线可以做到 32/64/128/256/512 甚至 1024 位;AXI4-Lite 规范只允许 32 或 64 位。信号数量上,一个 32 位 AXI4 全功能接口约 70 根信号,同位宽 Lite 只有约 40 根——少掉的三成就是 burst 控制、ID、独占访问(AWLOCK/ARLOCK)、缓存属性(AWCACHE/ARCACHE)、QoS 这些。
4. 写数据交织与高级响应。 AXI4 原本还支持(AXI3 遗留的)写数据交织在 AXI4 里已被移除,但独占访问、非对齐传输、窄带传输(narrow transfer)仍在;Lite 一律不支持,连WSTRB 虽然保留,但语义上假设整拍寄存器写入为主。
下面这张对比卡把两条协议的关键能力并排摆开,左栏是「能用」的,右栏是「被砍掉的」,先看有没有 burst 和 ID 这两项,其余差异基本都是它们的推论。
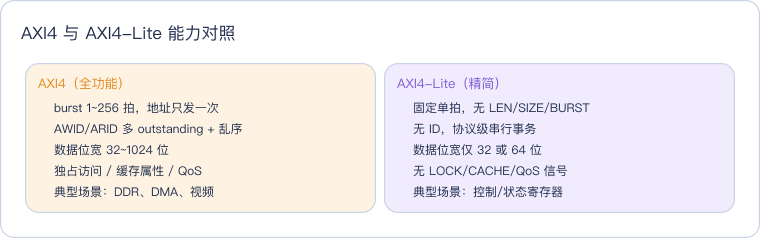
读这张卡抓住一个顺序:burst 决定带宽上限,ID 决定并发能力,位宽决定单拍能搬多少——三项叠加,同样是 100MHz 时钟,32 位 AXI4 跑 256 拍 INCR 的理论带宽接近 400MB/s,Lite 算上地址握手开销往往只剩四分之一不到。
二、从系统分层看两者各站哪一层
区别放到一张 SoC 框图里会更直观:AXI4 在「数据平面」,连接 CPU、DMA、DDR 这些吃带宽的角色;AXI4-Lite 在「控制平面」,从 CPU 分一根细线去点外设的寄存器。两者通过同一个互连(interconnect)共存,互连内部做协议转换。
图中蓝色块是数据平面角色(吃带宽、挂 AXI4),绿色块是控制平面角色(只吃配置、挂 Lite)。互连器允许两种协议混挂,这就是为什么一个系统里两种协议可以同时存在而不冲突。
三、一个具体例子:给一个 PWM IP 选接口
假设你做了一个 PWM 发生器 IP,它有两个功能面:一是软件配置周期、占空比(两三个 32 位寄存器),二是可选的波形数据表(几 KB,由 DMA 灌入)。
- 配置面挂 AXI4-Lite:地址少、访问稀疏(初始化写一次,运行中偶尔改),用 Lite 省下的 30 根信号和对应的译码逻辑,综合出来的面积大约只有全功能从机的一半,时序也更容易收敛。
- 数据面挂 AXI4(或 AXI4-Stream):波形表要整块灌入,必须用 burst 才能吃满带宽,挂 Lite 会让灌表时间拉长一个数量级。
很多商用 IP 核正是这么干的——同一个模块上同时暴露一个 s_axilite(配置)和一个 s_axi(数据),两个口井水不犯河水。想动手写一个最小 Lite 从机,可以照着 用 cocotb 验证 AXI4-Lite 从机 这篇的实验跑一遍,握手细节见 VALID-READY 握手。
四、选型思维导图
拿不准的时候,从「这个口要搬的最大一块数据有多大」出发往下问,三层问题就能收敛到答案。
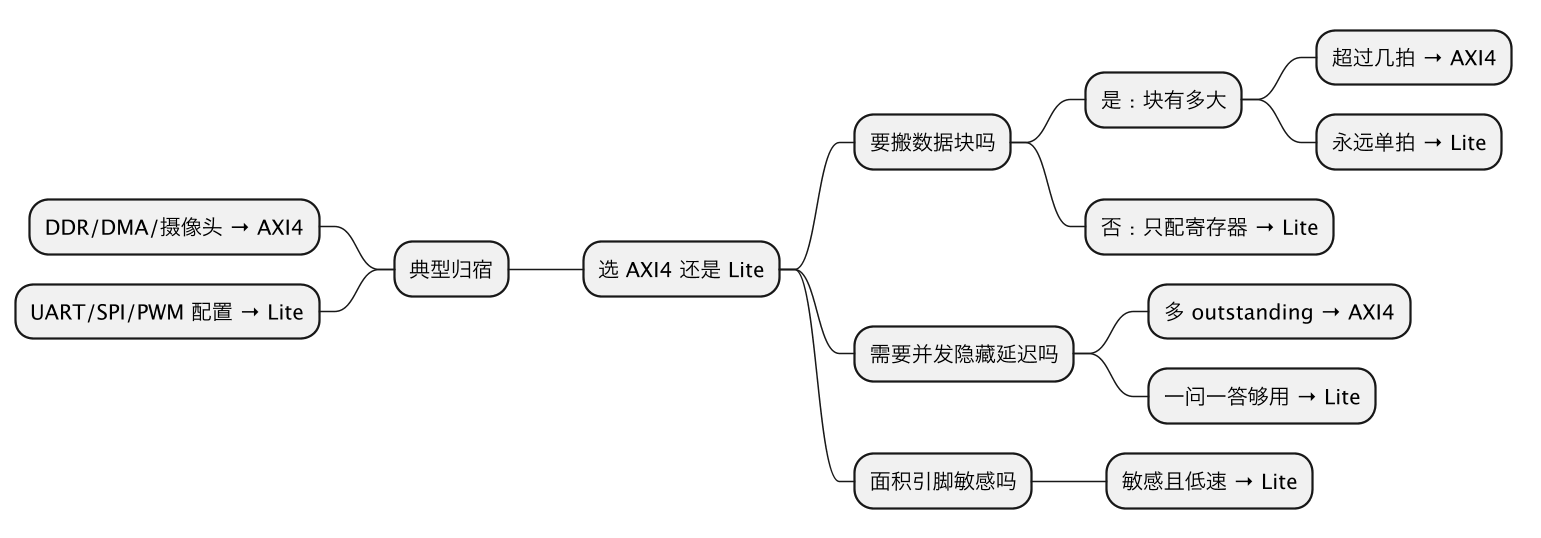
这张图的左边一列其实可以背下来:凡是「控制器去搬数据」的角色都站 AXI4,凡是「CPU 偶尔来拧个旋钮」的角色都站 Lite。真实项目里 90% 的接口选型用这张图就够了,剩下 10% 的纠结(比如要不要上 ACE 做一致性)属于更后面的事。
常见误区
- 「Lite 就是 AXI4 慢一点而已」:错。区别不是速度档位,是协议能力——没有 burst 意味着协议层面就发不出长传输,再快的时钟也补不回地址通道的开销。
- 「寄存器口挂全功能 AXI4 更保险」:不保险,是浪费。多出来的信号要接、要验、要占布线资源,验证环境(VIP)的复杂度也跟着翻倍。低速配置口用 Lite 是业界惯例,见 AMBA 总线选型指南。
- 「Lite 可以一个地址读一串寄存器」:不行。想读 16 个连续寄存器就得发 16 次读事务,这也是寄存器批量回读场景要配 DMA 而不是让 CPU 用 Lite 硬刷的原因。
- 「AXI4-Lite 和 APB 差不多所以可以互换」:接近但不同。APB 更省(两拍非流水),Lite 保留 VALID/READY 握手、能直接挂进 AXI 互连,桥接成本最低。
- 「burst 只是带宽优化,功能上单拍多发几次等价」:功能上确实等价,但时序与资源上不等价。256 拍 INCR burst 只仲裁一次地址通道,从机内部还能按顺序流预取;拆成 256 次单拍事务意味着 256 次地址握手与仲裁,互连器里每次都要重新抢总线。实测口径上,同一个 DDR 控制器在单拍模式下的有效带宽常常掉到 burst 模式的三到五分之一,这笔账在选型时就得算进去。
一个带宽演算:4KB 数据两种口各要多久
用具体数字感受一下差距。假设 100MHz 时钟、32 位数据(每拍 4 字节),搬 4KB 共 1024 拍数据:
- AXI4(INCR burst,256 拍一笔):4 笔事务。地址开销 4 拍,数据 1024 拍,合计约 1028 拍 ≈ 10.3µs。
- AXI4-Lite(单拍,地址+数据两次握手):1024 笔事务,每笔保守按 4 拍(AW、W、B 通道串行开销)计,约 4096 拍 ≈ 41µs。
同样是 4KB,Lite 慢约 4 倍,而且从机延迟越高差距越大(Lite 没有 outstanding,每次都要干等响应)。这正是「配置走 Lite、数据走 AXI4」背后的量化依据:寄存器配置一次只写 4 字节,41µs 的开销摊到 1024 次才疼,而单次配置只花几十纳秒级别,完全无所谓。
这一篇在知识体系里的位置
本篇是 AMBA/AXI 簇的「辨析入口」:向上接 AMBA 总线入门 与 片上总线总览,向下分两路——配置面深入读 AXI4-Lite 从机实现,数据面深入读 AXI4 全功能基础;选型纠结时回看 AMBA 总线选型指南。
一句话总结
AXI4 与 AXI4-Lite 区别的本质是「能力裁剪」而非「速度档位」:Lite 砍掉 burst、事务 ID 与高级属性,只留单拍读写,换来信号与面积减半;数据平面(DDR/DMA/视频)用 AXI4,控制平面(配置/状态寄存器)用 AXI4-Lite,选错方向的代价是带宽量级差或面积验证成本白付。