CCS power 动态功耗建模:Liberty 复合电流源功耗与 NLDM power 查表差在哪
本篇是签核功耗数据链的模型层纵深,与 NLDM CCS 时序模型 互为姊妹篇——那一篇讲延迟,这一篇讲功耗。Liberty 库文件字段结构见 Liberty 库与多视图,电流波形怎么从 SPICE 里扫出来见 APL 电流波形特征化,模型最终被谁消费见 功耗签核 Voltus 与 RedHawk。本篇只回答一个问题:同一个翻转事件,为什么用 NLDM power 和 CCS power 两种库算出来的动态功耗可以差到 10% 以上,以及这个差距怎么传导到 IR drop 签核。
本文要回答的问题
- NLDM power 在
.lib里存了什么,一次翻转的功耗是怎么"查"出来的? - CCS power 相比 NLDM power 多保留了哪些物理信息,为什么更准?
- 电流波形积分求功耗具体怎么算,谁来做积分?
- 动态功耗的三个成分(充放电、短路、漏电)在两种模型里分别怎么覆盖?
- 不跑仿真向量的 vectorless 功耗分析,精度到底从哪来?
一、NLDM power:把一次翻转压成一张能量表
NLDM power 的建模思路和 NLDM 时序一脉相承:把"翻转一次消耗多少能量"当成一个只依赖输入跳变时间和输出负载的标量,特征化时扫二维网格存进 .lib 的 internal_power 组里:
pin (Y) {
  internal_power () {
    related_pin : "A";
    rise_power (energy_template_7x7) {
      index_1 ("0.01, 0.05, 0.1, ...");   /* input transition */
      index_2 ("0.001, 0.005, 0.01, ..."); /* output cap */
      values ("1.2, 1.5, ...");
    }
    fall_power (energy_template_7x7) { ... }
  }
}注意表里的数值单位是能量(pJ),不是功率。功耗分析工具拿到某单元一次翻转时,先由 STA 引擎给出输入 slew 和输出等效电容,进表双线性插值得到"这一次翻转的内部能量",再乘以翻转率(toggle rate)得到平均功耗:
P_internal = E_per_toggle(插值) × toggle_rate × f_clk
P_total    = P_internal + P_switching + P_leakage
其中 P_switching = 0.5 × C × V² × toggle_rate × f_clk 是输出线上寄生电容的充放电功耗,工具用解析公式直接算,不走库表;漏电功耗 leakage_power 在库里是按输入状态(when 条件)存的静态查表。所以 NLDM power 框架下,库真正负责建模的只有 internal power 这一块——也就是晶体管内部的短路功耗和对内部节点电容的充放电。
| 功耗成分 | 物理含义 | NLDM power 怎么算 |
|---|---|---|
| Switching(充放电) | 输出线寄生 C 充放电 | 解析公式 0.5CV²fα,不走库 |
| Internal(短路+内部节点) | PMOS/NMOS 同时导通的直通电流、内部节点充放电 | rise_power/fall_power 能量查表 |
| Leakage(漏电) | 亚阈值、栅氧隧穿 | leakage_power 按 when 状态查表 |
这套抽象在 90nm 以上工作得很好,因为那时短路功耗占比小(典型 10%~20%),波形接近斜坡,"一次翻转 = 一份固定能量"的假设误差可控。但先进节点三个变化让这个假设松动,下一节展开。
二、为什么能量查表在先进节点失真
NLDM power 的致命伤和 NLDM 时序是同一个:它把波形信息全丢掉了。能量表只记录"这次翻转总共耗了多少",不记录"电流在什么时刻、以什么形状流出来"。这带来三类失真。
第一类:短路功耗对波形强敏感。 输入跳变越慢,PMOS 和 NMOS 同时导通的时间窗口越长,短路电流积分越大。查表虽然用 input transition 做了索引,但真实输入波形不是斜坡——上游是 CCS 驱动的分布式 RC 网络,输出波形带尾巴、带拐点,用"等效 slew"一个标量进表,在 16nm 以下短路功耗占比回升到 20%~30% 的节点上,插值误差可以到 15%。
第二类:有效电容问题复刻到功耗域。 时序侧"电阻屏蔽让驱动器只看到有效电容"的现象,在功耗侧同样存在:0.5CV²fα 里的 C 到底取总电容还是有效电容?取总电容会高估充放电功耗,长线网上高估 10% 很常见;取有效电容又要迭代,且迭代结果和时序用的有效电容未必一致。
第三类:IR drop 分析需要的是电流形状,不是平均功耗。 这是最关键的一条。平均功耗只能算静态 IR drop(平均电流压降),而先进节点的致命问题是动态 IR drop——成千上万个单元在同一时钟沿附近同时翻转,瞬态电流尖峰把局部电压瞬间拉低,导致邻近单元延迟暴涨甚至功能错误。算动态 IR 必须知道每个单元的电流随时间的波形,而 NLDM power 的能量表里没有这个时间轴。RedHawk/Voltus 拿到 NLDM 库只能用"三角形近似"把能量摊到一个假设的时间窗里,电流峰值高度和位置全是猜的。
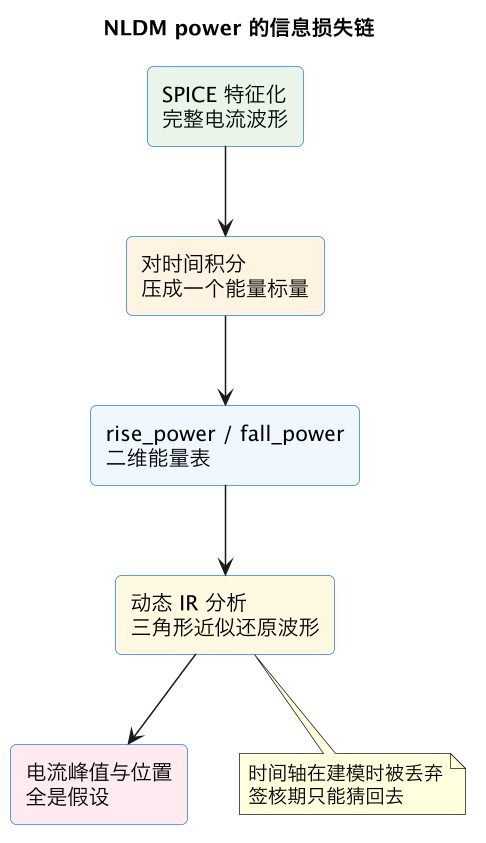
上图是 NLDM power 的信息流:特征化时明明有完整电流波形,入库时被积分压成标量,签核时又得凭空还原出波形。一压一还,两端各引入一次误差。CCS power 的解法很直接——别压,把波形存下来。
三、CCS power:直接存电流波形,功耗靠积分
CCS power(复合电流源功耗模型,在 .lib 里体现为 dynamic_current 以及配套的 leakage_current、intrinsic_parasitic 等组)沿用了 CCS 时序的哲学:驱动器是受控电流源,那就把功耗分析需要的电流量也建成波形。
核心数据结构是 dynamic_current 组,它挂在输出 pin 的 ccsn_* 级之下,对每种输入组合和翻转方向,存的是电源/地网络上电流随时间的完整波形:
pin (Y) {
  ccsn_first_stage () {
    dynamic_current () {
      related_inputs : "A";
      typical_capacitances : "0.005";
      switching_group () {
        input_slew : 0.05;
        output_capacitance : 0.01;
        Ivdd : current_waveform {
          values ("0.0, 1.2, 3.8, 2.1, 0.3, 0.0");  /* mA */
          time   ("0.0, 0.02, 0.05, 0.09, 0.14, 0.20"); /* ns */
        }
        Ivss : current_waveform { ... }
      }
      ...
    }
  }
  intrinsic_rise / intrinsic_fall  { ... }  /* 无负载本征电流 */
  leakage_current () { when : "A"; value : ... }
}
和 NLDM power 比,这组数据有三个本质区别:
- 多了一条时间轴:不是"一次翻转多少 pJ",而是"这次翻转的电流在 0.2ns 内怎么起伏",峰值、宽度、形状全保留;
- 分电源网络存:
Ivdd和Ivss分开记录,IR drop 引擎可以把电流直接注入 PG 网络的对应节点,不用再做"功耗→等效电流源"的换算; - 区分有载与无载:
intrinsic_*存空载下的本征电流(短路电流+内部节点),dynamic_current存带载总电流,两者相减能把充放电成分和短路成分在波形级别分开,而不是像 NLDM 那样靠公式拆分。
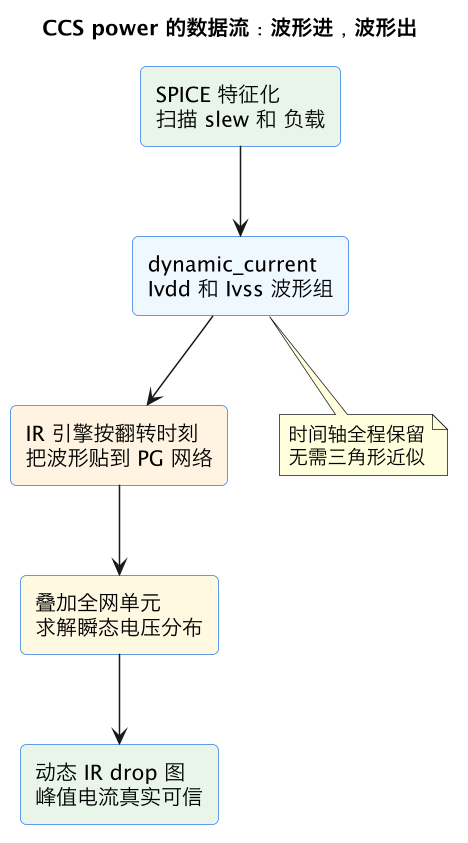
对比上一节 NLDM 的"压扁再还原"链,CCS power 全链路没有有损压缩:特征化出来的波形直接成为签核引擎的激励源。这就是为什么 RedHawk 的 dynamic IR 分析明确要求 CCS power(或 APL 产出的等效电流模型)库。
电流积分求功耗是另一头的事。当工具只需要平均功耗数字时(比如功耗报告、功耗驱动的优化),它对波形做一次积分:
E_toggle = ∫ Ivdd(t) × Vdd dt  (或 0.5 × (E_rise + E_fall) 配对)
P_avg    = E_toggle × toggle_rate × f_clk
积分对象是插值后的波形。CCS power 的插值在波形采样点上做——输入 slew 或负载落在两个索引点之间时,对每条采样曲线线性混合得到中间波形,再积分。由于波形形状对 slew/负载的变化相对平滑,这种插值比 NLDM 对能量标量的插值鲁棒得多:能量本身是 slew 的强非线性函数(尤其短路成分),而波形插值相当于在非线性函数积分之前先插值,误差天然更小。实测同一批单元,CCS power 积分出的 internal power 与 SPICE 参考的偏差典型在 2%~4%,NLDM power 查表在 8%~15%,长尾更差。
四、三种模型粒度的精度与成本对比
实际工程里功耗建模其实有三档粒度,CCS power 居中,两头分别是 NLDM power 和 APL(Advanced Power Library,直接给 IR 引擎用的原始电流波形库):
| 维度 | NLDM power | CCS power | APL 波形库 |
|---|---|---|---|
| 存储对象 | 能量标量查表 | Ivdd/Ivss 波形 + 时间轴 | 每 PVT 原始 SPICE 波形 |
| 平均功耗精度(对 SPICE) | 8%~15% | 2%~4% | 1%~2% |
| 动态 IR 可用性 | 仅静态 IR,动态靠三角近似 | 动态 IR 标配输入 | 动态 IR 最高保真 |
| 短路功耗建模 | 混在能量表里,靠 slew 索引 | intrinsic 与 dynamic 波形分离 | 原生分离 |
| 多电压/多电源网络 | 弱 | Ivdd/Ivss 分网存 | 原生 |
| 库体积 | 最小 | 约为 NLDM 库 2~3 倍 | 最大,按实例展开 |
| 典型消费方 | 综合期功耗估算 | RedHawk/Voltus signoff | Voltus/RedHawk 高精度模式 |
一个常被忽视的点:漏电功耗在 CCS power 框架下也升级了。NLDM 时代漏电是 leakage_power 标量;CCS 库里对应的是 leakage_current 和 gate_leakage,分电源网络存电流值,这在多电压域设计里可以直接算各电源轨的静态电流贡献,给 upf 电源域的 IR 预算提供更细的数据(电源域划分见 UPF 电源意图)。
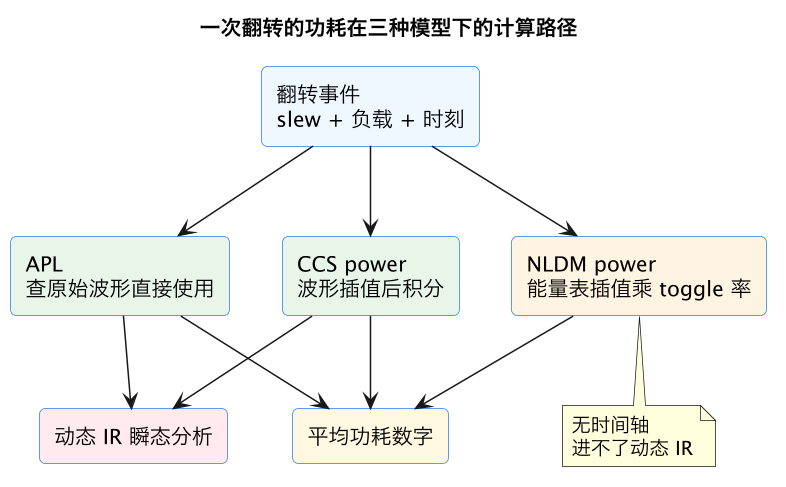
上图是同一个翻转事件在三种模型下的分叉:平均功耗三家都能出(精度不同),但动态 IR 的门只有 CCS power 和 APL 能进——NLDM power 在动态签核里是结构性缺席,不是精度差一点的问题。
五、Vectorless 功耗分析:精度从哪来
实际项目中大量功耗估算是在没有仿真向量的阶段做的:网表刚出来、VCD/SAIF 还没有,但功耗预算、PG 网络宽度、decap 用量都要先定。这就是 vectorless(无向量)功耗分析,它的精度来源可以拆成三块,而每一块都和库模型深度绑定。
第一块:翻转率传播。 不给向量时,工具从时钟频率和用户设定的默认翻转率(比如数据端 10%~20%、时钟端 100%)出发,沿组合逻辑逐级传播:与门输出翻转率按输入概率相乘打折扣,异或门放大,时序单元直接赋值。这块的误差来自翻转率假设本身,和库无关——但它决定了能量表/波形要被"激活"多少次。
第二块:每次激活花多少能量——这正是库模型说了算的地方。 vectorless 分析对每类单元、每种翻转方向查一次功耗模型,NLDM power 给标量、CCS power 给积分值。翻转率假设偏 20%,总功耗就偏 20%;但在同样翻转率下,模型差异 10% 就是实打实的模型误差,CCS power 在这里把这一项的方差压缩到 NLDM 的三分之一左右。
第三块:时间分布。 vectorless 动态 IR 不知道确切翻转时刻,工具按时钟周期内的概率窗分布翻转事件(clock gating 后的局部时钟沿、组合逻辑的延迟散布窗),每个事件的电流形状依然来自 CCS power 波形。形状越真实,事件叠加出的瞬态电流峰值越可信;NLDM 的三角近似在事件密集叠加时峰值误差可以放大到 30% 以上,足以把 decap 预算带偏一个量级。
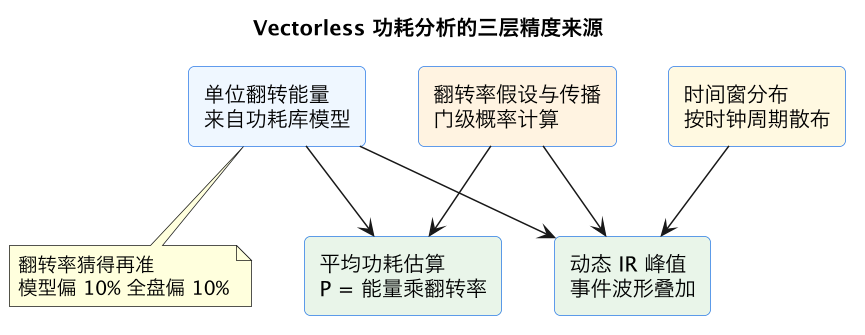
所以 vectorless 分析的结论要这样读:相对精度靠翻转率假设,绝对精度靠库模型。两份报告对比不同架构的功耗,用 NLDM power 也能看趋势;但要拿数字去定 PG 宽度、报功耗预算,必须换 CCS power 库重算,否则系统性偏差无从校准。等有向量后再用 VCD/SAIF 活动率数据 回填翻转率,那是校准第一块误差;库模型这块的误差,向量再多也救不回来。
六、工程选型建议
- ≤28nm 的 IR 签核一律 CCS power 起步:动态 IR、per-pg 电流分布、多电压域漏电拆分都建立在
dynamic_current/leakage_current波形上,NLDM power 只能出静态平均功耗报告; - 综合与早期功耗估算可用 NLDM power 快速迭代,但和时序库同理——signoff 前必须切 CCS power 重签,且两个库要来自同一次特征化、同一 PVT 角;
- 收到 .lib 先验货:搜
dynamic_current和intrinsic_rise,确认是真 CCS power 库;只有rise_power能量表却打着 CCS 旗号的"半库"在中小 foundry 交付物里并不少见; - 大驱动单元(clock buffer、level shifter、IO)重点查波形采样密度:采样点稀疏时积分出来的短路功耗反而不如 NLDM 查表稳,特征化侧要加密 time 轴采样;
- 时钟树功耗单独校核:时钟网络翻转率是数据网络的 5~10 倍,占全芯片动态功耗 30%~40%,对模型误差最敏感。同一份库,数据路径偏 5% 可能无感,时钟树上偏 5% 直接改写总功耗结论,建议时钟 buffer 单独抽 SPICE 回归;
- 多 corner 一致性检查:高温低压角短路功耗占比上升最快,是 NLDM power 查表误差最大的 corner。如果某个 corner 的功耗数字与相邻 corner 趋势反常(比如低压角功耗反而更高且无漏电解释),先怀疑模型插值外推,再怀疑设计;
- 高精度场景(先进节点 signoff、近阈值设计)直接上 APL 级波形库,CCS power 作为签核标配与 APL 的精度和体积折中。
这一篇在知识体系里的位置
- 同层姊妹篇:NLDM CCS 时序模型 讲延迟侧的同构问题(集总电容 vs 电流波形),两篇合起来是 Liberty 模型层的完整图景;
- 上游数据:Liberty 库与多视图 讲
.lib字段结构,APL 电流波形特征化 讲电流波形怎么从 SPICE 扫出来,活动率输入见 VCD/SAIF 活动率数据; - 下游消费:功耗签核 Voltus 与 RedHawk 讲模型如何驱动 IR drop 签核,EM 信号与功耗电迁移 讲功耗数据如何传导到电迁移检查,电源域背景见 UPF 电源意图。
总结
CCS power 把单元动态功耗从 NLDM power 的"能量标量查表"升级为"电源/地电流波形随时间存库":平均功耗靠波形插值后积分,精度从 8%~15% 提到 2%~4%;动态 IR 签核则拿到了真实的电流峰值与形状,摆脱了三角近似;vectorless 功耗分析的绝对精度最终由库模型决定——翻转率假设只影响相对趋势,先进节点签核必须用 CCS power 起步、高精度场景直上 APL。