FIFO 设计复盘:异步 FIFO 工程六个决策点的备选、代价与翻盘条件
专题导航:异步FIFO设计全景。前置要求:已读支柱页主线原理与本专题各变体篇(格雷码、满空语义、指针绕回、FWFT、almost 阈值、非对称位宽),手里有一个能跑通的异步 FIFO 工程印象。 上一篇:FIFO 设计评审清单(待发布)。下一篇:本专题到此收官,回到异步FIFO设计全景的学习路径图做一次全程回看;后续工程套件将进入 SRAM 控制器、UART 与 SPI 专题。 读序说明:本篇不引入任何新机制,只做一件事——把工程包
async-fifo-mini(rtl/async_fifo.v、rtl/fwft_fifo.v与tb/下十余个 testbench)演化途中做过的六个关键决策摊开,逐个回答「当时还能怎么选、为什么没选、什么条件下该重新选」。
本文要回答的问题
- 回看整条设计链,六个决策点各自要解决的原始问题是什么,先后次序为什么不能乱?
- 每个岔路口上落选的方案到底输在哪一项成本上:面积、延迟、复杂度,还是与主流 IP 的一致性?
- 被放弃不等于错误——哪些落选方案在深度、频率、工艺或接口形态变化后会反过来成为更优解?
- 六个决策之间有没有共用的思考框架,可以迁移到 SRAM、UART 等后续模块的设计里?
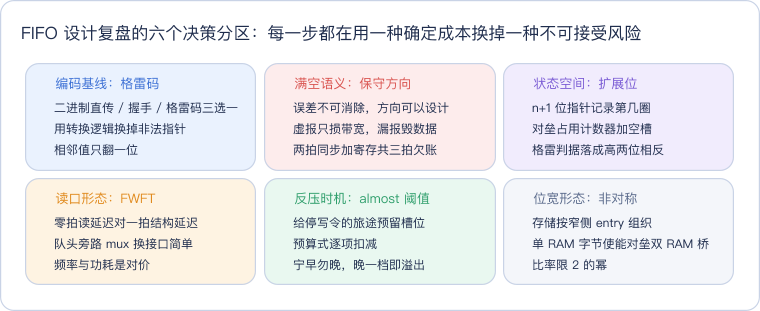
这张分区卡是全篇的索引:六组颜色对应六次独立决策,每组只放三行——原始问题、付出的成本、约束的形状。注意它们的排列顺序就是工程包的真实演化顺序:先解决指针能不能安全跨域,再解决跨域之后标志敢不敢信,然后才轮到读口时序、反压预算和位宽扩展这些接口层议题。底层机制不定,上层变体无从谈起。
一、决策点一:等宽格雷码基线——为什么跨域的只能是指针
当时的问题。异步 FIFO 的写侧与读侧各跑各的时钟,连续数据流要求每拍都可能入队一项,满空判定又必须同时看到两侧指针。指针是多位总线,而二进制递增一次最坏翻转多位(011→100 三位同翻),位间偏斜让目的触发器可能锁存到谁也没发送过的中间值。
| 候选方案 | 采样合法性 | 带宽代价 | 额外硬件 | 与数据变化模式的匹配 |
|---|---|---|---|---|
| 二进制指针直接两级打拍 | 不保证,可采到非法值且误差方向不可控 | 无 | 无 | 单调递变也救不了多位翻转 |
| req/ack 握手传指针 | 合法,但每次往返 2–4 个目的周期 | 有效带宽砍到四分之一以下 | 握手状态机 | 只适合稀疏事件 |
| 格雷码指针加两级同步 | 非旧即新,误差固定偏保守 | 每侧一级异或转换 | 转换逻辑加深度限 2 幂 | 与单调计数器天然匹配 |
选型理由。格雷码跨时钟域原理的采样实验把这件事做成了肉眼可见的判决:同一组三位计数器、同一个偏斜窗口,二进制 8 次采样 4 次非法,格雷码 8 次全部合法。格雷码用「转换逻辑、放弃大小比较、深度限 2 的幂」三笔确定成本,换掉「采样值语义非法」这一个不可接受的故障,是一边倒的交易。握手方案在带宽账上直接出局——深度 16 的 FIFO 两侧活跃时每拍都可能入队,没有握手窗口可用。
被弃方案何时翻盘。握手并非劣方案,而是放错了场景。后续专题里凡是稀疏的控制面事件——模式切换、中断、单次配置下发——握手用往返周期天然包住亚稳态收敛、零丢事件,反而比格雷码更合适。若跨域的是随机跳转地址而非单调指针,格雷码相邻单跳的性质直接失效,那时也只能回到握手或 RAM 隔离。没有普适的跨时钟域方案,只有与数据变化模式匹配的方案。
二、决策点二:满空保守语义——把误差方向钉死在安全象限
当时的问题。两级同步让对方指针永远迟到,两侧看到的满空标志必然带误差。问题于是从「怎么消除误差」(消除不了)变成「误差允许往哪个方向偏」。
| 候选方案 | 误差方向 | 数据安全性 | 吞吐代价 | 结构复杂度 |
|---|---|---|---|---|
| 乐观比较,相信跨域值即真值 | 可漏报满或漏报空 | 覆盖未读数据或读出垃圾,不可恢复 | 名义最高 | 最低,但不可用 |
| 格雷码旧值保守比较(选定) | 只可能虚报满、虚报空 | 结构上保证零溢出零读空 | 标志撤销滞后三拍,边界有气泡 | 与基线复用,无新增 |
| 三级、四级同步追可靠性 | 仍偏保守,滞后更长 | 失效率指数下降 | 每加一级气泡税线性多一拍 | 同步链加长 |
选型理由。满空语义与保守延迟把四种报错方向的后果摊得很清楚:虚报只挡住一笔请求、产生一个气泡,漏报则让第 17 个写覆盖未读数据。格雷码「非旧即新」加上两级触发器「只锁存不预测」,让两侧永远把 FIFO 看得比实际更挤,误差被结构钉死在安全象限。实测深度 16、读写真异步的工程,满空标志撤销稳定滞后三个目的时钟周期(相位欠账、两级同步、标志寄存各一笔),八轮临界往返征收 24 和 23 个气泡,而溢出、读空、数据错配全程为零。
被弃方案何时翻盘。保守气泡是浅 FIFO、读写速率接近时的真实税负,如果两侧时钟本来同源,就根本不该用异步 FIFO——同步 FIFO 同沿更新两侧指针,比较结果即时为真,三拍欠账一笔勾销。三级同步则在功能安全或 GHz 紧时序场景按 MTBF 预算上岗:高频示例工况下单级 MTBF 只有约 4 分钟、两级约 19 万年,车规场景产品队列尺度算不过账时,多花一级寄存器的延迟买指数级失效率改善,是合理兑换而非浪费。
整条决策链的演化主干画在下面的时间线里,颜色区分每一步买来的东西属于哪类决策:蓝色是编码地基,紫色是状态空间,橙色是接口时序,绿色是系统反压,灰色是位宽扩展,红色节点标出每一步防住的事故类型。
读这张图抓住箭头标签而不是节点本身:每一步的准入条件都是上一步已经兑现的保证。比如 almost 阈值预算之所以成立,前提是保守语义已经证明「同步值只会旧不会假」;若基线采到非法指针,再精巧的阈值公式也算不出正确水位。这也解释了为什么工程包的 testbench 按 tb_gray_sampling、tb_full_empty_semantics、tb_pointer_wraparound 的顺序组织——验证顺序与决策依赖同构。
三、决策点三:指针扩展位——一位寄存器买下整圈状态空间
当时的问题。深度 4 的 FIFO,写满四个数据后写指针绕回 00,与静止的读指针相等;把四个数据读空后两根指针还是 00。同一个观测值对应占用 4 和占用 0 两个真值,环形寻址丢掉的圈数差无处安放。这个歧义与时钟域无关,同步 FIFO 同样逃不开。
| 候选方案 | 可用容量 | 额外存储 | 异步适配 | 浅深代价 |
|---|---|---|---|---|
| n+1 位扩展指针(选定) | 全部 2^n 槽 | 两侧各一个寄存器位 | 天然适配,单向运动照常格雷跨域 | 一位成本随深度摊薄 |
| n 位指针加占用计数器、留一空槽 | 仅 2^n−1 槽 | 一个双向计数器含加减仲裁 | 差,计数器本身成新跨域热点 | 深度 4 浪费 25% |
| 非 2 幂深度避开绕回点 | 全部物理槽 | 取模与宽比较器 | 格雷码在绕回点多位翻转,基线失效 | 时序与面积双输 |
选型理由。指针绕回与扩展位的穷举实验显示,扩展位把地址环展开成一条直线:低位寻址、最高位记圈,空判扩展指针全等,满判圈数位相反而余位相同,翻译成格雷语言正好是「高两位取反、其余相等」的标准比较式。注错实验里裸指针的两种接线策略全部崩溃——「相等即空」让第 5 写覆盖未读数据,「相等即满」让 FIFO 上电死锁。一个信号承担两个真值,怎么接都必然在其中一个状态撒谎。
被弃方案何时翻盘。占用计数器方案在两个前提下翻盘:一是同步设计,计数器不存在跨域仲裁问题;二是深度足够大,留空一个槽的浪费比例从 25% 降到千分之一量级(深度 1024 时约 0.1%),而系统本来就需要占用量做 almost 标志或流量统计——这时计数器是顺手产物,扩展位反而是多余的一根线。非 2 幂深度则几乎永不翻盘,它只能挪动绕回位置、消不掉拓扑歧义,还赔上格雷码性质。
四、决策点四:FWFT 变体——把一拍读延迟挪到模块边界哪一侧
当时的问题。标准读模式的同步 RAM 走「address→memory→register」三段,读使能提出后下游要等一个周期才能采到数据。有些读者等得起,有些读者的总线周期里没有这一拍。
| 候选方案 | 读延迟 | fmax 与功耗 | 接口复杂度 | 与主流 IP 一致性 |
|---|---|---|---|---|
| 标准读模式(选定基线) | 1 拍,输出全寄存 | 路径短、可门控读口,fmax 高 | 读侧需预取状态机 | 块 RAM 原生形态 |
| FWFT 队头旁路(选定变体) | 0 拍,非空即直出 | 组合路径串 mux,fmax 低、无法门控 | valid 即非空,接线最简 | Xilinx FIFO IP 默认模式 |
| FWFT 外加接收寄存器 | 表面 1 拍 | 输入恒稳定,时序宽松 | 等价于 skid buffer | AXI-Stream 从端常见形态 |
选型理由。FWFT 与标准读模式的双变体同激励仿真显示,FWFT 在写入当拍就把首项摆上窗口、空闲时 rd_data 始终是有效队头,读使能退化为 pop;代价是一个位宽等于数据宽度的旁路 mux 加计数选择逻辑,以及 RAM 位线直出带来的频率与功耗损失。工程包因此把它做成独立文件 rtl/fwft_fifo.v 而不是塞进核心参数——两种读口共享同一套指针与存储,只替换出口结构。
被弃方案何时翻盘。高频数据通路、收敛时序的设计里标准模式反而是正解:输出寄存器切断 RAM 后的组合长路径,不 pop 就不翻转读地址,深 FIFO 的动态功耗显著更低。更有意思的是两者系统级等价——FWFT 外加一级接收寄存器,与标准模式加自动预取,延迟和时序预算完全相同,区别只是那一级寄存器划在模块边界里面还是外面。选型问题因此常常不是「选谁」,而是「边界划在哪」。
五、决策点五:almost-full 阈值——给停写令的旅途预留槽位
当时的问题。等 full 拉起再通知上游停写必然溢出:反压通知要穿过两级同步、上游 skid 和在途突发,这段路上的每一拍写端都还在忠实地写入。满标志的正确角色是正常工况永不触碰的最后一道防线,日常反压必须提前。
| 候选方案 | 做法 | 代价 | 失败模式 |
|---|---|---|---|
| 只用 full 反压 | 顶格才通知停写 | 无额外比较器 | 在途写入稳定顶破容量 |
| almost-full 预算阈值(选定) | thresh ≤ DEPTH−N_sync−N_resp−N_burst | 少量容量被保守冻结 | 阈值过小则等效深度缩水 |
| 盲目加深 FIFO | 加大 DEPTH 抬高阈值上限 | RAM 面积线性增长 | 速率长期失衡时只是延后拥塞 |
选型理由。almost-full 阈值设计的扫描实验把预算式逐档坐实:深度 16、上游组合就绪时预算上限是 14,带一级 skid 降到 13;阈值晚一档(15 或 14)即在每个读停窗口溢出,400 拍内各溢出 24 次;而提前量从 1 格加大到 12 格,写气泡从 69 涨到 195、最大占用压到 6,一块深度 16 的 RAM 只用了不到四成。安全与容量的兑换曲线被完整测出来,初版设计从「预算上限再留一到两拍裕量」起步就有了量化依据,而不是凭感觉折半深度。
被弃方案何时翻盘。加深 FIFO 在「常态占用远离阈值、溢出只在最坏突发出现」时是对症的,它买的是突发吸收能力;但若扫描显示常态就顶在阈值附近、气泡数高企,说明两端速率长期失衡,加深只是把拥塞延后,真正该动的是反压环延迟或上游限速。固定阈值在多模式系统里也会翻盘成可配寄存器——skid 级数、突发长度、频率比随配置变化时,阈值必须跟着重算,配上硬件钳位把「宁早勿晚」从约定变成结构保证。
六、决策点六:非对称位宽——把两种宽度降到同一个记账单位
当时的问题。32 位 AXI 侧对接 8 位 UART 链路,一拍写进来的宽字要拆成四次字节读出;反方向则要把零碎字节攒成宽字。指针还能不能直接比较、存储体按谁的宽度组织,是工程包最后放开的约束。
| 候选方案 | 面积 | 残字与相位债务 | 适用边界 |
|---|---|---|---|
| 单 RAM 按窄侧组织加字节使能(选定) | 最省,指针只有一套 | 宽口侧使能译码耦合进核心 | 2 幂比率、方向综合期定死 |
| 双 RAM 加搬运状态机(转换桥) | 面积近翻倍,多一跳延迟 | 残字状态显式、可单独验证 | 非 2 幂比率或方向运行时切换 |
| 系统级统一总线宽度、删掉非对称配置 | 省掉整个变体 | 无 | 宽度差异只是模块拼装产物时 |
选型理由。非对称位宽 FIFO的核心决策只有一条:存储体按窄侧 entry unit 组织,两侧指针在同一个最小单位上记账,occ = wp − rp 的公式形态不变,只是宽口一侧每拍推进 RATIO 格。32→8 时低字节占低地址、小端排布,满判定按「下一拍写需要几个槽」计算,同拍读写坚持先读后写。比率限 2、4、8、16 这类 2 的幂也不是厂商偷懒:非 2 幂要引入相位计数器、N 种字节使能图案和非对齐拼接 MUX,验证成本同步膨胀,Xilinx 与 Altera 的 IP 因此都只支持 2 幂比。
被弃方案何时翻盘。真出现 24:16 这类非 2 幂需求时,单 RAM 方案的相位债务会压垮核心,双 RAM 加独立转换桥把复杂度隔离进可单独验证的小模块,这笔面积就花得值;若评审发现两侧其实都是 32 位、只是中间某级图省事挂了 8 位,最优解是删掉非对称配置统一总线——残字损耗只有在链路协议本身规定字节宽度时才非付不可。
六个决策点复盘完,用一张思维导图把通用的复盘维度收拢:每个决策都可以沿「原始问题、候选集合、选定成本、翻盘条件、验证证据」五条腿重走一遍,后续 SRAM、UART、SPI 模块的设计评审照此列表提问即可。
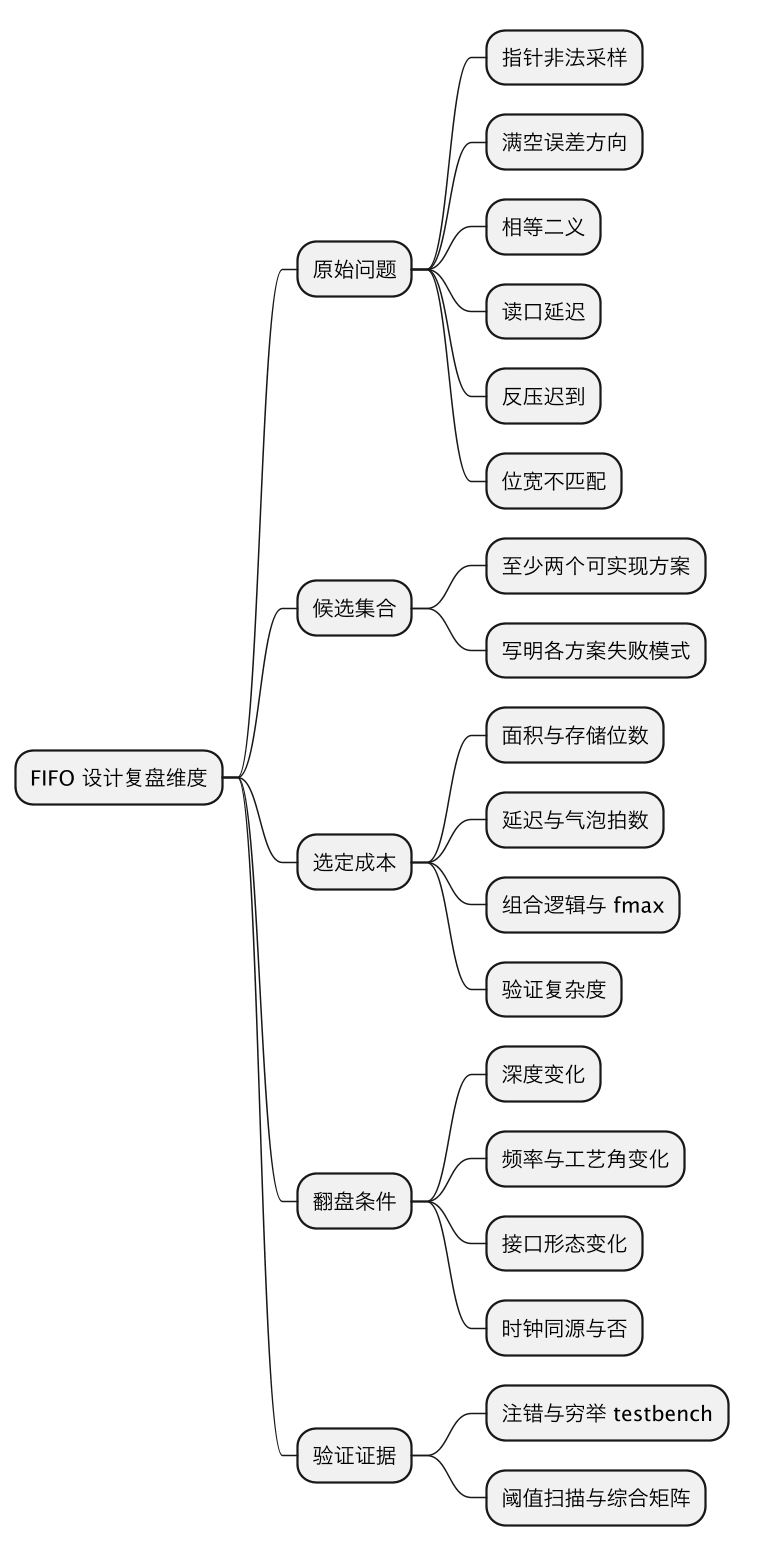
读这张图重点看最右两层的配对方式:每一类「选定成本」都对应一个「翻盘条件」——成本只有在给定约束下才是成本,约束松动时落选方案立刻重新进入候选。这也是本专题反复出现的同一个教训:设计文档里最该写清的不是「选了什么」,而是「在什么条件成立时这个选择不再最优」。
这一篇在知识体系里的位置
本篇是异步 FIFO 专题的收官篇,不生产新机制,只把前七篇的结论按决策链重新组织。编码基线的完整反证在格雷码跨时钟域原理,安全方向的论证与三拍欠账在满空语义与保守延迟,状态空间的枚举实验在指针绕回与扩展位,读口时序在FWFT 与标准读模式,反压预算的扫描数据在almost-full 阈值设计,位宽扩展在非对称位宽 FIFO,可靠性量级在亚稳态与 MTBF;支柱页异步FIFO设计全景给出整条学习路径与工程包导览。这套「备选—代价—翻盘条件」的复盘框架将沿用到后续 SRAM 控制器与串行总线专题。
总结
FIFO 设计复盘的六个决策点共用同一条思路:用一笔确定、可量化的成本,换掉一种不可恢复的风险。格雷码用转换逻辑换掉非法指针,实测 8 次采样全合法;保守满空用三拍滞后与 24/23 个气泡换掉溢出与读空,安全性计数全程为零;扩展位用一个寄存器位换掉满空二义,避开占用计数器 25% 的浅深浪费;FWFT 用旁路 mux 与频率功耗代价换掉一拍读延迟,并与标准模式保持系统级等价;almost 阈值用少量冻结容量换掉停写令旅途上的溢出,预算式在扫描中精确到「晚一档即溢出 24 次」;非对称位宽用窄侧 entry 统一记账换掉外挂拆字逻辑,同时把非 2 幂比率明确划给双 RAM 桥方案。复盘的真正产出不是记住六个结论,而是养成习惯:每个选型都写清落选方案的翻盘条件,因为设计的有效期永远只等于它背后约束的有效期。