UVM 错误注入:协议错误、数据破坏、时序扰动三类注入与覆盖闭环
更新时间:2026-09-29。在 SV force/release 与后门注入 里讲了底层信号怎么被强翻,在 UVM callback 注入机制 里讲了怎么在组件里留钩子,在 SV 场景化随机分层 里讲了正常流量怎么按场景组织。这一篇把三件事拧成一条主线:怎么系统化地往 DUT 里打错误,并且用覆盖率证明每条错误路径真的被踩过。
本文要回答的问题
- 协议错误、数据破坏、时序扰动这三类注入各自打在哪一层,手段有什么区别?
- transaction 级、driver 级、interface 级三个注入点怎么选,注入矩阵怎么设计?
- 注入之后怎么知道 DUT 的错误处理逻辑真的被触发了,而不是错误被静默吞掉?
- error coverage 和普通 functional coverage 有什么区别,覆盖闭环怎么收?
- 错误注入用例的通过率怎么统计,「误报/漏报/正确检出」三类结果怎么分类?
一、为什么正常流量验不出错误路径
一个成熟项目的功能覆盖率报表里,正常读写、地址边界、突发长度这些 bin 很快就能打满,但错误响应、重传、超时恢复、异常中断这些路径常年挂零。原因很直接:约束求解器只生成合法激励。你在 transaction 里写 crc == calc_crc(payload) 这样的隐含约束,或者在 driver 里老老实实按协议时序驱动,错误路径就永远没有输入。
UVM 错误注入要解决的正是这件事:有意打破「合法」假设,让错误真的发生,然后验证 DUT 的检测、报告、恢复三段行为。一次完整的错误注入验证不是「打一个坏包看会不会挂」,而是一个闭环:注入错误 → DUT 检出 → scoreboard 预测错误响应 → 检查恢复后正常流量还能走 → error coverage 记录这条路径已踩。
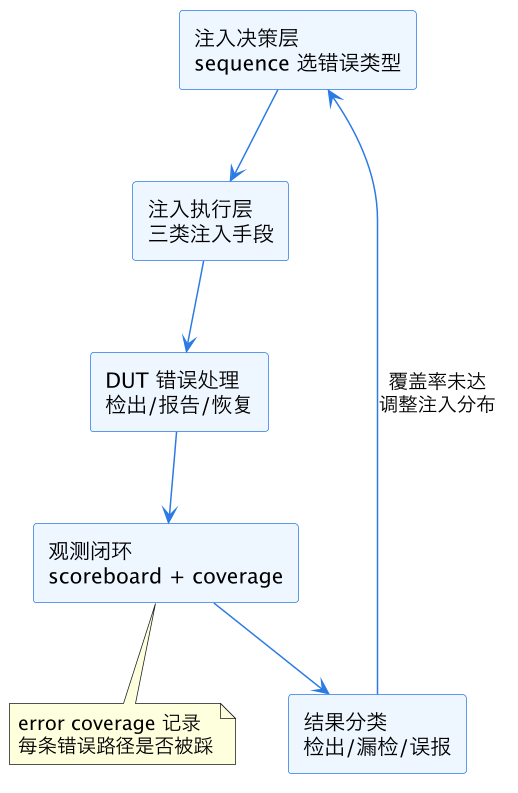
上图是整个错误注入验证的骨架。关键是最后那条回边:覆盖率没打满,就回去调注入分布。没有这个闭环,错误注入就退化成「随机碰运气」。
二、三类错误:打的东西不一样,手段就不一样
把「错误」拆成三类,每类的物理含义、注入层、DUT 期望反应都不同,混在一起打会两头不到岸。
| 错误类别 | 物理含义 | 典型例子 | 注入层 | DUT 期望反应 |
|---|---|---|---|---|
| 协议错误 | 违反协议规则但信号电平合法 | 非法命令码、乱序握手、长度字段超界 | transaction / driver | 协议层丢弃、错误响应、中断上报 |
| 数据破坏 | 数据内容在传输中被翻位 | 奇偶校验错、CRC 错、ECC 单/双位错 | transaction / interface | 校验检出、纠错或上报、可选重传 |
| 时序扰动 | 信号在时间维度上偏离合拍 | valid 晚到 N 拍、ready 中途撤销、超时 | driver / interface | 超时计数、重传、流控恢复、不死锁 |
三类的验证目标也不在一个层面上。协议错误验的是「状态机的健壮性」:收到一个规范里没定义的输入,状态机是走到错误态、报错、然后能回来,还是卡在一个中间态出不来。数据破坏验的是「校验链路的完整性」:从 payload 生成到校验字段计算到接收端比对,这条链上任何一环被翻位都要能检出,漏检一位就意味着线上数据静默损坏。时序扰动验的是「异步边界和流控的鲁棒性」:对端变慢、变快、中途抽风,本端能不能扛住不死锁、不丢数据、不重复收。三类各自对应设计里不同的模块,验证负责人也往往不同,混在一起做只会让 bug 分类和回归统计变成一团乱麻。
协议错误最「干净」:字段值本身合法,组合起来违法。数据破坏要注意「破坏后校验字段要不要重算」——如果你把 payload 翻了位但 CRC 还是按原数据算的,那是正确的注入;如果 CRC 也跟着重算了,错误就被你自己修好了。时序扰动最容易引发灾难:拖拍拖到死锁、ready 撤销时机不对打到亚稳态,所以时序类注入必须有看门狗兜底,仿真挂死要能区分「注入导致的真死锁」(这正是要抓的 bug)和「注入器自己卡住了」。
三、三个注入点:transaction、driver、interface
同一个错误,可以在三个不同的层级注进去。选层的原则是:错误发生在哪层,就尽量在哪层注;层级越低,注入越真实,但可控性和可复用性越差。
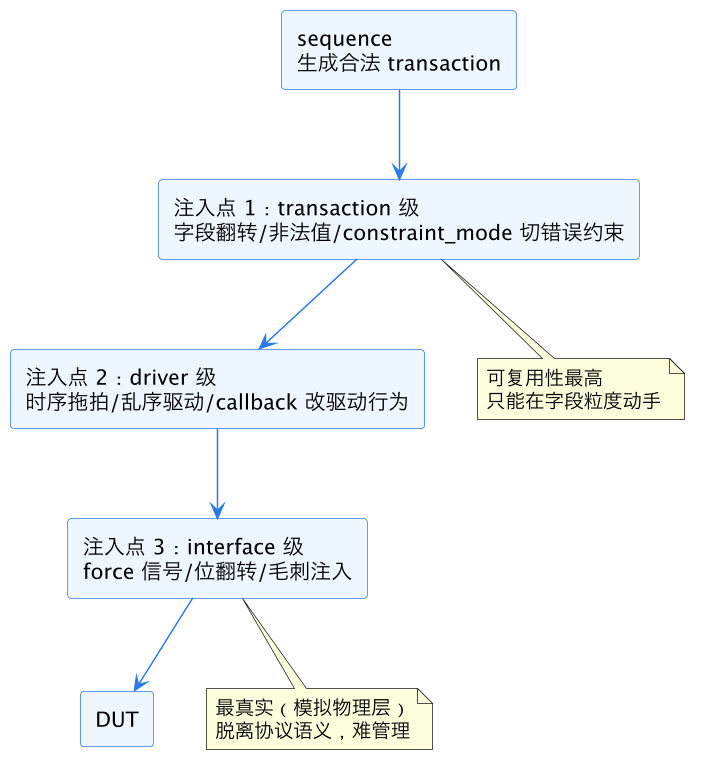
transaction 级注入是首选:在 sequence 里把 parity_err 字段置 1,或者用 SV 随机化回调 里的 constraint_mode 切到错误约束组,求解器直接产出带错的包。好处是完全在 UVM 世界里,错误类型可以枚举、可以加权、可以进 coverage。
class inject_txn extends bus_txn;
  typedef enum {NO_ERR, PARITY_ERR, BAD_CMD, LEN_OVERFLOW} err_t;
  rand err_t err_kind;
  rand bit       parity_err;
  rand bit [7:0] cmd;

  constraint c_err_dist {
    err_kind dist {NO_ERR:=70, PARITY_ERR:=10, BAD_CMD:=10, LEN_OVERFLOW:=10};
  }
  constraint c_parity { parity_err == (err_kind == PARITY_ERR); }
  constraint c_cmd    { (err_kind == BAD_CMD) -> cmd inside {[8'h80:8'hFF]}; }
  constraint c_len    { (err_kind == LEN_OVERFLOW) -> len > MAX_LEN; }
endclass
driver 级注入处理时序扰动。在 driver 的驱动循环里注入拖拍,比改 transaction 自然,因为 transaction 里没有「第几拍拉高 valid」这个概念:
task drive_item(bus_txn tx);
  if (tx.timing_inject) begin
    repeat (tx.delay_cycles) @(posedge vif.clk);  // 时序扰动:晚 N 拍
  end
  vif.valid <= 1'b1;
  // ...
endtask
更工程化的做法是用 UVM callback 注入机制 在 driver 里留 pre_drive/post_drive 钩子,错误注入逻辑写在 callback 子类里,driver 主体保持干净,正常回归不挂 callback 就零开销。
interface 级注入用 force 打信号,适合数据破坏的物理层模拟(比如注入毛刺、翻转正在传输中的某一位)。这层要克制:force 会绕过一切协议语义,错误很难归类,只在 transaction/driver 层表达不了时才用,并且用完立即 release。
// interface 级注入:在数据窗口中间翻转 d[3]
initial begin
  @(posedge vif.clk iff vif.valid);
  #1 force vif.data[3] = ~vif.data[3];
  @(posedge vif.clk);
  release vif.data[3];   // 立即释放,只翻一个采样窗口
end
这段代码的两个细节值得记住。一是 force 的持续时间被精确控制在一个采样窗口内——翻完即 release,避免把「单位错误」变成「总线挂死」;二是它写在 interface 或 bind 进去的模块里,而不是 sequence 里,因为 sequence 拿不到逐拍信号时序的细粒度控制。force 的具体语法和释放时机在 SV force/release 与后门注入 里有完整展开。
四、注入点矩阵:错误类型 × 注入层
把三类错误和三个注入层交叉,得到一张注入点矩阵。不是每个格子都要填,但设计验证计划时应该过一遍每个格子,写明「打/不打/为什么不打」。
| 错误类别 \ 注入层 | transaction 级 | driver 级 | interface 级 |
|---|---|---|---|
| 协议错误 | 非法字段值、错误约束组(首选) | 乱序驱动、提前/延后握手 | 一般不用 |
| 数据破坏 | 校验字段不动、payload 翻位(首选) | 驱动时翻转总线某一位 | force 翻位、毛刺 |
| 时序扰动 | 表达不了(无时间概念) | 拖拍、撤销、超时(首选) | force 拉死信号(慎用) |
矩阵的价值在 review 时显形。常见缺口是「时序扰动 × transaction 级」被误填——有工程师在 transaction 里加 delay 字段指望它生效,但 driver 根本没读这个字段,注入静默失效,coverage 里时序类 bin 永远为零却没人发现。matrix 里每个格子都要能指出对应的注入代码在哪一行。
矩阵还有一个用法是排优先级。项目早期资源有限,九个格子不可能同时开工。一般的顺序是:先打「协议错误 × transaction 级」,成本最低、见效最快,一周就能铺开;再打「数据破坏 × transaction 级」,把校验链路验穿;时序扰动放到中后期,因为它依赖稳定的 driver 和看门狗基建,基建不稳时打时序注入只会收获一堆仿真挂死。interface 级的两个格子通常只在有明确物理层风险(比如跨时钟域、外部 SERDES 对接)时才立项。
五、观测闭环:错误不能被静默吞掉
注入只是半边。另外半边是证明 DUT 看见了错误,并且反应正确。这需要一个和正常 scoreboard 平行的错误观测通道。
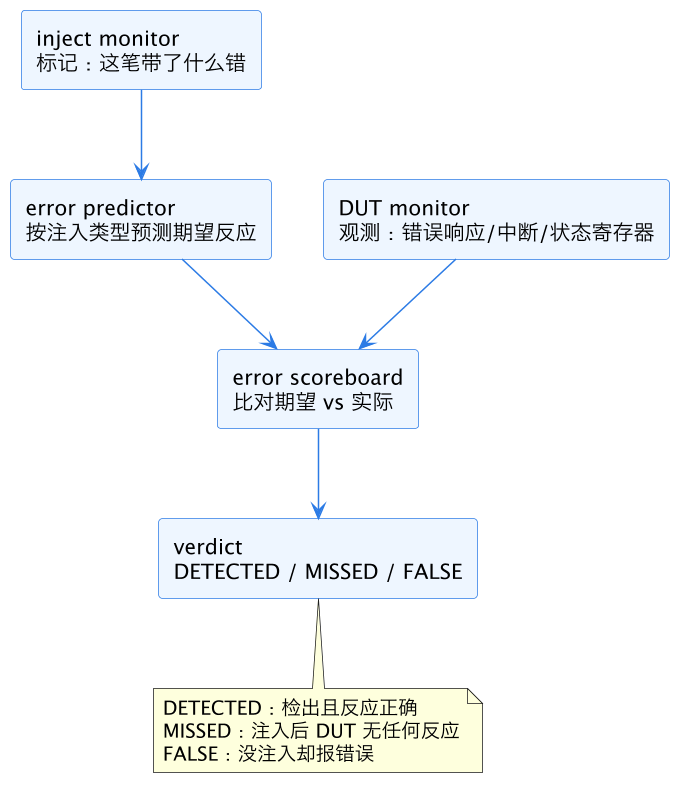
三种判决里,MISSED 是最危险的结果:错误注进去了,DUT 毫无反应,既可能是设计漏检(真 bug),也可能是注入没生效(验证 bug),必须逐个分类定位,不能一删了之。FALSE(误报) 同样有价值——没打错误却报错误中断,说明错误检测逻辑过于敏感或者状态机串扰。
判定时序上还有一个工程细节:错误响应不是同一拍就到的。注入了 CRC 错,DUT 可能要几拍之后才拉中断、再几拍之后才更新状态寄存器。所以 error scoreboard 的比较必须带「观察窗口」——从注入完成时刻起开一个 N 拍的窗口,窗口内出现期望反应算 DETECTED,窗口关闭还没出现才算 MISSED。窗口长度按设计的最坏响应延迟来定,定太短会批量误报 MISSED,定太长会把「本不该有的延迟反应」也算成检出,掩盖性能类 bug。窗口本身也值得进 coverage:把「响应延迟拍数」做成一个 coverpoint 分 bin,能顺带验证 DUT 的错误响应时延指标。
实现上有两个工程要点。第一,注入信息要随 transaction 流动:给 transaction 加 err_kind 字段,`uvm_field 宏或 do_copy 里带着走,monitor 端能拿到「这笔本来带什么错」。第二,error scoreboard 的比较策略和正常 scoreboard 不同——正常比分对数据逐字节比,错误比分对「反应类别」比:期望中断,实际来了中断就算过,不要求逐周期对齐。
六、error coverage:把「验过」变成可量化
普通 functional coverage 回答「功能点踩过没有」,error coverage 回答「错误路径踩过没有、每种错误的 DUT 反应是哪一类」。两者要分开建 covergroup,否则正常 bin 的庞大基数会把错误 bin 的权重稀释掉。
covergroup cg_error @(sample_ev);
  cp_kind   : coverpoint err_kind {
    bins parity = {PARITY_ERR};
    bins badcmd = {BAD_CMD};
    bins lenovf = {LEN_OVERFLOW};
    bins timing = {TIMING_ERR};
  }
  cp_verdict: coverpoint verdict {
    bins detected = {DETECTED};
    bins missed   = {MISSED};
    illegal_bins false_alarm = {FALSE};  // 出现即失败
  }
  cx: cross cp_kind, cp_verdict {
    illegal_bins no_miss = binsof(cp_verdict.missed);
  }
endgroup
这个 covergroup 的设计意图值得展开。cx 交叉里把 missed 列为 illegal_bins——不是不统计,而是「每出现一次就是一个待查项」,仿真结束时 illegal bin 命中数 >0 直接让用例失败。verdict 里的 false_alarm 同理。这就是「覆盖闭环」的落点:覆盖率不只是报表上的百分比,还反向定义了用例的通过标准。
收尾阶段看 cp_kind 的覆盖率缺口调整 c_err_dist 里的权重——parity 打满了就把权重压下去,lenovf 还差就把权重抬上来。这套动态调权和 SV 随机化回调 里讲的 constraint_mode 切换是同一套机制。
回归层面的组织也有一个经验做法:错误注入用例单独成一个 regression suite,不和正常功能用例混跑。原因有两个。一是错误用例的通过标准不同——正常用例要求零 error 零 fatal,错误用例恰恰期望 DUT 报 error,混跑之后日志里的 UVM_ERROR 计数失去意义,得靠 UVM report catcher 这类机制把「预期的 DUT 报错」demote 成 INFO,只留「意外的 TB 报错」作为失败判据。二是错误用例的运行时长分布不同——带恢复验证的错误用例普遍偏长,混跑会拖慢正常回归的失败定位速度。分开跑,两套通过标准、两套覆盖率报表,最后在手签(sign-off)阶段合并成一张矩阵:行是错误类型,列是「注入次数/检出率/恢复成功率/覆盖命中」,哪个格子不达标一目了然。
七、组合实战与常见坑
一个完整的错误注入 sequence 长这样:
task body();
  inject_txn tx;
  repeat (num) begin
    tx = inject_txn::type_id::create("tx");
    if (!tx.randomize()) `uvm_fatal("RAND", "unsolvable")
    start_item(tx);
    finish_item(tx);
    // 注入后补 N 笔正常流量,验证恢复能力
    if (tx.err_kind != inject_txn::NO_ERR) begin
      repeat (2) send_normal_txn();
    end
  end
endtask
注意注入后补正常流量这个细节——很多错误处理 bug 不在检出瞬间暴露,而在「检出之后第一笔正常交易」上翻车:状态机没复位、计数器没清零、信用没归还。只打错误不打恢复,等于只验了一半。
常见坑集中在这几个:
- 注入静默失效:transaction 里加了错误字段,driver 没消费,错误根本没到 DUT。用 error coverage 的 kind bin 命中数对账,bin 有命中但 DUT 侧零反应,先查注入路径再查设计。
- 错误被自己修好:翻转 payload 后 post_randomize 里又重算了 CRC,破坏被抹平。校验类字段要用
rand_mode(0)冻结或显式跳过。 - 时序注入无看门狗:拖拍拖出死锁,仿真挂死分不清是设计死锁还是注入器卡死。每个时序注入用例配一个超时 watchdog,超时即报 MISSED 候选。
- 恢复路径不验:错误检出中断来了就算过,不验证后续正常流量,漏掉一整类恢复 bug。
- 错误权重一刀切:四种错误各 25%,常见错误早早打满、稀有错误永远不够。按覆盖率缺口动态调权。
这一篇在知识体系里的位置
- 底层手段:SV force/release 与后门注入 提供 interface 级注入的信号操作原语,本篇回答「什么时候该下到这个层」。
- 机制支撑:UVM callback 注入机制 讲 driver/monitor 里怎么留钩子,本篇的 driver 级注入就挂在这些钩子上。
- 正常流量对照:SV 场景化随机分层 组织合法激励,本篇是它的镜像——把「合法假设」逐条打破并验证后果。
- 随机化控制:SV 随机化回调 的
constraint_mode切换是错误约束组动态启停的直接工具。
总结
UVM 错误注入是一套闭环打法:按协议错误、数据破坏、时序扰动三类拆问题,用「错误类型 × 注入层」矩阵定注入点——transaction 级管字段、driver 级管时序、interface 级 force 兜底;注入侧用 constraint_mode 切错误约束组控制分布,观测侧用 error predictor + error scoreboard 把结果分成检出/漏检/误报三类,error coverage 的交叉 bin 把漏检和误报列为 illegal 直接挂钩用例通过标准,最后按覆盖缺口回调注入权重,直到每条错误路径都有「注入—检出—恢复」的完整证据。