UCIS 覆盖率合并:多回归数据库的合并、去重与跨工具交换流程
更新时间:2026-10-07。一次完整回归动辄跑出几百上千个测试用例,每个用例各自落一份覆盖率数据库——真正决定项目能不能收敛的,不是单个用例打了多少点,而是这些数据库能不能干净地合并成一份「总账」。业界的通用交换格式是 UCIS(Unified Coverage Interoperability Standard,统一覆盖率互操作标准),Accellera 制定的覆盖率数据库标准,Synopsys、Cadence、Siemens 三家仿真器都能读写。UCIS 覆盖率合并就是围绕这份标准数据库做「多份进、一份出」的工序:合并策略定错,数字会虚高或莫名丢失,签核时对不上账。本篇是 chip-design/verification 目录的 S 层标准篇,覆盖率的入门概念见 代码覆盖率与功能覆盖率,合并后的排除项管理见 覆盖率合并与排除流程。
本文要回答的问题
- UCIS 数据库里到底存了什么,为什么它能跨工具交换?
- UCIS 覆盖率合并时,同名实例、层次路径不一致会怎样去重和对齐?
- 多回归合并的命令行和典型流程长什么样?
- 合并中哪些坑会让覆盖率数字虚高或凭空消失?
- 跨工具交换(仿真器到形式验证、到第三方看板)要注意什么?
一、UCIS 数据库里存的是什么
把 UCIS 想成一棵带类型标签的树。树有三层骨干:最顶是 scope(作用域),对应设计层次和测试计划节点,比如 tb.dut.u_spi.rx_fifo;scope 下面挂 coveritem(覆盖项),分几大类——covergroup 的 bin、代码覆盖率的语句/分支/条件/FSM 状态、断言的 cover 记录;每个 coveritem 带一个或多个 count(计数),即这个点被命中多少次,外加 at_least、weight 这些从 covergroup 选项继承下来的属性。
关键细节在于:每个 coveritem 的「身份」不是它的名字字符串,而是它在层次树里的完整路径加上类型标签。合并器对齐两份数据库时靠的就是这套身份。同一个 bin 在数据库 A 里命中 3 次、在数据库 B 里命中 5 次,合并结果就是 8 次;路径对不上的项,合并器要么按孤立项保留、要么直接报 warning 丢弃,取决于工具选项。
另一个容易忽略的点:UCIS 还会记录 test record(测试记录)——每条回归用例的名字、运行时间、种子、编译参数。合并后的总库里能看到「这个 bin 是被哪些用例打中的」,这是后面做 覆盖率驱动用例分流 的数据基础。所以合并时不要随手关掉 test tracking 选项,省了几十 MB 磁盘,丢的是追溯能力。
二、合并的语义:去重、对齐与计数累加
UCIS 覆盖率合并的核心语义只有一句话:路径和类型相同的覆盖项计数相加,不同的项并集保留。但工程上远没有一句话这么干净,三种典型冲突各有处理规矩。
第一种是编译快照不一致。同一份 RTL,两次回归用了不同的 +define 或参数例化,同一路径下 coveritem 的个数都对不上。这时候强行合并,对齐不上的项会被各算各的,覆盖率数字被「平均」拉低。正确姿势是:只合并同一次 elaboration(编译展开)跑出来的库,或者让工具生成一份「合并用的参考库」(merge reference),所有回归统一对它合并。
第二种是实例路径漂移。UVM 环境里常见 uvm_test_top.env.agent.monitor.cg 这类路径,如果 testbench 做了条件例化(if (CFG_HAS_X)),不同配置的回归库路径深度就不同。合并器按字符串前缀对不上就各留一份,同一个 covergroup 被打中的次数拆到两条路径下,at_least 永远凑不齐。解法是 covergroup 用 option.per_instance 时明确 get_inst_name 的稳定性,或在合并时用工具的路径映射/剥离选项(Synopsys URG 的 -map、Cadence IMC 的 -refinement)把路径归一。
第三种是测试计划与验证数据的错位。测试计划节点是另一棵树,合并时如果计划版本变了(加了一个 feature 节点),旧数据挂不到新节点上,报告里会出现「无数据节点」,把整体覆盖率往下拽。测试计划的链接方法见 测试计划与覆盖率映射,原则是计划改版本要冻结基线、增量合并。
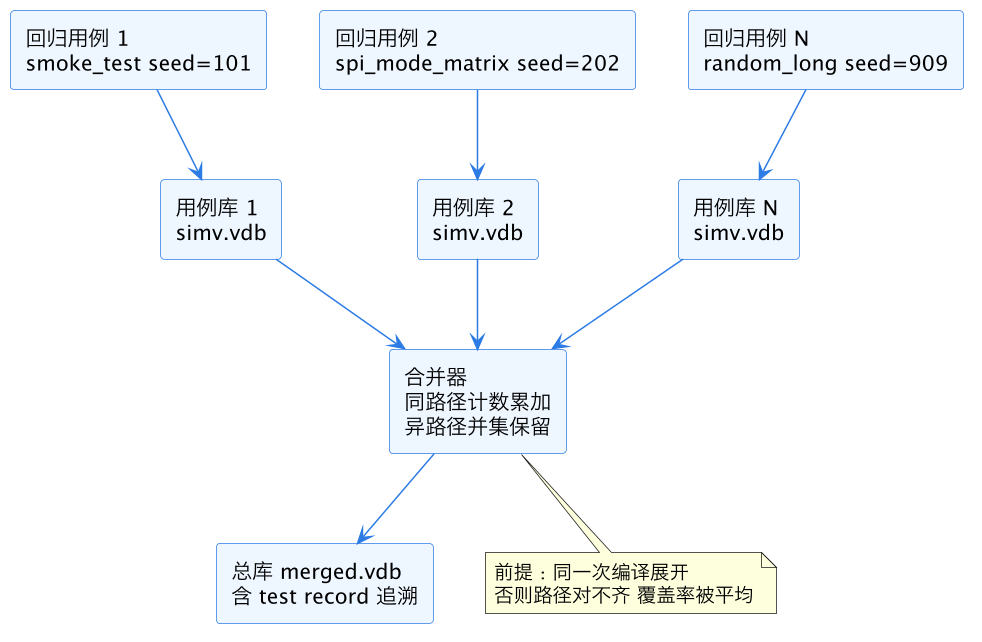
上图是多回归合并的数据流:每个用例独立落库,合并器按路径身份对齐后累加计数,产出带测试记录的总库。图里最重的一条约束写在底部——「同一次编译展开」是所有输入库的共同前提,违反它,后面所有数字都不可信。
三、命令行实操:三家工具的最小可用流程
合并动作本身各家都是一条命令,差别在选项语义。下面给三家主流工具的最小可用写法。
Synopsys VCS 流程:仿真时 -cm line+cond+fsm+tgl+branch+assert 落 simv.vdb,合并与出报告用 URG(Unified Report Generator):
urg -dir regress/run_*/simv.vdb \
    -dbname merged/merged.vdb \
    -report reports/urg \
    -format both
URG 默认就做「同路径累加、异路径并集」,-map 可以加模块映射处理层次差异,-elfile 挂排除文件。
Cadence Xcelium 流程:-coverage all 落 cov_work/scope/<test>,合并用 IMC(Incisive Metrics Center)的命令行:
imc -exec merge.tcl
# merge.tcl 内容:
# merge cov_work/scope/* -out merged_cov
# load merged_cov; report -html reports/imc
Siemens Questa 流程:vsim -coverage 落 .ucdb 文件(UCDB 是 Questa 对 UCIS 的实现名),合并:
vcover merge -out merged.ucdb regress/run_*/*.ucdb
vcover report -html -output reports merged.ucdb三家命令的共同点值得记住:合并和出报告是两个动作,先把库合并落盘,再从总库出报告。很多新手跳过落盘直接看报告,结果想加排除项、想做增量合并时没有中间产物可用。
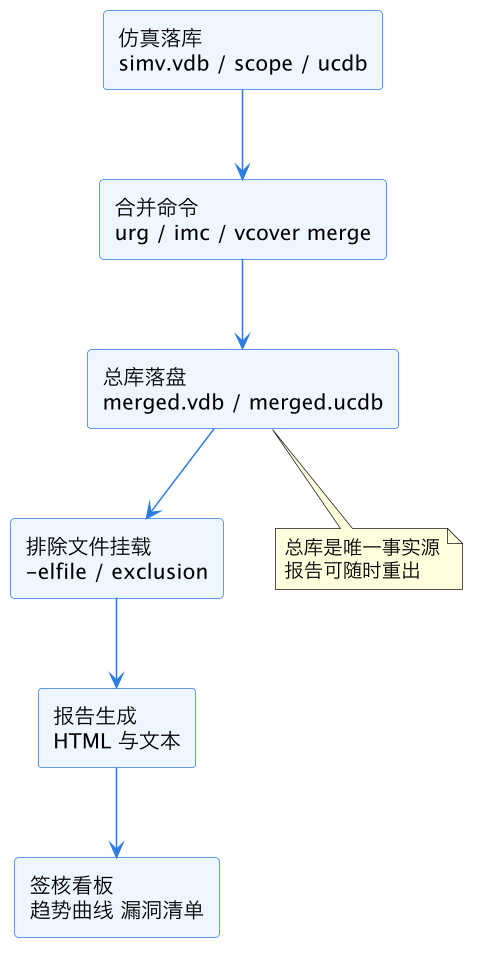
上图是合并工序在流水线里的位置:总库落盘是分水岭,排除、报告、看板都从总库派生。团队里应该立一条规矩——任何人看到的覆盖率数字都必须能从某个具名总库复现,否则就是手工拼出来的假账。
四、合并规模的工程策略:分层合并与增量合并
用例数上几百之后,「一把梭」合并会撞两堵墙:内存墙(几百个 vdb 一起进 URG,几十 GB 内存起步)和时间墙(全量合并动辄半小时以上,夜间回归等不起)。实战里有三种策略,按项目规模选。
| 策略 | 做法 | 适用规模 | 代价 |
|---|---|---|---|
| 一把梭 | 全部库一次 merge | 用例 < 100 | 简单直接,无中间账 |
| 分层合并 | 按 IP/套件先局部合并,再总合并 | 用例 100-1000 | 中间库要命名规范,出错要会定位 |
| 增量合并 | 每夜只合并新增用例库,叠加到基线总库 | 持续回归的项目 | 基线库损坏影响面大,要做快照 |
分层合并的层次怎么切,照着回归套件切最自然:每个 testplan 大特性一个局部库(spi_merged、i2c_merged……),顶层再做一次 merge spi_merged i2c_merged ...。出问题能二分定位——总库数字不对,先看哪个局部库不对,再看该局部库下哪个用例库异常,比从 800 个用例里大海捞针快一个数量级。
增量合并有一条铁律:RTL 或 testbench 一变,基线作废。增量只省「同一编译快照下的新用例」,编译快照换了还往旧基线上叠,就是前面说的快照不一致冲突。所以增量基线必须和编译产物(simv、elab 目录)绑版本号,基线目录里放一个 BASELINE_META 文件记录编译哈希,合并脚本先比对再动手。回归调度层面的事(哪台机器跑、失败怎么分桶)见 LSF 网格回归 和 回归失败分桶。
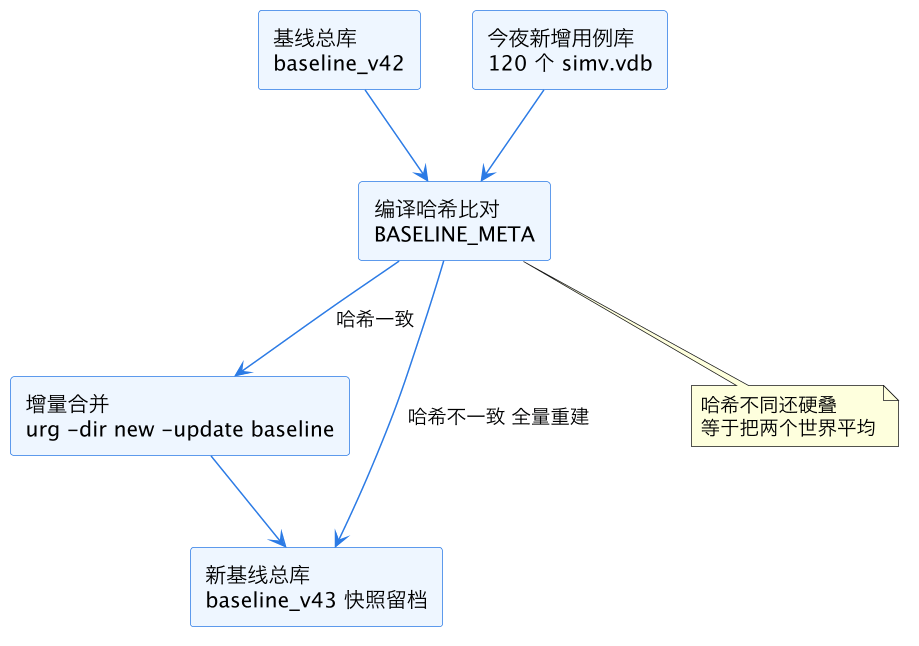
上图是增量合并的守门逻辑:哈希一致走增量,不一致必须全量重建。这个分支判断写进脚本而不是靠人记——人工记一次漏判,后面一周的趋势曲线都是假数据,而且很难追溯是哪一夜开始错的。
五、跨工具交换:UCIS 的本职工作与它的边界
UCIS 这个标准存在的首要意义就是跨工具:仿真器出的覆盖率,形式验证工具(如 VC Formal、JasperGold)能往里写「已被证明不可达」的标注;第三方覆盖率看板(如验证管理平台的趋势页)能统一读三家的库;甚至 RTL 冻结后,后端时序 sign-off 工具想引用断言覆盖率,也能从 UCIS 里取。
跨工具交换落地有三步。第一,确认双方工具都声明支持同一版本的 UCIS API(目前主流是 UCIS 1.0,Accellera 官网有标准文档);第二,导出时选「规范化路径」,把工具私有的路径前缀剥掉,否则另一家读出来全是对不上的孤立项;第三,形式工具的不可达标注交换回来以后,要在仿真侧的排除流程里登记,走 覆盖率合并与排除流程 的评审——「形式证明了不可达」不等于「可以默默排除」,评审记录要留痕。
也要知道边界。UCIS 标准管的是数据库结构和 API,不管各工具对覆盖率语义的细微定义差异:同一个条件覆盖率表达式,VCS 的 condition 覆盖和 Questa 的 condition 覆盖在真值表拆分上并不完全一致,跨工具合并语义级覆盖率会得到「两边的并集」而不是「同一标准下的真相」。所以跨工具交换最适合的场景是迁移与汇总(换仿真器时带历史数据走、多工具数据进同一看板),不适合的场景是语义对账(拿 A 工具的数字去否定 B 工具的数字)。验证管理的方法论框架见 回归管理方法论,签核阶段的覆盖率口径统一见 UVM 覆盖率收敛签核。
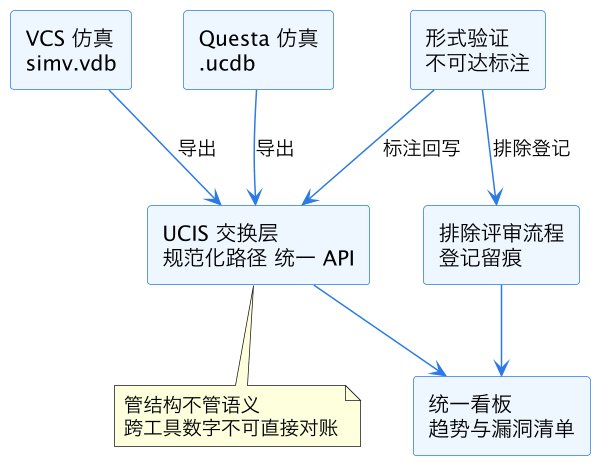
上图是跨工具交换的全景:三家来源经 UCIS 交换层汇入统一看板,形式工具的不可达标注还要走排除评审闭环。图底部的提醒再强调一遍——UCIS 统一的是容器,不是口径。
还有一类隐性成本容易被低估:磁盘与目录治理。每个用例库从几十 MB 到几百 MB 不等,800 条用例一轮就是上百 GB,如果回归系统不做「合并完成后按策略清理用例库」的钩子,NAS 两周就撑爆。常见做法是分级保留:通过用例的原始库保留 7 天(够追溯就行),失败用例的库连波形一起保留到问题闭环,总库与基线库永久保留并做异地快照。目录命名也要机械化——regress/<日期>_<编译哈希>/<用例名>_<种子>/simv.vdb 这个层级一旦定下来就写进回归框架,任何手工建目录的合并入口都会在三个月后变成谁也说不清来源的孤儿库。覆盖率数据是项目的资产,资产治理和合并算法同等重要。
六、合并质量的自检清单
合并做完别急着看总数,先过一遍自检。一看输入用例数:报告头部的 test 列表条数是否等于回归实际跑过的用例数,少了就是有用例库没落盘或路径没收全。二看warning 日志:URG 的 urgReport 目录、Questa 的合并日志里,「scope not found」「type mismatch」这类 warning 出现即有病,数字再好看也要先清零。三看趋势连续性:和昨天总库比,覆盖率的跳变有没有回归侧的解释(新用例上线、排除项变更),无缘无故跳 2 个点以上必查。四看追溯能力:随机挑三个命中 bin,能否反查到具体用例名和种子;查不到说明 test record 被关了,重开再合。这四条过一遍只要十分钟,挡住的是签核前夜才发现总库是假账的大事故。
这一篇在知识体系里的位置
本篇是 chip-design/verification 目录的一篇 S 层标准篇,主关键词 UCIS 覆盖率合并。它向上承接 代码覆盖率与功能覆盖率 的基础概念与 covergroup 采样时机 的数据产生侧;横向与 覆盖率合并与排除流程(合并后的排除管理)、测试计划与覆盖率映射(计划树对齐)、功能覆盖率收敛计划(用合并数据驱动收敛)同属覆盖率数据流一族;下游签核口径见 UVM 覆盖率收敛签核,回归侧基础设施见 LSF 网格回归。
总结
UCIS 覆盖率合并的本质是「按路径身份对齐、计数累加、异项并集」,但工程上能不能合出可信数字取决于三条纪律:所有输入库必须出自同一次编译展开(快照不一致宁可重建基线)、合并和出报告分两步走且总库落盘留档(任何数字都能从具名总库复现)、跨工具交换只用于迁移与汇总而非语义对账(UCIS 统一容器不统一口径);规模上分小项目一把梭、中项目分层合并、持续回归走增量合并加编译哈希守门——合并器只是把数据搬对位置,真正让覆盖率数字可信的,是这套流程纪律。