Hopper TMA wgmma:异步块拷贝与 warp group 协同的新流水范式
更新时间:2026-10-04。前面 FlashAttention 3 的 Hopper FP8 attention 从应用侧讲过 FA3 怎么把 H100 的硬件特性榨干:FP8 tensor core 吞吐翻倍、softmax 与 GEMM 交叠。那篇的结论是「FA3 快,因为它建立在 Hopper 的新异步原语上」,但原语本身只露了一面。本篇把镜头压到底层:TMA(Tensor Memory Accelerator)的异步块拷贝和 wgmma(warp group matrix multiply-accumulate)这一对组合,是怎么取代 Ampere 时代「cp.async 加 ldmatrix 加 mma.sync」老三样的,以及中间那根叫 mbarrier 的「对账绳」怎么把生产和消费串成一条不空转的流水。读懂这一篇,再看 CUTLASS 3.x 的 Hopper kernel 或者 FA3 源码,满屏的
cp.async.bulk.tensor和wgmma.mma_async就不再是天书。
本文要回答的问题
- Ampere 的异步流水(cp.async 加 mma.sync)瓶颈在哪里,为什么 Hopper 要另起炉灶?
- TMA 到底是什么:一条指令怎么搬走一个多维 tile,描述符(descriptor)里装了什么?
- wgmma 为什么把「32 线程的 warp」升级成「128 线程的 warp group」,寄存器账怎么变?
- mbarrier 在 TMA 与 wgmma 之间怎么对账,生产者-消费者流水怎么搭?
- 这套新范式相对 Ampere 流水,编程模型和性能上限各自变了什么?
一、Ampere 流水的天花板:数据搬运和地址计算全压在 SM 线程上
先看旧世界。Ampere(A100)时代的 GEMM 主循环是一条三级流水:全局内存到共享内存用 cp.async(异步拷贝,不占用寄存器做中转),共享内存到寄存器用 ldmatrix(一次搬一个 8×8 的矩阵片段,布局直接匹配 tensor core 胃口),算用 mma.sync。三级之间靠 cp.async.commit_group 和 wait_group 做软流水,让下一轮的拷贝与这一轮的计算重叠。这套东西在 CUDA stream 异步拷贝 讲的「拷贝与计算重叠」思想上是往前迈了一大步:拷贝不再走 DMA 引擎那一套粗粒度机制,而是每线程发一条拷贝指令,粒度细到 16 字节。
但这条流水有三个结构性开销,越接近 tensor core 的算力上限越刺眼。
第一,地址计算烧线程。cp.async 是每线程一条指令,每条指令搬 4、8 或 16 字节。一个 128×128 的 FP16 tile 有 32KB,拆成 16 字节一条就是 2048 条拷贝指令,每条都要算全局地址、算共享内存 swizzle(防 bank conflict 的地址打乱)后的偏移。这些整数运算和 tensor core 抢同一批发射槽(issue slot)。A100 上 tensor core 还算「慢」,这个开销藏得住;H100 的 tensor core 吞吐是 A100 的数倍,地址算术直接变成流水里的瓶颈项。
第二,ldmatrix 又是一轮重复劳动。数据到了 shared memory 不算完,还要 128 个线程(4 个 warp)每人发若干条 ldmatrix 把片段搬进寄存器,再喂给 mma.sync。一次搬运两次经手:GMEM→SMEM 一次,SMEM→RF(寄存器堆)一次,第二次纯粹是软件负担。
第三,mma.sync 的 tile 太小。mma.sync.m16n8k16 一条指令只算 16×8×16 的一小块,想打满 tensor core 需要极高的指令发射密度,主循环被指令发射带宽而不是算力卡脖子。

上图里两个橙色节点就是 Ampere 流水的「税」:数据每走一段都要通用线程陪着跑。NVIDIA 在 Hopper 白皮书里给过一个直白的数据:在 A100 上按峰值算力喂 tensor core,地址生成加数据重排的整数指令能占到 SM 发射带宽的三成以上。H100 的思路是把这些税一次性收走:搬运交给专用硬件单元 TMA,计算交给一条顶过去几十条的 wgmma,线程只负责发号施令和对账。
二、TMA:一条指令搬一个多维 tile,描述符是全部情报
TMA(Tensor Memory Accelerator,张量内存加速器)是 Hopper 在 SM 里新增的专用拷贝引擎。它和 cp.async 的区别不是「快一点」,而是抽象层级整个抬高:cp.async 是「把这个 16 字节从地址 X 搬到地址 Y」,TMA 是「把这个张量的第 (i,j) 个 128×128 tile 搬进 shared memory,怎么切片、怎么越界处理、怎么 swizzle,你自己看描述符」。
情报全在描述符(tensor map descriptor)里。这是一个 128 字节的不透明对象,host 侧用 cuTensorMapEncodeTiled 构建(或者在 device 侧用 PTX 现场拼装),里面写清了:
- 张量的全局地址、维度数(1 到 5 维)、每一维的 size 和 stride;
- tile 的形状(box),即每次拷贝搬多大一块;
- 元素类型与 interleave 布局;
- shared memory 侧的 swizzle 模式(32B、64B、128B 三档,直接告诉硬件落地时怎么打乱避免 bank conflict);
- 越界(out-of-bounds)策略:补零还是钳位。
有了这个对象,设备侧发起拷贝只需要一条指令:cp.async.bulk.tensor.2d.shared::cluster.global.mbarrier,操作数就是描述符、tile 坐标、目标 shared memory 地址和一个 mbarrier 地址。一条指令,一个线程发,搬走 32KB,期间这个线程可以去干别的。 和 Ampere 的 2048 条 cp.async 比,指令发射开销降了三个数量级。

注意图里 TMA 引擎的另一个出口连着 mbarrier——这不是装饰,是整条流水的对账机制,第四节展开。这里先记住描述符的工程含义:「怎么搬」在 kernel 启动前一次说清,主循环里只剩「搬哪块」。越界补零由硬件做,意味着 GEMM 的边界 tile 不再需要单独写慢速路径,主循环一个模板打天下——这是 CUTLASS 3.x 里 Hopper GEMM 代码比 Ampere 版反而更短的原因之一。
TMA 还有一个 Ampere 完全做不到的本事:cluster 级搬运。Hopper 引入了 thread block cluster(线程块簇,最多 8 或 16 个 block 绑成一组,shared memory 互通),TMA 一条指令可以把一个 tile 广播(multicast)到 cluster 内多个 block 的 shared memory,同一份数据只从 L2 读一次。大 GEMM 里相邻 block 往往要同一块 B 矩阵的行,multicast 把 L2 带宽需求直接砍半,这是 H100 大形状 GEMM 能打到 90% 以上 tensor core 利用率的关键之一。
三、wgmma:128 线程一条指令,A 操作数可以赖在 shared memory 不走
拷贝侧革命了,计算侧也得跟上,不然新水管配旧水龙头。wgmma(warp group matrix multiply-accumulate)就是新水龙头。名字里每个词都有含义:warp group 是 4 个连续 warp 组成的 128 线程组,指令以整个组为单位发射和同步;matrix multiply-accumulate 不变,但 tile 尺寸大了一个量级——典型的 wgmma.mma_async.sync.aligned.m64n128k16.f32.f16.f16,一条指令算 64×128×16,对比 Ampere mma.sync 的 16×8×16,指令数降到原来的几十分之一,发射压力基本消失。
更革命的是操作数来源。mma.sync 要求 A、B 两个操作数都躺在寄存器里,所以才需要 ldmatrix 那一轮搬运。wgmma 的规则是:B 操作数可以直接以描述符形式指向 shared memory,A 操作数也可以(也可以放寄存器),累加器 C 放寄存器。也就是说 TMA 搬进 shared memory 的 tile,wgmma 能直接「就着锅吃」,SMEM→RF 这一整轮软件搬运被硬件吞掉了。Ampere 流水里的 ldmatrix 环节在 Hopper 主循环里整体消失。

wgmma 还是真异步的:指令名字里带 mma_async,发射后立刻返回,128 线程组不阻塞,靠 wgmma.commit_group 和 wgmma.wait_group<N> 收账——「等只剩 N 组未完成」的语义和 cp.async 的 wait_group 一脉相承,老 CUDA 程序员会有即视感。这个异步性是 FA3 那篇讲的「softmax 与 GEMM 交叠」的地基:一组 wgmma 在 tensor core 上跑的时候,同一批线程可以在 CUDA core 上算 softmax、做 rescale,两条硬件流水线各跑各的。
寄存器账也要重新算。128 线程的 warp group 里,一个 64×128 的 FP32 累加器摊到每线程是 64 个寄存器;Ampere 一个 warp 持有 16×8 的 C 片段,每线程只有 4 个累加寄存器。wgmma 把 C 的持有成本集中到了寄存器堆里,一个 warp group 的寄存器预算(每 SM 65536 个,128 线程人均 512 上限但实际要留给 A 操作数和寻址)决定了能同时开几组流水。这也是为什么 Hopper kernel 普遍走 warp specialization 流水线:一部分 warp group 专职当生产者发 TMA,一部分专职当消费者发 wgmma,消费者组把寄存器配额吃满留给累加器,生产者组只要少量寄存器管地址和 barrier——每 SM 的寄存器甚至可以在两组之间做不对称重分配(setmaxnreg 指令),这在 Ampere 上不存在。
四、mbarrier:TMA 和 wgmma 之间的对账绳
生产者和消费者都是异步的,中间必须有「货到了没有」的判定机制,这就是 mbarrier(memory barrier 对象,shared memory 里的一个 8 字节同步原语)。它比 Ampere 的 cp.async.wait_group 强在两点:它能数字节,它能让任意线程等待任意完成事件。
数字节靠的是 mbarrier.arrive.expect_tx(expect transaction)机制。流程是:生产者发起 TMA 拷贝前,先对 mbarrier 做 expect_tx,声明「我接下来有 32KB 数据要经你入账」;TMA 引擎搬完数据,自动对该 mbarrier 做 transaction 记账,字节数凑齐了 barrier 就算到达(arrive)。消费者线程 mbarrier.try_wait 轮询相位(phase),相位翻转即「本 stage 的数据齐了」。于是**「拷贝完成」这个事件第一次有了精确的硬件表达**——不再是「某个线程组的 wait_group 返回」这种模糊信号,而是共享内存里一个任何线程都能查的账本。
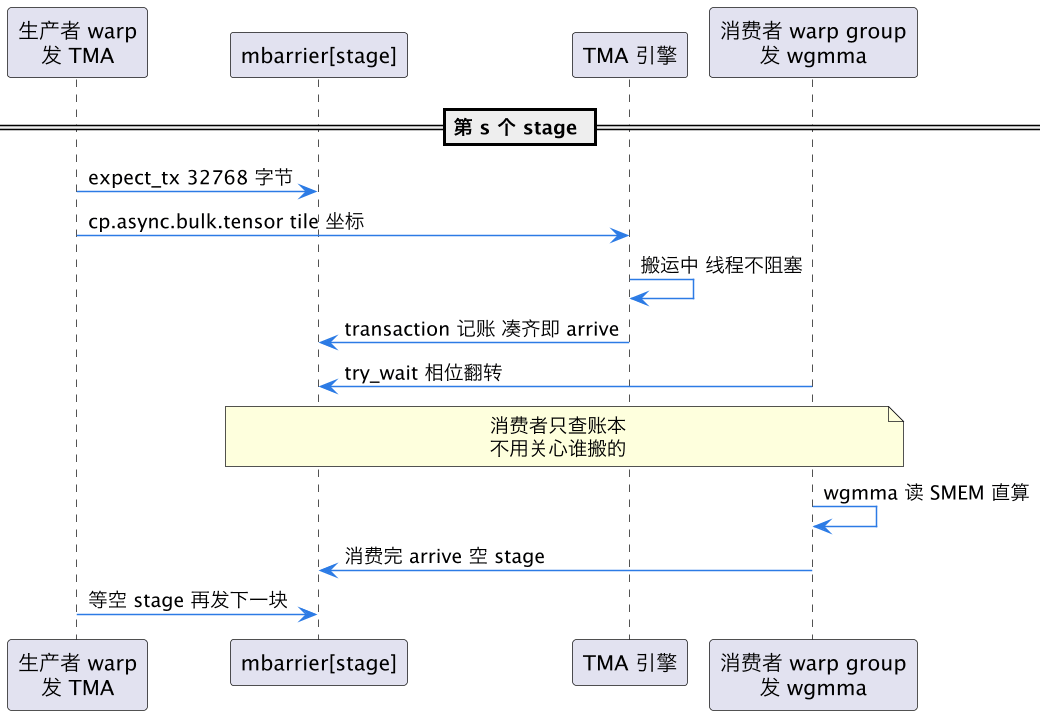
上图是单个 stage 的对账时序。把它复制成 4 到 6 个 stage 的环形缓冲(circular buffer),就是 CUTLASS 3.x Hopper 主循环的真身:stage 数就是流水深度,TMA 始终领先 wgmma 若干个 tile,SM 里任何时候都有「正在搬的」「搬完待算的」「正在算的」三态共存。流水深度越深,抗 GMEM 延迟抖动的能力越强,代价是 shared memory 占用——H100 每 SM 228KB 的 shared memory 就是为这种深流水准备的,A100 只有 164KB。
对比一张表,把三节内容收成一页账:
| 维度 | Ampere 流水 | Hopper TMA 加 wgmma |
|---|---|---|
| GMEM 到 SMEM | 每线程 cp.async 16B,2048 条指令搬 32KB | 单线程一条 TMA 指令,硬件切片 |
| 地址与 swizzle 计算 | 软件逐指令算,烧发射槽 | 描述符一次声明,硬件生成 |
| SMEM 到 tensor core | ldmatrix 软件再搬一轮 | wgmma 描述符直读 SMEM |
| 计算指令粒度 | mma.sync 16×8×16 | wgmma 64×128×16 起 |
| 完成判定 | wait_group 模糊等待 | mbarrier 数字节精确对账 |
| 越界 tile | 软件单独慢速路径 | TMA 硬件补零 |
| 多 block 复用数据 | 各自从 L2 重读 | TMA multicast 一次读多处发 |
| 编程模型 | 全员同质流水 | warp specialization 生产消费分工 |
五、范式之变:从「线程伺候数据」到「线程只发号施令」
把前三节合起来看,Hopper 这套东西的本质变化不在任何单点性能数字,而在角色分工。
Ampere 模型里,每个线程既是搬运工又是计算员:算地址、发拷贝、搬寄存器、发 mma,全员同质。这带来两个隐性约束——指令发射带宽是共享瓶颈,所有人的寄存器预算被同一份工作摊平。Hopper 模型里,SM 线程被降级成「调度员」:生产者发一条 TMA 指令就去发下一条,消费者等 mbarrier 翻相位、发一串 wgmma、再去做 softmax 之类的杂活。真正搬数据的是 TMA 引擎,真正算矩阵的是 tensor core,两者都是专用硬件,线程只在它们之间对账。 这和 warp specialization 流水线 讲的通用分工思想同源,但 Hopper 是第一次由硬件原语(TMA 的异步、wgmma 的组级异步、mbarrier 的字节对账)把这个分工撑到极限。
性能上限的变化是实的。FA3 在 H100 上 FP16 能打到 740 TFLOPS 上下(理论峰值约 989),FP8 破 1200,这个数字在 Ampere 架构上用同样的算法结构摸不到——不是 A100 的 tensor core 慢到那个程度,而是旧流水的发射和搬运税决定了峰值利用率到不了八成。代价同样实在:编程复杂度陡增。描述符构建、mbarrier 相位管理、stage 环、warp group 寄存器重分配,每一环都是新坑;wgmma.fence 和 fence.proxy.async 这类新旧内存代理(proxy)之间的顺序保证,文档稀疏、踩坑靠社区。所以实务建议很清晰:绝大多数项目不要手写这套原语,用 CUTLASS 3.x 的 CollectiveMma 或者现成 kernel 库;手写只发生在像 FA3 那样「现有库组合不出我要的交叠结构」的场景,而那时候本篇讲的概念就是读源码和调 bug 的最小词汇表。
调试口径也顺带变了。Ampere kernel 出问题,查的多是 swizzle 算错、bank conflict、wait_group 放错位置;Hopper kernel 的典型翻车现场是 mbarrier 相位错乱(消费者等错了相位,读到上一轮的旧数据,结果偶发错值且难以复现)、描述符里 box 尺寸和 stage 环的 shared memory 步长对不上(TMA 把 tile 写穿到下一个 stage)、以及忘掉 wgmma.fence 导致寄存器里的 A 操作数被编译器重排到 wgmma 发射之后才写入。排查工具上,nsight-compute 的异步事件时间线能直接看到 TMA 与 tensor core 的占用率空隙,流水空转在哪一段一目了然。
还有一个方向值得留意:TMA 加 wgmma 的范式没有止步于 H100。Blackwell 的 tcgen05 系列把 tensor memory(TMEM)引入操作数通路、把指令粒度继续加大,但「描述符驱动、异步发射、mbarrier 对账、warp 组分工」这套骨架原样继承。学会 Hopper 这一课,等于拿到了理解下一代 GPU kernel 的钥匙。
这一篇在知识体系里的位置
本篇是 GPU 微架构系列的「指令与流水层」深水篇:应用侧的直接下游是 FlashAttention 3 的 Hopper FP8 attention(FA3 的 softmax 与 GEMM 交叠、FP8 双流水全部建立在本篇原语之上)和 FlashAttention 显存分块(tile 化思想的上游);同层对照 CUDA stream 异步拷贝(粗粒度异步的入门课)、warp specialization 流水线(生产消费分工的通用框架)和 warp 级原语(warp 内协作的基础词汇);数值格式侧的延伸是 FP8 E4M3 与 E5M2 推理(wgmma 的 FP8 变体吃什么格式的数)。
阅读顺序建议:先把 Ampere 老三样(cp.async、ldmatrix、mma.sync)的机制想明白,再按本篇的「描述符、warp group、mbarrier」三个新概念逐个替换,最后回到 FA3 源码做一次实战印证——能认出 ProducerBarType 和 ConsumerBarType 两排 mbarrier 在 stage 环上的排布,就算真正出师了。
总结
Hopper TMA wgmma 用三件新硬件原语替换了 Ampere 的「cp.async 加 ldmatrix 加 mma.sync」老三样:TMA 凭 128 字节描述符用一条指令完成多维 tile 的异步拷贝与 swizzle、越界补零和 cluster 广播,wgmma 以 128 线程 warp group 为粒度发射 64×128×16 大指令并允许 A、B 操作数直读 shared memory,mbarrier 用 expect_tx 数字节机制在生产者与消费者之间精确对账——线程从「搬运工加计算员」降级为只发号施令的调度员,配合 stage 环形深流水和 warp specialization,把 H100 tensor core 的峰值利用率推到 Ampere 流水摸不到的高度,这就是 FA3 等新一代 kernel 全部性能红利的地基。