FPGA 原型验证专题 46:大规模原型的编译农场与周转时间工程——从一次综合 8 小时到一天出十个比特流
更新时间:2026-09-13。本文是模块 F(规模化、云化与工程运营) 第一篇。模块 A~E(26 事务处理器 SCE-MI 三类通道/transactor 实现~45 Trace 带宽与深度工程 采样/缓冲/压缩/回传管线)解决了“一个项目怎么在原型上跑通、调清楚、出可信结论”;模块 F 回答“同时有十几个分支、几十个人、上千片 FPGA 时,怎么让整条原型产线转得快、不打架、成本可控”。首篇从最痛的指标切入:从提交 RTL 到拿到能上板的比特流,要多久。
一、为什么周转时间是规模化后的第一杀手
单片小工程点一下“Generate Bitstream”,十几分钟出结果,没人会把构建当回事。大规模多片原型完全不同:
- 一次完整构建常 4~12 小时,大设计甚至隔夜;
- 一次分区/时序问题导致的返工,等于团队一整天没有可用镜像;
- 软件、固件、验证、架构四个组都在排队等“带某个特性的比特流”;
- 构建不是按“天”出一个,而是十几个 git 分支、多个 seed 同时想要。
周转时间(turnaround time,TAT)每翻倍,团队能并行探索的设计空间就砍半。它不是 IT 问题,是直接限制验证吞吐和架构迭代速度的工程问题(与 42 降频原型架构性能评估 cycle 计数/A-B/伪延迟扣除 的迭代闭环同源)。
二、把一次构建拆成五段,先看清时间花在哪
RTL ─▶ ① 综合 synth ─▶ ② 分区/适配 partition ─▶ ③ 多片 P&R(并行) ─▶ ④ 比特流生成 ─▶ ⑤ 归档/校验
可 OOC 并行 全局串行、最贵 每片并行/有先后依赖 纯算力并行 轻量 IO- 逻辑综合:RTL→门级,可按层次做 OOC(out-of-context) 自底向上并行,未改模块直接复用门级产物;
- 分区/适配:把网表切到多片、处理跨片互联 TDM(12 多 FPGA 分区算法 割集/容量/图划分、13 跨 FPGA 互联与 TDM SerDes/跨片同步/降频),这是全局串行步骤,分区一改后续全废;
- 多片布局布线:各片相对独立,可在多台 worker 上并行,但顶层时钟/IO/跨片约束有先后;
- 比特流生成:纯算力,可并行;
- 归档校验:生成版本指纹、info_table、校验和(20 比特流烧录与四方版本一致 manifest/门禁)。
优化原则:先测每段耗时占比,再动最贵的那段。 多数团队凭感觉加机器,结果发现 60% 时间卡在全局分区这一步,加再多 P&R worker 也没用。
三、编译农场的标准拓扑
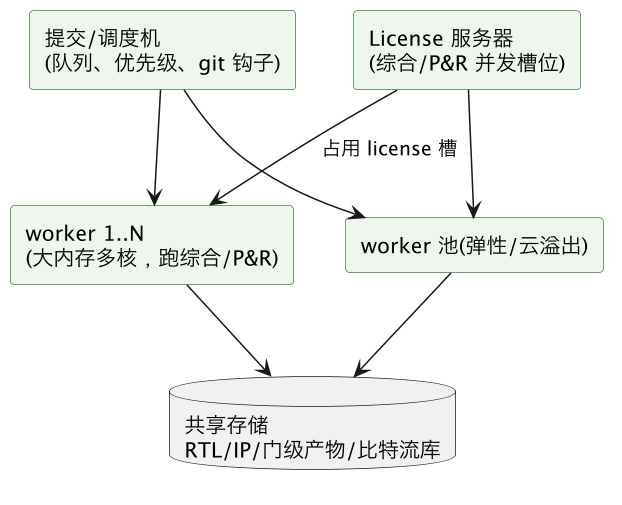
四个关键部件:
- 提交调度机:开发者不直接登 worker,而是提交构建请求(分支 commit、目标平台、是否复用分区、seed 列表)进队列;
- License 服务器:综合/P&R 按并发槽位授权,槽位数往往比机器数更早成为瓶颈,要按峰值并发购买或混用商用+开源综合(38 开源工具链);
- Worker 池:P&R 是大内存、多线程任务,worker 按“核数+内存”选型,多片构建可独占整机;
- 共享产物库:OOC 门级、分区结果、种子扫掠中间产物、最终比特流全部入库存档,供跨分支复用(与 20 比特流烧录与四方版本一致 manifest/门禁 配套)。
四、三个真正省时的技术杠杆
- OOC/层次化增量综合。固定不变的 IP(CPU 核、DDR/PCIe 控制器、NoC 骨架)一次性综合成门级 DCP/checkpoint 入库,日常构建只重综合改动模块。稳定模块占 70% 网表时,综合阶段能省一半以上。前提是边界(接口、参数、层次名)稳定,配合 10 RTL ID 体系 分配规则/层次绑定/稳定性。
- 分区与布局锁定复用。当本轮改动只动某一两片内的逻辑,复用其余片的布局和全局分区(partition freeze / 锁定 pblock),只重 P&R 受影响片。这是把 8 小时压到 2 小时的最大杠杆,但要设“复用失效条件”:跨片接口、时钟结构、资源利用率超阈值时自动全量重建,否则时序悄悄恶化。
- 多 seed 并行扫掠。同一约束跑 N 个布局种子并行,取满足时序者(19 原型频率与时序收敛 TDM 降频/关键路径)。农场把 seed 扫掠从“串行试一周”变成“一夜并行出 8 个”,是对付临界时序最划算的用法。
五、容量估算:该买几台 worker
把构建需求当流量算(类似 45 Trace 带宽与深度工程 采样/缓冲/压缩/回传管线):
每日构建总机时 H = Σ(各项目构建次数 × 单次机时 × 平均seed数)
所需并行 worker 数 W ≈ H / (单机每日有效机时 × 平均利用率目标)
license 并发槽 L ≥ 峰值同时在跑的综合/P&R 进程数
例:3 个项目各每天 2 次、单次 6 机时、平均 2 seed → 72 机时/天;单机有效 18 机时、目标利用率 70% → W ≈ 72/(18×0.7) ≈ 6 台,且 license 槽要覆盖峰值(早晨合并高峰可能 8~10 并发)。license 槽、worker、存储 IO 三者要平衡,任何一个短板都会让其余投资闲置。
六、队列调度:让有限产能用在刀刃上
先到先服务(FIFO)在多团队共用时必然糟糕——一个无关紧要的 seed 扫掠可能把流片前关键构建堵在后面。最小可用调度策略:
- 优先级分层:流片/里程碑构建 > 主干 bring-up > 特性分支 > 探索性 seed 扫掠;
- 自动取消过期任务:同一分支新 commit 进来,取消旧 commit 的排队/运行任务(构建的是 HEAD,中间版本没人要);
- 失败快速反馈:lint/elaborate/08 不可综合构造识别与存根替换 模拟IP/时钟门控 作为廉价前置闸门,别让低级语法错占用 4 小时 P&R 槽;
- 公平配额:每团队保底槽位 + 空闲池借调,防止一个组占满全场;
- 可抢占的低优先级任务:高优任务进来可暂停/迁移 checkpoint,或排到云溢出。
七、本地农场不够用时的云溢出
基线容量按日常负载自建,峰值(里程碑前、多分支齐发)弹性溢出到云 FPGA 构建实例(平台选型见 44 自建/购买/租云原型 TCO 模型 盈亏平衡/机会成本)。注意三个坑:①商用 EDA license 允许云端使用且计量方式不同;②大型 checkpoint/中间产物上云的传输时间可能吃掉弹性收益,要预热镜像和缓存;③云端构建产物回传与版本指纹要纳入同一产物库,不能出现“云里那个比特流对不上代码”。
八、一条把 TAT 从 36h 压到 9h 的改造路径
按收益排序、逐步落地:
- 先埋点测基线(1 周):五段各耗时、排队等待时间、license 拒绝率、失败率,没有数据不谈优化;
- 前置廉价闸门:提交即跑 lint/可综合/约束检查,把 20% 低级失败挡在 P&R 前;
- OOC + 产物库:稳定 IP 入库复用,综合段砍半;
- 分区/布局锁定:小改动只重建受影响片,主循环从全量变增量;
- 队列优先级 + 自动取消:消除无效排队;
- 多 seed 常态化并行:临界时序不再串行试运气;
- 云溢出接峰值:里程碑前不再因产能等待。
典型效果:首轮全量仍要 8~12 小时(无法回避),但日常增量迭代从 36h(隔夜+排队)压到 6~9h,工程师当天提交、当天上板,这是质变。
九、常见坑速查
- 凭感觉加机器,结果卡在全局分区/license 槽 → 先分段计时找瓶颈;
- 稳定 IP 每次重综合 → 建 OOC 产物库,按接口哈希复用;
- 无差别复用旧布局 → 跨片/时钟/利用率变化时必须自动失效重全量;
- seed 串行试 → 农场并行扫掠,一夜出多个;
- FIFO 队列 → 优先级 + 自动取消旧 commit;
- license、机器、存储只扩一个 → 三者按峰值一起平衡。
与系列及现有篇目的链接
- 构建内部步骤:12 多 FPGA 分区算法 割集/容量/图划分、13 跨 FPGA 互联与 TDM SerDes/跨片同步/降频、19 原型频率与时序收敛 TDM 降频/关键路径
- 资产与复用:20 比特流烧录与四方版本一致 manifest/门禁、10 RTL ID 体系 分配规则/层次绑定/稳定性
- 平台与成本:44 自建/购买/租云原型 TCO 模型 盈亏平衡/机会成本、36 商用原型平台版图 HAPS/Protium/第三方能力边界
- 运营配套:47 多用户资源调度 预约/作业/租约/防误烧、53 比特流回归与冒烟自动化农场 硬件 CI/门禁、54 运营指标看板 利用率/TAT/flake/就绪度
总结
一句话总结:大规模原型的首要瓶颈是周转时间(从提交 RTL 到拿到可上板比特流,多片设计一次全量常 4~12 小时),要把它当一条需要容量规划的产线而非“点一下生成”——先把一次构建拆成①可 OOC 并行的综合、②全局串行且最贵的分区适配、③各片相对独立可并行但有时钟/IO 依赖的多片 P&R、④纯算力并行的比特流生成、⑤轻量的归档校验五段并埋点测准每段耗时,只优化最贵的那段(多数团队盲目加机器却卡在全局分区或 license 槽);编译农场由提交调度机、按并发授权且常比机器更早成为瓶颈的 license 服务器、大内存多核 worker 池、以及与版本纪律配套的共享产物库四部件组成,容量按“每日构建总机时 H=Σ(次数×单次机时×平均 seed 数),worker 数 W≈H/(单机日有效机时×目标利用率),license 槽≥峰值并发”测算且 license/worker/存储 IO 三者必须平衡;三个真正省时的技术杠杆是稳定 IP 做 OOC 层次化综合按接口哈希复用门级产物(稳定模块占大头时综合段砍半)、小改动时锁定复用全局分区和未变片布局只重 P&R 受影响片(把 8 小时压到 2 小时的最大杠杆,但跨片接口/时钟/利用率超阈值必须自动失效转全量以防时序悄悄恶化)、以及多 seed 并行扫掠把临界时序从串行试一周变成一夜出八个;调度上用流片>主干>特性>探索的优先级分层、新 commit 自动取消旧任务(构建的是 HEAD 中间版本没人要)、lint/可综合/约束作为廉价前置闸门挡住低级错、团队保底槽位加空闲借调防独占、高优任务可抢占或云溢出;基线自建+里程碑峰值弹性上云(注意云端 license 授权、大 checkpoint 传输预热、产物回传纳入同一指纹库);按“测基线→前置闸门→OOC 产物库→分区布局锁定→队列优先级→seed 并行→云溢出”的顺序落地,首轮全量虽无法回避地要 8~12 小时,但日常增量迭代能从 36 小时压到 6~9 小时、做到当天提交当天上板,直接决定团队能并行探索多少设计分支。