OCC 时钟控制器物理实现:插链位置、shift/capture 时钟平衡与 CTS skew group 划分
更新时间:2026-10-03。功能时钟树的主线已经由 CTS 时钟树综合 讲过:从时钟根到千万个 sink,插 buffer、控 skew、压功耗。但那条主线只管「功能模式」这一个世界;一旦进入 scan 测试,时钟网络里还挂着另一个世界——shift 模式下的慢速移位时钟、capture 模式下的快速功能时钟、以及夹在中间做切换与门控的 OCC(On-Chip Clock controller,片上时钟控制器)。OCC 是 DFT 插在时钟树腰部的一块「小夹具」:RTL 侧它只是一段自动例化的控制逻辑(ATPG 工具怎么用它见 DFT scan 与 ATPG),物理侧它却牵动着整个时钟树的拓扑——插在哪一级、下游算谁的 skew group、shift 和 capture 两条路径怎么做到不偏不倚。这一篇就专门讲 OCC 的物理实现三件事:插链位置、双路径平衡、CTS skew group 划分,帮你在跑 CTS 之前把 OCC 相关的坑一次排掉。
本文要回答的问题
- OCC 在时钟树上到底是个什么东西,bypass 模式下时钟走哪条路?
- OCC 应该插在时钟树的哪一级,插得太高或太低各有什么代价?
- shift 时钟和 capture 时钟在 OCC 下游为什么要共树,不平衡会出什么问题?
- CTS 阶段怎么给 OCC 下游划分 skew group,stop pin、float pin、exclude pin 各用在哪?
- OCC 物理实现的验收清单长什么样,签核侧要盯哪些报告?
一、OCC 是什么:时钟树腰部的测试夹具
先把 OCC 在物理视图里的形状说清楚。OCC 是 DFT 流程在时钟树上插入的一个标准单元级控制器,典型内部结构是三件套:一个时钟选择器(mux,在功能时钟 func_clk 和测试时钟 test_clk 之间选)、一个门控单元(ICG 或 AND 门,受 shift_en / capture_en 控制输出脉冲)、一小段 shift 寄存器(scan chain 的第一级,存 ATPG 给的 pulse 个数模板,决定 capture 时打几个功能频率脉冲)。在 bypass 模式(有些库叫 parent mode)下,OCC 整体被旁路:func_clk 从输入直接穿到输出,OCC 退化成树上一段固定延迟;在非 bypass(OCC 使能)模式下,输出时钟由 OCC 内部的 mux 加门控决定——shift 阶段放行慢速 test_clk,capture 阶段按模板放出 1 到几个 func_clk 快脉冲。
对物理实现来说,OCC 的三个属性最关键。第一,它有两个时钟输入引脚,天然是时钟网络里的「汇流点」:func_clk 和 test_clk 在 OCC 之前的走线可以完全不同源、完全不同树,在 OCC 输出之后才重新合流。第二,它的输出时钟身份是双重的:同一个输出端口,shift 时是慢时钟、capture 时是快时钟,STA 里通常建两个时钟对象(或通过 case analysis 分模式分析)。第三,它是物理对象不是逻辑对象:OCC 单元摆在哪、输入两级 buffer 怎么放、输出第一级 buffer 离它多远,直接决定后面 skew group 的可调性。
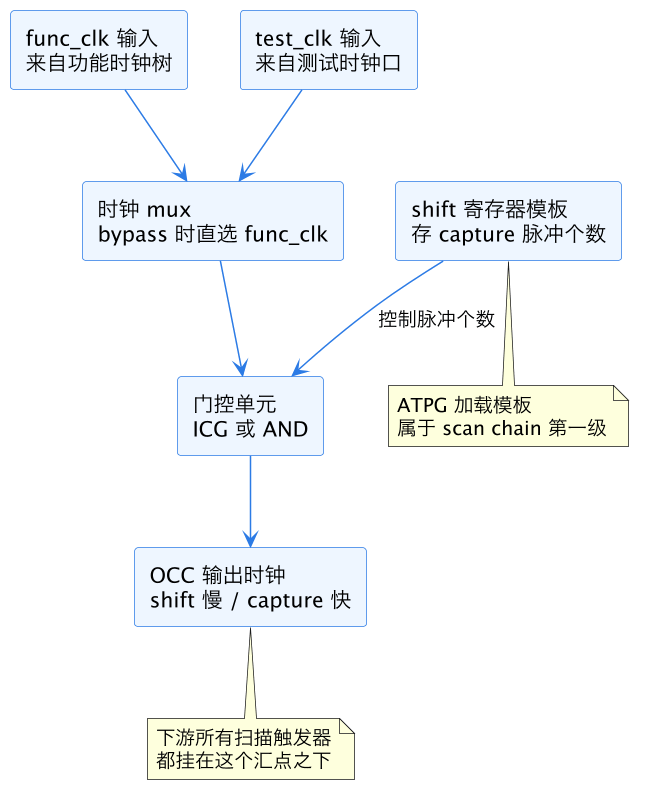
上图是 OCC 内部结构与时钟走向。读图重点在汇流语义:mux 之前是两个世界,mux 之后是一个世界。物理实现所有纠结——插哪、怎么平衡、skew group 怎么划——本质都是在处理「汇流点之前可以不管、之后必须严管」这个边界。
二、插链位置:OCC 挂在时钟树的第几级
OCC 插在时钟树的位置,决定了它管多少个触发器、也决定了功能时钟树和测试时钟树的工程量。工程上的候选位置可以按「离时钟根的远近」分三档。
第一档是根侧插入:OCC 直接挂在 PLL 输出或时钟根的第一级,下游整棵时钟树全部受它控制。好处是测试侧只需要一棵测试时钟树连到 OCC 输入,网络最简单;坏处是 OCC 单元本身成了整棵功能树的根——它的插入延迟(mux 加门控大约 1-2 级标准单元延迟)会加进功能时钟的 common path,对 setup 是利好(common path 越长 pessimism 越少的那部分越少),但它拖慢了树的整体 latency,OCC 前的时钟口到时序预算也更紧,而且根侧插入意味着 bypass 路径要承载全树负载,OCC 输出端的 buffer 链要按最大负载设计。
第二档是中间插入:OCC 挂在时钟树的第 3 到 8 级某个中间节点,控制一个时钟域的某个子树(比如一个电压域、一个大模块)。这是当前主流做法——中间插入把 OCC 的管辖范围收敛到一个可控规模,测试时钟口到各 OCC 的连线是星形分配,每个 OCC 下游的 skew group 独立可调,出了问题局部修。代价是测试时钟的分配网络本身要过 CTS(test_clk 到几十个 OCC 的输入也要有像样的 skew),等于 CTS 要同时种两棵树。
第三档是叶侧插入:OCC 贴近 sink 群,一个 OCC 只控制几十到几百个触发器。这几乎是 clock gating 的结构了,粒度太细,OCC 数量和测试时钟分配成本爆炸,只在特殊场景(比如某个硬核 IP 自带 OCC 接口)见到。
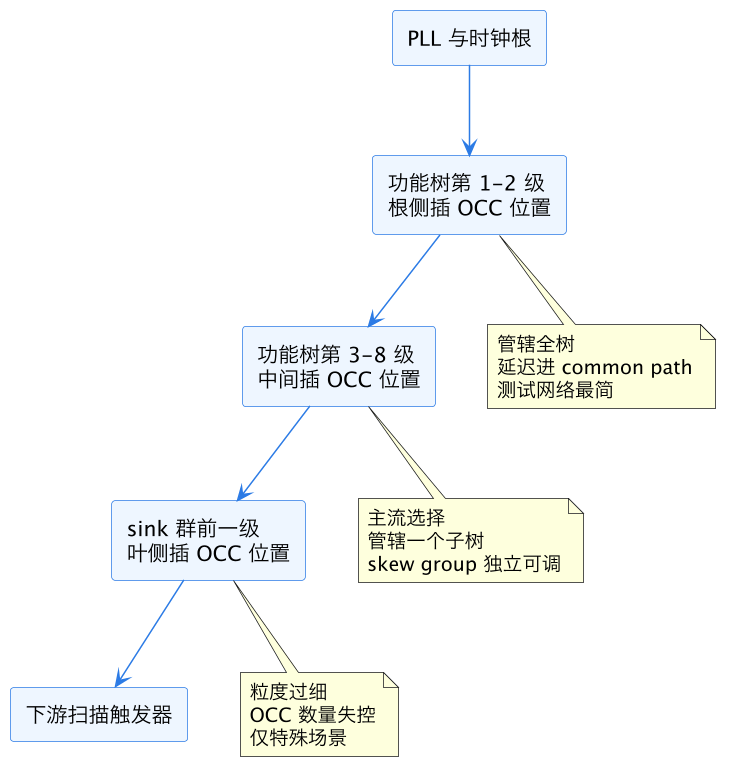
这张图把三档插入位置画在同一棵树剖面上。判断标准一句话:OCC 的插入位置 = 你愿意让一个测试控制器管辖多大的触发器群体。主流答案是「一个时钟子域」——和电压域、层次边界对齐,让 CTS 的 skew group 划分、功耗域的时钟关断、scan 分区的测试调度三者的边界重合。边界一旦错开(比如一个 OCC 跨两个电压域),后面 shift 模式功耗分析和 capture 时序分析都会多出无谓的悲观量。
三、shift 与 capture 的平衡:共树是底线,分叉是事故
OCC 物理实现里最硬的一条规矩:shift 时钟和 capture 时钟在 OCC 输出之后必须共树。原因很直白——scan 触发器在 shift 阶段被 test_clk 驱动、在 capture 阶段被 func_clk 驱动,而这两个时钟走的是同一个触发器时钟引脚。如果从 OCC 输出之后两条路径就分叉成两棵树,那么物理上就要给每个触发器引两个时钟引脚或者在时钟脚前再加 mux,面积和时序都是灾难。所以标准做法就是:双时钟在 OCC 的 mux 处合流,合流点之下只有一棵树,shift 和 capture 共用同一组 buffer、同一段走线、同一个 sink 集合。
共树带来的平衡问题是双模式的:CTS 必须保证这棵树在两个模式下都达标,而两个模式的要求完全不同。shift 模式时钟慢(常见 10-50MHz,快的可能到 100-200MHz),setup 毫无压力,要盯的是 hold——scan 链上一触发器接一触发器,级间逻辑几乎为零,任何正 skew 都直接变成 hold 违例,scan 链重排与时序 讲的链级时序问题有一大半根源在这里。capture 模式时钟就是功能频率,setup 和 hold 都要管,且 skew 预算和 func_clk 树一致。CTS 的应对是把 OCC 下游树按 capture 模式的预算来建(树建得和功能树一样好),然后 shift 模式的 hold 靠两件事兜底:一是 capture 预算本来就比 shift 需要的更紧(快时钟树做好了,慢时钟天然受益——同一棵树的 skew 与频率无关),二是 ATPG 侧通过慢速 shift 加链级 hold 修复吸收残余 skew。
这里要戳破一个常见误解:有人以为「shift 慢所以 skew 无所谓」。错——skew 是物理量,与频率无关,1ns 的 skew 在 50MHz 下照样造成链级 hold 违例,因为触发器到触发器之间没有组合逻辑来吸收它。慢只是让 setup 无关紧要,hold 反而因为数据路径极短而更敏感。
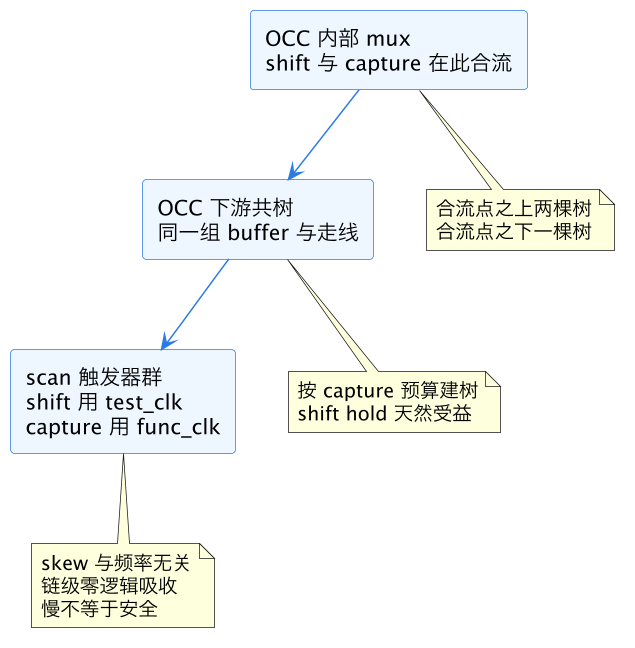
这张图是共树原则的结构表达。要读的重点在树的标注:建树预算取 capture(快模式)的,因为两个模式共用物理树,按更严的那个建,另一个自动达标——这是 OCC 下游 CTS 策略的「一树两吃」本质。但注意这句话有个前提:两个模式看到同一组 sink 引脚。如果设计里有触发器只在功能模式被时钟(比如某些不扫描的 retention 寄存器挂在 OCC 下游),那些引脚在 shift 模式是多余的负载,skew group 划分时要么排除要么单独标记,这就是下一节的主题。
四、CTS skew group 划分:OCC 下游谁和谁对齐
CTS 时钟树综合 讲功能树时,skew group 的概念很简单:一棵功能树一个 group,组内 sink 互相对齐。引入 OCC 之后,skew group 的语义复杂化了——CTS 至少要看见三组边界:OCC 之前的 test_clk 分配网络(多个 OCC 的测试输入引脚互相之间要不要对齐)、OCC 内部(mux 两个输入到输出的延迟算不算进平衡范围)、OCC 下游(共树的 sink 群按哪个模式的预算建)。
主流 CTS 工具的做法是模式感知的 skew group:在 capture(功能/scan capture)模式下,OCC 下游的 sink 群和该时钟域内其他功能 sink 算同一个 skew group——capture 时打的就是功能脉冲,时序语义和功能模式一致,skew 预算也一致;在 shift 模式下,OCC 下游单独成一个 skew group,预算可以放宽(shift 只要 hold 干净,setup 无所谓),但 group 内仍要平衡。OCC 的测试输入引脚(test_clk 侧)在 shift 模式下组成另一个 group,各 OCC 的 test 输入之间一般不要求严格对齐——ATPG 的 shift 协议对 OCC 之间的相对相位不敏感,它们只要求各自下游稳定,所以 test 分配网络通常用「balanced 但宽松」的策略建树,甚至可以直接走综合期的 buffer 链而不进 CTS 精调,节省大量 buffer 面积。
OCC 内部引脚的处理用 CTS 的 pin 属性表达:OCC 的 func_clk 输入在功能树里是 stop pin(功能树在此终结,延迟算到这儿为止);test_clk 输入在测试网络里同样是 stop pin;OCC 的输出引脚则是下游树的根(root 语义)。bypass 路径的延迟——mux 直选路径——在 capture 模式时序里要如实建模,有些流程用 set_case_analysis 把 OCC 钉在 bypass 态跑功能时序,用 OCC 使能态跑 capture 时序,两套分析各自的时钟图要核对一致。OCC 的 shift_en、capture_en 等控制引脚是 exclude pin:它们是数据网络不是时钟网络,千万别让 CTS 把它们拉进 skew group,否则工具会去「平衡」控制信号,种出一堆莫名其妙的 buffer。
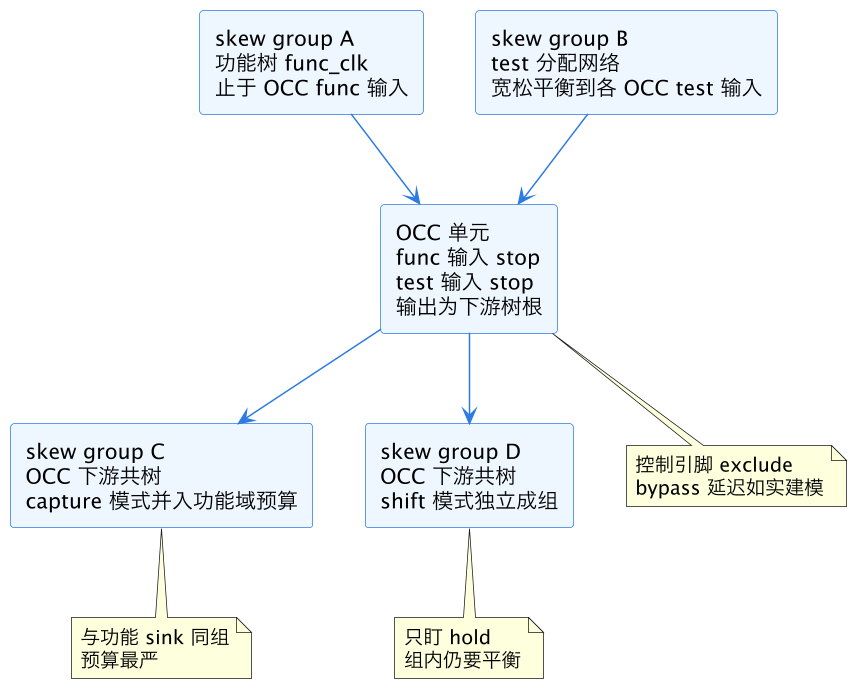
这张图是 OCC 相关的 skew group 全景。读法:四个 group 是两个「输入侧」加两个「下游模式侧」,OCC 单元本身是 group 边界上的海关——所有时钟身份转换都在这里发生。实战里 CTS 报告最容易出问题的地方就是边界:功能树的 latency 算到 OCC 输入为止,下游树的 latency 从 OCC 输出重新起算,签核 STA 若把整段(根到 sink)拉通看,OCC 的插入延迟必须出现在报告里且数值稳定;若 OCC 延迟随电压温度波动大(比如门控用了慢速单元),capture 脉冲的占空比和延迟都会漂,ATPG 的 at-speed 测试就会失真。
五、物理实现清单与签核关注点
把前面四节落成一张可执行清单。布局阶段:OCC 单元按管辖子域就近摆放(一般在子域时钟进入侧),与其前后两级 buffer 形成小的簇,bypass 路径的走线预算写进 floorplan 注释;test_clk 分配走线若为长距离跨模块,提前规划 feedthrough 通道。CTS 阶段:按第四节建好四个 skew group,OCC 下游用 capture 预算建树;功能树 stop pin 清单里核对每个 OCC 的 func 输入都在列;控制引脚 exclude 清单逐个核对(工具自动推导经常漏 scan_enable 链上的特殊单元)。CTS 后时序:capture 模式 setup/hold 按功能签核标准跑;shift 模式单独跑 hold 分析,链级违例交回 scan 链重排与时序 的手段处理;OCC 内部时序(mux 的 select 建立时间、门控使能的时序检查)在两种模式下都要干净,clock gating check 与 STA 那套 ICG 检查方法对 OCC 的门控同样适用。功耗侧:shift 模式全链翻转是功耗峰值场景,OCC 下游树在 shift 时是全网最活跃的网络之一,IR drop 分析要把 shift 模式纳入场景清单,这与 useful skew 与 CTS 优化 里讨论的功能模式优化是两个世界,别拿功能模式的功耗报告去放行测试模式。
| 阶段 | 动作 | 验收信号 |
|---|---|---|
| 布局 | OCC 按子域就近摆,前后 buffer 成簇 | OCC 到首级 sink 群距离合理,无跨域长线 |
| CTS 约束 | 四 skew group 建好,stop/exclude 清单核对 | 报告里 OCC 各引脚身份正确,无控制引脚入组 |
| CTS 后 STA | capture 按功能标准,shift 单跑 hold | shift hold 干净;OCC 门控检查两模式全过 |
| 功耗 | shift 模式进 IR 场景清单 | shift 峰值功耗与 IR 在预算内 |
| 签核 | 整段时钟延迟拉通核对 | OCC 插入延迟稳定,bypass 与使能两态报告一致 |
上表是 OCC 物理实现的最小验收闭环。最后一行「两态报告一致」特别值得强调:bypass 态(功能)和 OCC 使能态(capture)在签核里是两套 case analysis,很多项目在功能侧签干净了却在 capture 侧翻车,原因就是 OCC 使能态的时钟图没有被同等严格地审查——DFT 侧默认「工具会处理」,PR 侧默认「DFT 验过了」,缝隙就这么产生了。
这一篇在知识体系里的位置
本篇是 eda/ 目录时钟线里「DFT 与物理实现交叉带」的专题文,主线 CTS 时钟树综合 讲功能时钟树的通用引擎,本篇讲的是这棵树上被 DFT 插入 OCC 之后的特化问题。向上承接 数据流 S4 之 CTS 与 route 的流程定位与 数据流之 test pattern 格式 的测试数据视角;横向连接 DFT scan 与 ATPG(OCC 的逻辑功能与 ATPG 协议)、scan 链重排与时序(shift hold 的链级治理)、clock gating check 与 STA(门控时序检查方法)、useful skew 与 CTS 优化(功能树 skew 的进阶用法);向下接 数据流 S5 之签核收敛 的多模式签核。读完本篇,CTS 报告里每一个和 OCC 沾边的 skew group、stop pin、exclude pin 你都能说出它为什么在那里。
总结
OCC 时钟控制器的物理实现抓住三件事就不会翻车:插链位置按时钟子域选中间级(根侧管辖太大、叶侧粒度失控),让 skew group、电压域、scan 分区三者边界对齐;shift 与 capture 在 OCC 内部 mux 处合流后必须共树,建树预算取 capture(快模式)一方,shift 的链级 hold 靠共树低 skew 加 ATPG 侧手段兜底——记住 skew 与频率无关,慢时钟不等于安全;CTS 阶段按「功能树止于 OCC func 输入、test 分配网络宽松平衡、OCC 下游 capture 并入功能预算、shift 独立成组」四类 skew group 划分,stop pin、root、exclude pin 身份逐一核对,capture 与 bypass 两套 case analysis 同等严格签核,并把 shift 峰值功耗纳入 IR 场景清单,OCC 这个 DFT 夹具就从时钟树上的「异物」变成可预测、可验收的常规组件。