CUDA Graph 逐节点开销拆解:capture 摊销、launch 构成、参数更新成本与适用边界
更新时间:2026-10-06。CUDA Graph 是 decode 阶段延迟优化的标配:把一长串 kernel 的启动序列录制成一张有向无环图,之后用一次
cudaGraphLaunch整体提交,省掉逐个 kernel 的 CPU 侧启动开销。站内 CUDA Graphs 捕获与回放 讲了机制与用法,这篇换一个更靠近性能工程的视角:Graph 自己也不是免费的——capture 要时间、instantiate 要时间、节点参数更新要时间,launch 之后还有固定的提交开销。把每一项拆开量清楚,才能回答「这个场景上 Graph 到底赚不赚」。
本文要回答的问题
- 一次 graph launch 的开销由哪几部分构成,和普通 kernel launch 差在哪?
- capture 和 instantiate 的一次性成本多大,要 replay 多少次才能摊平?
- 节点参数更新(换 batch、换指针)的成本模型是什么,什么时候更新比重新 capture 还贵?
- 哪些执行模式天然不适合 Graph,适用边界的定量判据怎么定?实测验证又该抓哪些时间线?
一、从普通 launch 到 graph launch:省掉的和新增的
本节先把两条提交路径摆在一起对比,建立「省了什么」的直觉。
先看基线。一次普通 cudaLaunchKernel 的 CPU 侧开销约 3 到 8 微秒:参数打包、驱动校验、命令写入 ring buffer、门铃提交。kernel 本身如果只有几十微秒(decode 的小 GEMM 大量如此),CPU 启动开销和 GPU 执行就会互相等待——前一个 kernel 跑完了 CPU 还没把下一个提交上去,GPU 空转,这就是所谓 launch bound。decode 一步前向有几百个 kernel(80 层 × 每层若干算子),串行 launch 的累计 CPU 开销能到毫秒级,直接吃掉 ITL 预算。
Graph 的解法是把「几百次提交」换成「一次提交」。录制阶段(capture)把 kernel 序列和依赖关系固化成图;实例化(instantiate)把图编译成 GPU 可执行的结构;回放阶段(replay)一次 cudaGraphLaunch 把整张图推给 GPU,CPU 侧开销降到 5 到 15 微秒量级,且与图里 kernel 数量基本无关。GPU 侧还有一个附带收益:图内节点间的依赖是硬件直接调度的,kernel 间间隙从微秒级压到亚微秒,小 kernel 密集的场景(persistent decode 之外的普通 decode 流水线)光这一项就能再省出一截,相关讨论见 persistent megakernel decode 里对 kernel 间隙的分析。
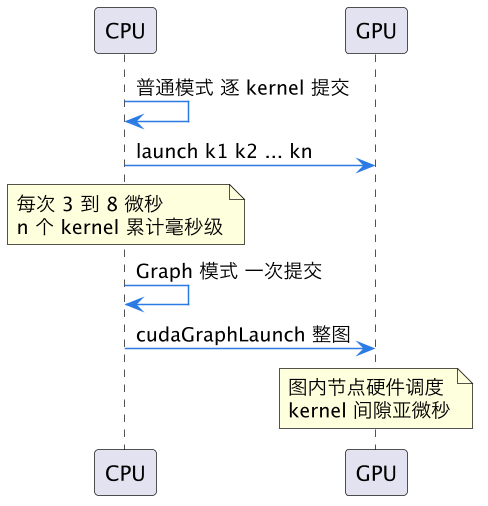
上面这张时序图对比了两种提交路径。左边的问题不是单次 launch 慢,而是「n 次 × 每次几微秒」的累计和 CPU 与 GPU 的乒乓等待;右边把这两样一起消掉。但注意时序图没画出来的部分——左边的路径没有前期成本,右边的路径有,这就是下一节的摊销账。
给一个量化的体感数字。70B 级模型 FP8 decode,batch 8 时一步前向约 12 毫秒中,纯 kernel 执行占 9 毫秒左右,剩下的 3 毫秒里有 2 毫秒以上是 launch 与 kernel 间隙——Graph 化之后 step 时间能压到 9.5 毫秒上下,ITL 改善 20% 以上,而且是零精度代价、零模型改动的纯系统收益。batch 越小收益比例越大,batch 1 时 launch 开销占比能到四成,这也是为什么所有面向在线 decode 的引擎(vLLM、SGLang、TRT-LLM)都把 CUDA Graph 当默认开启项而不是可选优化。
二、一次性成本:capture、upload、instantiate 的摊销账
Graph 的前期成本有三笔,性质各不相同:
capture(录制):把真实执行流导入 capture 模式,驱动记录每个 kernel 及其依赖。开销约等于「一遍空跑」——所有 kernel 照常提交但只做记录不执行(或执行但结果被丢弃),再加上依赖分析。一个 decode step 的图 capture 通常在几百微秒到几毫秒。它的特点是每个不同形状的图都要单独 capture 一次:batch size 变了、序列长度桶换了,就是一张新图。
instantiate(实例化):cudaGraphInstantiate 把捕获的图编译成可执行图(exec graph),做节点调度规划、设备内存分配、指针固化。开销通常也是毫秒级,每张图一次。实例化后的 exec graph 常驻显存,图越多占的显存越多——vLLM 这类引擎为一批 batch size 桶各备一张图,几十张图的显存占用能到 GB 级,这是常被忽略的隐性成本。
upload(上传):首次 launch 前 exec graph 的结构要上传到设备,cudaGraphUpload 可以显式做也可以被首次 launch 隐式触发。毫秒级,每张图一次。
三笔加起来,一张图的前期成本在「几毫秒到几十毫秒」量级。摊销公式很直白:摊平次数 = 前期总成本 / 每次 replay 省下的时间。decode 场景每次 replay 省几百微秒到一毫秒,意味着一张图 replay 几十次就回本——而 decode 一个请求就要跑几百上千步,摊销毫无压力。真正要算这笔账的是图的种类数:如果负载的 batch 分布很散,要为几十个形状各备一张图,前期总成本乘上形状数,冷启动时间就会变得可观。

上图把三笔成本和摊销关系画在一起,右下角黄色节点是容易被漏算的项。生产上的标准做法是按桶备图:batch size 按 1、2、4、8……2 的幂分桶,每个桶 capture 一张图,运行时向上取整到最近的桶。桶数控制在十几个以内,前期成本和显存占用都可控,命中率(请求正好落在已备图的桶上)靠 padding 补。
冷启动是备图策略的另一个约束面。引擎启动时为十几个桶各做一次 capture 加 instantiate,总耗时能到十几秒甚至一分钟——在弹性伸缩场景里,这段时间实例还接不了流量,会被 HPA 的就绪探针误判为不健康。两种常见对策:一是预热后注册,实例先完成全部 capture 再把自己注册进负载均衡,就绪探针挂在 capture 完成信号上而不是进程存活上;二是首桶懒加载,启动只备最小的两三个桶,其余桶在对应 batch 首次出现时在线 capture——代价是那一两次请求延迟会突然多个几十毫秒,对延迟敏感的业务要权衡。自动扩缩容的整体配合见 LLM 服务 autoscaler 与 HPA。
三、节点参数更新:Graph 的软肋在哪
图回放的前提是「每次执行只有数据变、结构不变」。但真实负载里每步都有变化:KV cache 的指针、batch 内 token 数、sequence 长度。Graph 提供两类应对机制,成本差异巨大。
零成本路径:间接寻址。vLLM 等引擎的主流做法是让 kernel 不直接读「数值参数」,而是读显存里的一块参数区(input buffer)。每步开始前用一次小拷贝把新参数写进这块显存,图本身一个字节都不用改。所有随步变化的量——token id、位置、KV block table、batch 内各序列长度——全部走这条路径。这是 Graph 能在 decode 落地的前提,TRT-LLM inflight batching 的实现也是同一思路。
有成本路径:cudaGraphExecKernelNodeSetParams。当变化无法被间接寻址吸收(比如 kernel 的 grid 维度必须变),就得直接改节点参数。这个 API 每次调用是微秒级,但它有一个陷阱:改某些参数会触发 exec graph 的局部重新实例化,代价跳回毫秒级。另一个 API cudaGraphExecUpdate 可以做拓扑级增量更新,同样不保证便宜——更新失败时返回码要求你销毁重建。
三条路径的选择在编码期就要定死,因为它们是互斥的架构决策:间接寻址要求所有 kernel 的接口按「读显存参数区」写,SetParams 要求保住每个节点的句柄,两者混用会让图的一致性状态极难维护。主流引擎全部押注间接寻址,SetParams 只留给出厂后无法改写的第三方 kernel——这也是评估一个第三方算子库「Graph 友好度」时最该问的接口问题。
最贵路径:重新 capture。结构变化太大(算子序列本身变了)时只能重来。所以设计上的铁律是把变量全部逼进间接寻址路径,让图结构对负载变化免疫:grid 维度用最大桶固定、kernel 内读真实尺寸做早退,而不是每步改 grid。

上图按成本排出三条路径的优先级。读图时注意黄色节点的注释——「grid 维度变化」是工程上最常见的踩坑点,因为 CUDA 编程直觉是「有多少活开多少线程」,而 Graph 友好写法是「开固定数量的线程,进去再看有多少活」。这个写法转变是引擎改造工作量的大头。
四、适用边界:什么时候不该上 Graph
Graph 的收益公式 = n 个 kernel 的 launch 开销 − graph launch 固定开销 − 摊销成本。由此可以直接推出四类不适用或慎用场景:
kernel 又大又少:一层一个巨型融合 kernel(比如 FlashMLA decode 内核解析 里那种大 attention kernel),launch 开销占比本来就低,Graph 省不出什么。
形状高度发散且不可分桶:如果负载的序列结构使得每步都是新形状,要么桶数爆炸(显存和冷启动成本失控),要么大量请求落桶失败回退 eager——回退路径和普通模式一样慢,Graph 白备。
含动态控制流的执行:kernel 数量或依赖关系在运行时才决定(条件分支、动态循环、稀疏结构的动态形状)无法被静态图表达,capture 要么失败要么录出错误结构。device-side graph launch 能缓解一部分,但复杂度和收益要个案评估。
多流并发与外部事件:图的捕获边界是一条流的执行区间,跨流依赖要在 capture 内用 event 记录才能被图吸收;如果执行流依赖 capture 之外异步完成的事件(比如等另一张卡的 NCCL 完成),图回放时的时序假设就不成立,轻则结果错乱重则挂死。张量并行下的 Graph 化因此有个标准姿势:把通信 kernel 一并录进图、让 NCCL 也用 capture 兼容的流,而不是图外等通信。
调用含同步与 host 回调:capture 区间内不允许 cudaStreamSynchronize、不允许 host callback(cudaStreamAddCallback 之类),含这些节点的执行流必须拆开分段 capture,拆多了收益又被摊薄。推理服务里常见的「每步结束同步读回一个标志位」就是这种反模式,替代写法是把标志位留在显存里、让下一个 kernel 自己读,CPU 只在真正需要出结果的边界(比如一个请求 decode 完)才同步。
把这五类边界串起来看,它们的共同判据其实是同一条:Graph 喜欢「形状可枚举、依赖可静态、数据走显存」的执行,讨厌任何让 CPU 中途介入结构决策的设计。做引擎改造时与其逐条核对清单,不如先用这一条判据过一遍架构——判据通不过的环节,基本就是上面五类中的某一类。
| 场景画像 | 单步 kernel 数 | 形状稳定性 | Graph 收益 | 建议 |
|---|---|---|---|---|
| decode 小 batch | 数百 | 分桶后稳定 | 大(省 30% 到 50% step 时间) | 必上 |
| decode 大 batch | 数百 | 稳定 | 中(kernel 变大 launch 占比降) | 上 收益递减 |
| prefill 长序列 | 数十个大 kernel | 长度分桶 | 小 | 可不上 |
| 离线吞吐批量 | 大 kernel 为主 | 稳定 | 小 | 不上 |
| 动态稀疏 研究型负载 | 不定 | 发散 | 负(回退开销) | 不要上 |
这张表可以直接当 checklist 用。最后一个提醒:Graph 的收益要在端到端指标上验收(ITL、TTFT),不要只看 kernel 时间线变密了——参数区写入、桶 padding 浪费的算力都是真实成本,端到端数字没变好的 Graph 化就是白忙。相关的端到端指标口径见 LLM 服务 TTFT 与 TPOT SLO。
给一套实测方法把本文的数字变成你自己的数字。第一步,用 Nsight Systems 抓一段普通模式的 decode 时间线,量出 kernel 间隙的总占比——这就是 Graph 能省出的上限,间隙占比低于 5% 的负载可以不上。第二步,打开引擎的 Graph 开关后再抓一段,确认 kernel 间隙消失的同时没有出现新的 CPU 段(参数区写入暴露出来的话说明间接寻址没做干净)。第三步,对每张备好的图各 replay 一千次取均值,验证「graph launch 开销与图大小无关」这个假设在你的驱动版本上成立——历史上个别驱动版本在超大图上退过化,用回归测试把这个假设锁进 CI 比信任文档稳妥。
这一篇在知识体系里的位置
本篇是 decode 延迟优化专题的工程拆解篇:机制基础在 CUDA Graphs 捕获与回放;同层的替代路线(把 kernel 融合到只剩一个)在 persistent megakernel decode;Graph 在推理引擎里的装配方式见 TRT-LLM inflight batching;收益的最终验收口径在 LLM 服务 TTFT 与 TPOT SLO。
总结
CUDA Graph 把 n 次 kernel launch 的累计 CPU 开销换成一次几微秒的整图提交,但它自己的成本结构是三笔一次性开销(capture、instantiate、upload,每张图几毫秒到几十毫秒)加常驻显存,靠按 batch 分桶备图把形状数控制在十几个以内摊平;运行期所有变化必须走间接寻址的显存参数区,SetParams 和重新 capture 是微秒到毫秒级的退步路径;适用边界由「单步 kernel 数 × launch 占比 × 形状稳定性」三变量决定——decode 小 batch 是最大受益者,大 kernel 少而稳的负载收益甚微,动态控制流和形状发散负载不要上。