SystemVerilog 随机稳定性:RNG 层次、播种与失败用例可复现
更新时间:2026-09-25。CRV 基础篇 解决了「怎么写出合法随机激励」,进阶随机化 解决了「怎么调控分布」;这一篇解决一个回归里每天都在发生的问题——昨晚挂掉的用例,今天为什么重跑不挂了。答案就是 SystemVerilog 随机稳定性(random stability)。
本文要回答的问题
- SystemVerilog 随机稳定性到底指什么?随机数从谁那里产生?
- 为什么代码里随手新增一条随机调用,后面所有随机值就全变了?
- 怎么让失败用例稳定复现,又怎么让回归每次跑到不同的激励?
一、每个线程、每个对象都有自己的 RNG
SystemVerilog 的随机不是全局一锅汤。语言规定:每一个线程(thread)拥有一个独立的随机数发生器(Random Number Generator,RNG),每一个类对象也拥有一份独立的 randomstate。 $urandom、$urandom_range、randomize() 取数时,都只消费调用者自己那一份状态,取一次状态往前走一格。
仿真启动时,initial 线程拿到仿真器给定的初始状态;之后状态按固定的数学递推推进。所谓随机稳定性,就是「同一份初始状态 + 同样的取数顺序,必然得到同一条随机序列」。它稳定的不是某个随机值,而是值与调用顺序之间的对应关系。
下图画出 RNG 的层次与种子传递路径:
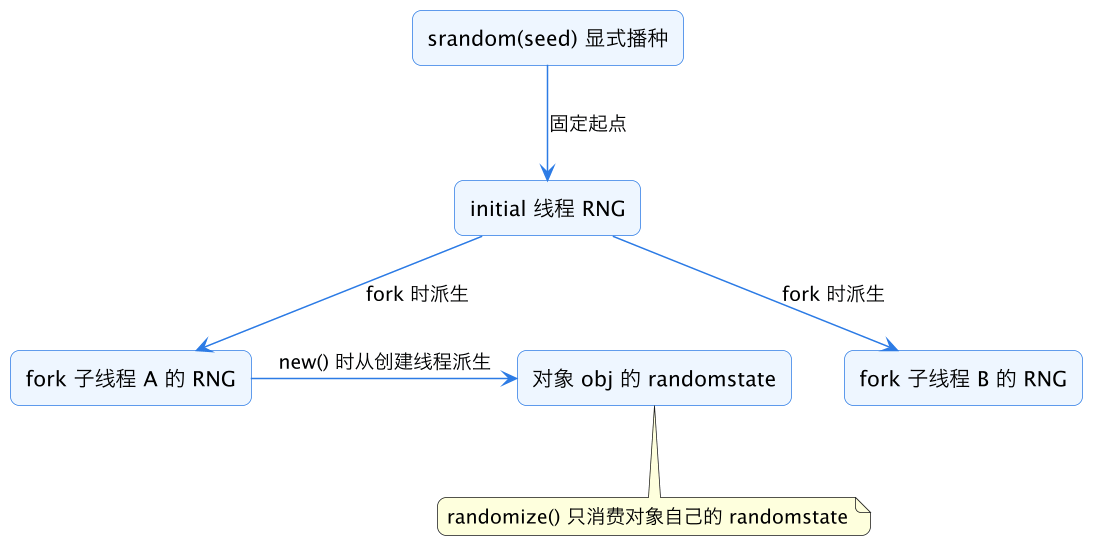
这张图有两个要点:其一,播种动作作用在线程上,种子沿「initial 线程 → fork 子线程 → 对象」逐级派生;其二,对象一旦创建,就和创建它的线程分道扬镳——后续 obj.randomize() 消费的是对象自己的 randomstate,线程里再调多少次 $urandom 都不会影响它。
二、RNG 的层次:fork 与 new 如何取种
子线程的 RNG 在 fork...join_none 派生出线程的那一刻,从父线程当前的 RNG 状态初始化;多个子线程各自拿到互不相同的派生状态,因此兄弟线程不会抽出同一串数。注意初始化时机是 fork 那一刻,而不是子线程真正开始执行的那一刻——调度顺序改变执行先后,却不改变各自拿到的种子。
对象同理:new() 执行时,新对象的 randomstate 从执行 new 的那个线程当前的 RNG 派生。这解释了一个常见现象:同一段构造代码,放在不同线程、或在线程的不同位置调用,对象随机出的值完全不同;但只要种子和调用位置不变,它又次次相同。
再细一层:同一线程里先后 new() 两个同类对象,两个对象拿到的是两份不同的派生状态,因此即便约束完全一样,它们第一次 randomize() 的结果也不同;调换两次 new 的先后顺序,两个对象的序列整体交换。这也提醒团队不要把「可复现」误读成「所有对象同种子」——层次派生的目的恰恰是让每个对象各有一条确定但互不重复的序列。
| 持有者 | 状态何时初始化 | 谁在消费它 |
|---|---|---|
| initial 线程 | 仿真启动,可用 srandom 重设 | $urandom、randcase、randsequence |
| fork 子线程 | fork 派生时从父线程取种 | 该线程内的系统随机调用 |
| 类对象 | new() 时从创建线程取种 | 该对象的 randomize() |
三、为什么新增一条随机调用,后面的值全错位
RNG 是一条只进不退的消费序列:v1、v2、v3、v4……每取一个数,状态推进一格。如果在中间插入一次新的随机调用,它会先消费掉一个数,于是原本该拿到 v2 的地方拿到了 v3,后面依次全部错位。种子没有变,代码逻辑也没有错,但整个激励序列已经是另一条。
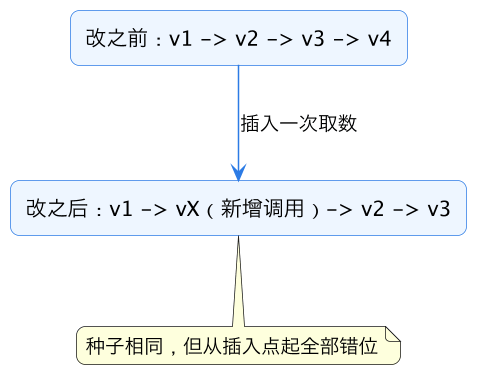
这正是随机稳定性的代价:稳定的是「第 N 次调用得到第 N 个值」,不是「某个字段永远等于某个值」。下面这些改动都会引发错位:新增一个 rand 字段、加一次 $urandom_range、约束里引入新的随机变量、把对象的 new() 挪了位置、甚至多 fork 一个线程(父线程为派生种子本身也要取数)。调试这类「代码没改坏,激励却变了」的问题,先怀疑取数顺序,而不是怀疑求解器。
四、三种播种与状态控制手段
| 手段 | 作用对象 | 典型用途 |
|---|---|---|
$srandom(seed) | 调用它的线程 | 在线程内部固定本线程起点 |
process::self().srandom(seed) | 当前进程 | test 开头统一播种,最常用 |
obj.srandom(seed) | 指定对象 | 只固定某一个对象的序列 |
get_randstate() / set_randstate(s) | 调用线程 | 导出、恢复某一时刻的完整状态 |
set_randstate 接受的是 get_randstate 返回的不透明字符串,不能手工编造。它的价值在于「存档/读档」:在激励生成前存档,复现失败时跳过无关前缀直接恢复到现场,比从头重跑省时;也可以在派生环境前后保存状态,对比两个分支是否从同一点出发。
string snap;
initial begin
  process::self().srandom(seed);
  build_env();
  snap = get_randstate();        // 环境就绪后的存档点
  gen_and_drive();
end
// 复现时:set_randstate(snap) 即可跳过 build_env 重放现场
obj.srandom(seed) 则是第三条路线:线程和别的对象都不动,只把某一个对象的 randomstate 重设。定向调试某个事务对象时它很顺手,但不要在大规模回归里滥用——对象间各自播种,等于手工维护一套种子谱系,后期谁也说不清两条激励是否相关。
五、randcase 与 randsequence 的随机源
randcase 的分支抽签和 randsequence 的产生式选择,使用的都是当前执行线程的 RNG,而不是任何对象的 randomstate。因此:
- 在对象方法里调 randcase,消耗的是调用该方法的线程,对象的 randomstate 不动;
- 对对象调用
obj.srandom()不会影响其方法内 randcase 的结果,要固定它得固定线程种子; - randsequence 里新增一条产生式,同样会让后续抽签整体错位,规则与第三节完全一致。
这条规则的推论是:同一段 randsequence 在两个不同线程里执行,即便时序完全对齐,抽签结果也互不相同;反过来,在同一线程里、同一状态下进入该段代码,分支选择逐次一致。很多团队把激励引擎写成 randsequence 却把播种只作用在对象上,复现时发现产生式选择飘忽不定,根因就在认错了随机源。
六、工程实践:固定种子复现,回归换种子撒网
先看不播种的写法。仿真器默认种子每次回归可能不同,日志里又没记录,失败就成了「薛定谔的用例」:
initial begin
  pkt p = new();
  p.randomize();
  drive(p);            // 这一轮挂了,下一轮种子变了,挂点消失
end
固定种子后,任何时间、任何机器重跑,序列逐位一致,失败现场可以反复打开:
initial begin
  process::self().srandom(32'd20260925);  // 固定起点
  pkt p = new();
  p.randomize();
  drive(p);                                // addr/len 次次相同
end
真正的回归两者都要:种子通过命令行参数(如 +SEED=12345)传入,test 开头第一件事就是读取参数并播种,同时把种子打进日志和波形文件名;回归调度器每个槽位分配不同种子扩大覆盖,失败用例则用日志里记录的那颗种子原样重跑。
initial begin
  int seed = 1;
  void'($value$plusargs("SEED=%0d", seed));
  process::self().srandom(seed);
  `uvm_info("SEED", $sformatf("running with seed=%0d", seed), UVM_NONE)
  run_test();
end
UVM 环境也可借助 +uvm_set_seed 按组件路径播种,但无论用哪条链路,种子都必须出现在日志里、且能从命令行原样回灌。判断实践是否到位只有一条标准:拿到任意一条失败日志,不看人、不翻环境,就能重放出同一个失败。
几个反复出现的坑:种子播得太晚(对象已经 new 完,randomstate 派生过了);fork 之后只给父线程播种,子线程早已各自取种;不同 test 硬编码同一颗种子,回归几百轮其实只测了一条序列;改代码后用旧种子复现旧失败,忽略了取数顺序变化带来的错位。
这一篇在知识体系里的位置
本篇是随机化三篇的收尾:约束怎么写看 CRV 基础篇,分布怎么调看 进阶随机化,本文管「跑出来的序列能不能复现」。种子如何在成百上千轮回归里分配、失败如何分级重跑,则属于 回归管理与失败分流 的话题。
总结
SystemVerilog 随机稳定性的本质是「线程与对象各持一份 RNG、按调用顺序确定性消费」:新增一次随机调用就会让后续序列整体错位,而工程上的解法是在 test 开头用 process::self().srandom 显式播种、回归按 seed 换种子、日志记录种子,让任何失败都能用同一种子稳定复现。