LVF/SOCV 统计时序:三矩模型、Liberty Variation Format 与 POCV 传播精度的枢纽深讲
更新时间:2026-09-30。先进工艺下,「这个反相器延迟是多少」已经不再有一个确定答案——同一颗芯片上相邻两个一模一样的 NAND2,沟道掺杂涨落几个原子,延迟就能差出百分之几。传统的做法是拿一个 derate 系数把这个问题拍平,本站 STA derate 建模与 POCV 入门 讲过这条演进线,MMMC 与 OCV 寄生参数 讲了多角多模式的框架,OCV/AOCV/POCV 辨析 给过三代方法的对比。这一篇往深走一步:当 derate 彻底不够用时,签核工具实际在算什么——答案是统计学。LVF/SOCV 统计时序把每个时序量从「一个数」换成「一个分布」,用 mean、sigma、skewness 三个矩描述它,用 Liberty Variation Format 把它写进库,再用一套传播数学沿路径滚动。看懂这套机制,你才能读懂 PrimeTime 报告里那些 sigma 列,才能判断一条违例路径是「真紧」还是「统计上其实有裕量」。
本文要回答的问题
- 为什么确定性的 derate 系数在先进工艺下必然保守或失真,统计时序解决的根本矛盾是什么?
- mean、sigma、skewness 这三个矩各自对应什么物理意义,偏度为什么不可忽略?
- LVF 在 Liberty 库里长什么样,它和 NLDM/CCS 的标称表格是什么关系?
- POCV/SOCV 沿路径传播 delay 和 slew 时到底在做哪些数学运算,「平方和开根」的假设何时成立?
- 三矩近似的精度边界在哪里,什么场景下它会低估或高估悲观度?
- 签核实战中怎么读统计时序报告、怎么在 derate 与 POCV 之间做方法学取舍?
一、从确定性到统计:derate 为什么走到头了
先回顾问题本身。片上偏差(OCV,On-Chip Variation)指的是同一颗芯片内部、同一时刻,标称相同的晶体管实际表现不同。来源可以分两类:系统性偏差(systematic),比如芯片上的电压降梯度、温度梯度、CMP 造成的金属厚度图形相关偏差,它们有空间结构,理论上可以建模;随机性偏差(random),典型代表是随机掺杂涨落(RDF,Random Dopant Fluctuation)——28nm 以下一个晶体管沟道里只有几十上百个掺杂原子,多一个少一个,阈值电压就漂几毫伏到十几毫伏,这是原子尺度的随机事件,任何版图手段都消除不掉。
OCV 时代的处理方式是给 data path 和 clock path 各乘一个 derate 系数,比如 setup 检查 launch clock 加快 5%、capture clock 放慢 5%。这个方法的隐含假设是「路径上所有单元同时朝同一个方向偏」,也就是全相关。AOCV(Advanced OCV)进了一步:按路径深度(经过几级单元)和物理距离给分档的 derate 表,级数越多随机分量互相抵消得越厉害,derate 就收敛。但 AOCV 的分档表本身还是「系数思维」——它回答的是「这条路该悲观多少」,而不是「这个单元的延迟到底是什么分布」。
真正的转折发生在 16nm/7nm 及以下:RDF 主导的随机分量在总偏差里的占比持续上升,电压降到 0.7V 甚至更低时,延迟对阈值电压的敏感度非线性放大,分布开始明显偏离高斯——低电压下延迟分布拖着一条长尾巴,用「标称值乘系数」描述它,要么在尾巴上保守得离谱,要么在均值附近悲观不足。统计时序的思路是把问题换个提法:不再问「该乘多少系数」,而是给每个时序量直接配上一个分布的参数,让工具在数学上把悲观度「算」出来而不是「拍」出来。这就是 LVF/SOCV 统计时序的出发点。
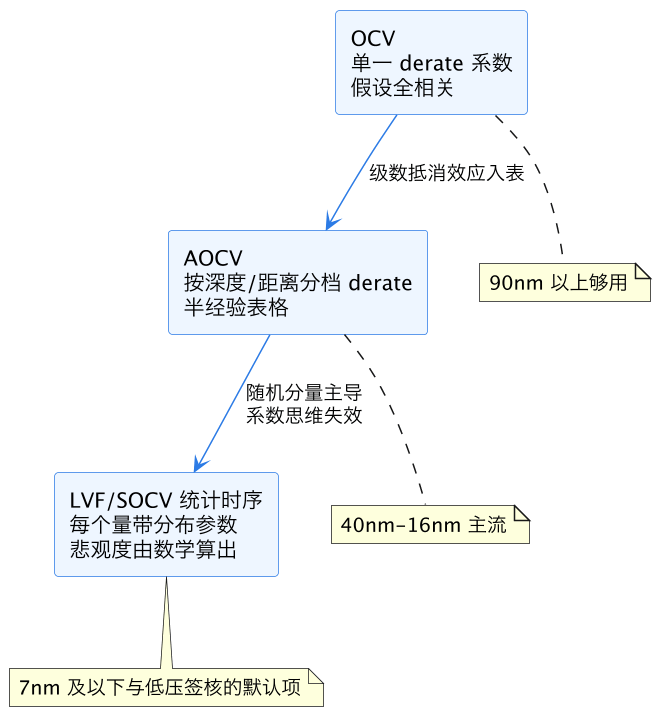
上图是三代方法的演进脉络。注意一个容易误解的点:SOCV 并不是把 AOCV 推翻重来,工程上很多流程是「POCV 管随机分量 + 少量 derate 管残余的系统分量」混用,STA derate 建模与 POCV 入门 里的组合表就是这个思路。理解统计时序的价值,不在于背一个新名词,而在于知道「那个系数」从此有了分布论的依据。
二、三矩模型:mean、sigma、skewness 各自在说什么
LVF/SOCV 统计时序的核心约定是:任何时序量(单元延迟、输出跳变时间、约束值、clock latency)都用一个三参数分布近似,三个参数就是前三个统计矩。
第一个矩 mean(均值),就是分布的中心位置,物理上接近「典型值」但不等于标称库值——标称 .lib 表格查出来的 delay 是某个参考条件下的点值,而 mean 是考虑了偏差源均值偏移后的期望值,两者之间通常有一个小的系统性 offset。
第二个矩 sigma(标准差),衡量分布的散布宽度,物理上对应随机偏差的强度。先进工艺下,一个标准单元延迟的 sigma/mean 比值(工艺上叫变异系数)常在 3% 到 10% 之间,低压单元可以更高。sigma 是整套统计时序里信息量最大的参数:签核工具报路径时序时给出的「延迟 = mean + 3×sigma」这类表达式,就是把「悲观多少」换成了「取分布的几个标准差处」。
第三个矩 skewness(偏度),衡量分布的不对称性。高斯分布偏度为零,左右对称;但低电压下的延迟分布是右偏的——右侧有一条长尾巴,意味着「偶尔会有比均值慢得多的样本」。右偏分布如果只取 mean 和 sigma 两矩来近似,setup 检查会系统性低估悲观度,因为真正危险的是那条被砍掉的长尾巴。这就是三矩模型相比早期两矩统计时序的关键改进,也是 LVF 格式专门为 skewness 留字段的原因。
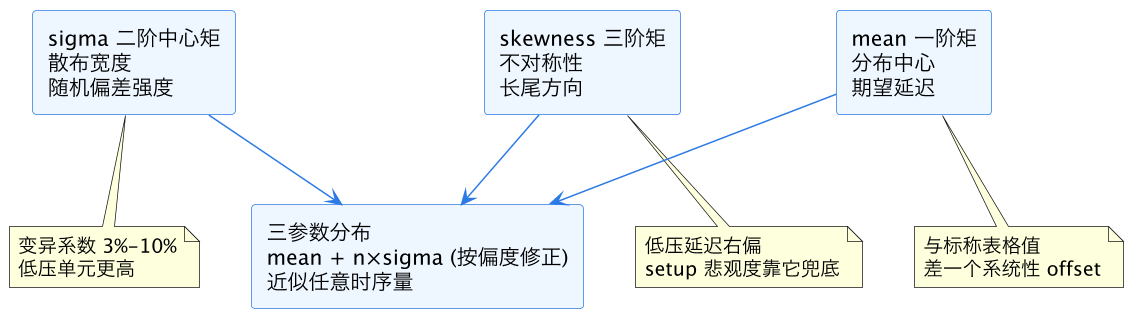
这张图要读的重点是三个矩的「分工」:mean 定位置、sigma 定宽度、skewness 定形状。工程直觉上可以这样记:两个矩回答「平均多快、波动多大」,第三个矩回答「倒霉的时候有多倒霉」。setup 违例看的是延迟分布的右尾,hold 违例看左尾,偏度符号直接决定两侧尾巴的厚度,所以 skewness 不是锦上添花,而是低压签核的必需品。
还有一个数学细节值得记住:矩是可以沿路径做闭合形式传播的,这是选「矩」而不是直接存「分布曲线」的根本原因。一条 30 级的路径,如果每级存一条 1000 点的分布曲线,存储和卷积都不堪重负;而每级只存三个数,传播公式有解析解,一次完整芯片的统计时序分析才可能在一晚上跑完。三矩是精度和算力之间被市场验证过的折中点。
三、LVF:Liberty Variation Format 在库里长什么样
Liberty 格式是时序库的事实标准,本站 Liberty NLDM 与 CCS 时序模型 讲过标称时序信息的组织方式,数据流格式之 Liberty 视图 给过库文件全景。LVF(Liberty Variation Format)是在同一套语法框架下增加的偏差扩展:它不改变标称表格,而是给每个时序弧的 delay、slew(transition)、constraint(setup/hold 的约束值)各配上三个矩,按标称表格相同的查找维度(输入 transition、输出 load)索引。
概念上一个带 LVF 的单元 arc 大致是这样的结构:标称部分照旧是 cell_rise / rise_transition 两张二维表;LVF 部分则多出若干组表——ocv_sigma_cell_rise、ocv_mean_shift_cell_rise(或等价的 mean 偏移表)、ocv_skewness_cell_rise,以及 transition 和 constraint 对应的 sigma 表。每条弧因此携带「标称值 + 均值偏移 + 散布 + 偏度」四组信息。时序工具读库时把四者合成该 arc 的三矩分布:mean = 标称值 + 均值偏移,sigma 与 skewness 直接取表。
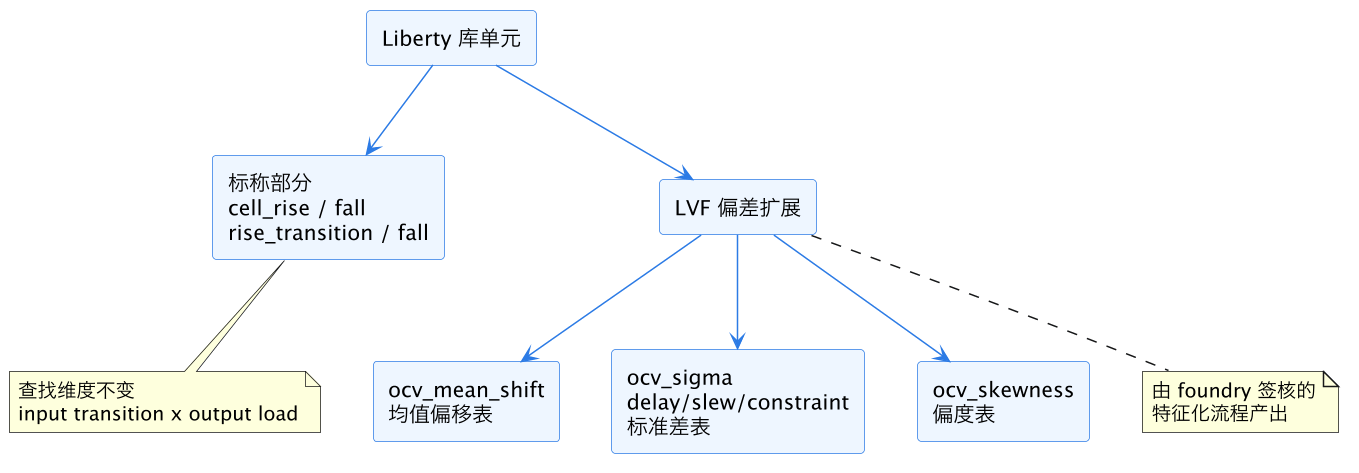
这张结构图里有两个实践要点。第一,LVF 表和标称表共用同一套索引维度,所以工具查表开销只是翻几倍而不是质变,这也是它能进主流程签核的工程前提。第二,LVF 数据不是天上掉下来的——它来自库特征化(characterization)流程:对每个单元做大规模 Monte Carlo SPICE 仿真(成百上千次随机扰动),把延迟样本统计成矩再填表。这意味着 LVF 库的可信度上限就是特征化的采样质量,标准单元 PDK 库视图 里讲的库交付清单,在先进工艺节点上 LVF 视图已经是必查项。
| 库视图 | 回答的问题 | 标称/偏差 | 典型产出方 |
|---|---|---|---|
| NLDM 标称表 | 这个条件下延迟是多少 | 标称 | foundry 或库厂商特征化 |
| CCS 标称表 | 波形形状如何驱动下游 | 标称(含电流波形) | 同上 |
| CCS noise | 串扰毛刺怎么传播 | 标称 | 同上,见 CCS noise 模型 |
| LVF | 延迟分布的三个矩 | 偏差 | Monte Carlo 特征化 |
上表把 LVF 放进库视图家族里看:它是唯一专门回答「分布」问题的视图,和标称视图是叠加关系而非替代关系。没有标称表,LVF 的均值偏移无处附着;没有 LVF,标称表在先进节点下无法支撑低压签核的精度要求。
四、POCV/SOCV 的传播数学:三矩沿路径怎么滚
库里有了每个 arc 的三矩,时序分析引擎要做的事是:从时钟源出发,把 arrival time 的分布一级一级滚到路径末端。Synopsys 体系里这套机制叫 POCV(Parametric OCV),Cadence 体系叫 SOCV(Statistical OCV),数学本质相同,术语和报告格式略有差异,下文统称统计传播。
传播有两个基本运算。第一个是「加」:路径到达时间等于各级延迟之和,和的均值等于均值的和;如果各级偏差相互独立,和的方差等于方差的和——也就是 sigma 按「平方和开根」增长,而不是线性累加。这个区别是统计时序悲观度低于 OCV 的全部数学根源:N 级相同单元串联,OCV 假设悲观度按 N 线性涨,统计时序按根号 N 涨。30 级路径,线性涨是 30 倍单元 sigma,根号涨只有约 5.5 倍——这就是 POCV 相比 flat derate 能省下的裕量。
第二个运算是「max/min」:一个引脚的 arrival 是多个扇入 arrival 取最值,setup 检查本质上是要求 data arrival 的分布与 capture 沿的分布之间保持间隔。两个高斯取 max 没有解析解,工程上用的是矩匹配近似(典型是 Clark 公式一类的方法):先算 max 结果的均值和方差的近似表达式,再把结果拟合回一个三参数分布继续往下游传。偏度正是在这一步开始发挥影响——右偏输入取 max 后偏度会变化,工具必须逐节点维护三矩而不是只维护两矩,否则误差沿路径累积。
slew 的传播同样按三矩滚动,而且不能省:下游单元的延迟查表依赖输入 transition,输入 transition 本身的 sigma 会通过查表映射成延迟 sigma 的一部分(灵敏度传播)。所以 LVF 里 transition 也有 sigma 表,断一环整条链的精度就垮。
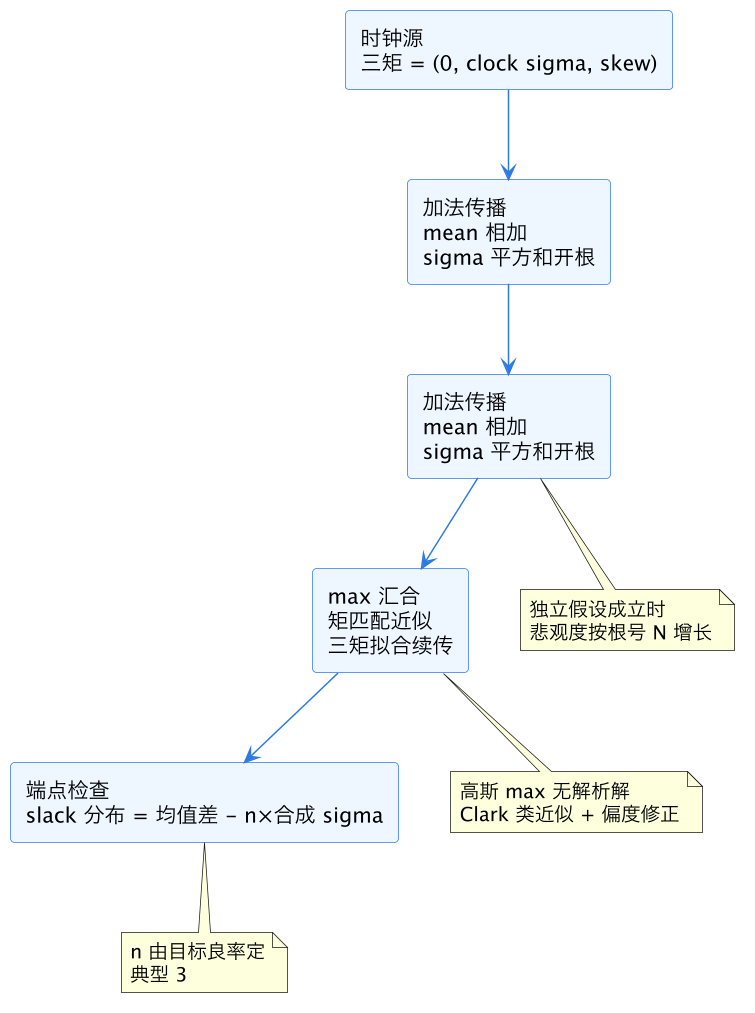
这张图是一条两级后汇合的路径的缩影。读图时盯住两个注记:加法段的「根号 N」是有前提的——各级偏差独立;汇合段的「矩匹配」是有误差的——max 之后分布其实已经不再是精确的三参数族。这两个注记就是下一节精度讨论的入口。
工程上还有一个和传播深度相关的现象值得知道:统计时序天然区分「长路径悲观度被摊薄」和「短路径悲观度下不去」。setup 关键路径往往很长,根号 N 效应显著,POCV 相比 OCV 能省出明显裕量;hold 关键路径往往很短(两三极缓冲器),根号效应帮不上忙,而且 hold 看的是分布左尾,偏度的影响反而更大。所以引入 LVF/SOCV 统计时序后,很多设计会看到 setup 违例数下降而 hold 修复压力变化不大的现象,这不是工具抽风,是数学的必然。
五、精度边界:独立假设、相关性与 CRPR
上一节的「根号 N」有个漂亮的假设:各级偏差独立。现实没这么干净。偏差可以分解为「全芯片共有的分量」和「每级独立的分量」——电压温度梯度、系统性版图效应让全芯片的单元朝同方向偏,这部分方差不能按平方和开根,必须线性累加;只有纯随机分量享受根号待遇。LVF 的 sigma 表建模的主要是随机分量,系统性分量仍需要 derate 或 MMMC 角点来兜底,这就是第一节说「POCV 加少量 derate 混用」的数学原因。
第二个精度来源是时钟公共段的抵消。setup 检查里 launch 和 capture 两条时钟路径有一段是共享的,共享段上的随机偏差对两条路径是同方向的,在做差时应该抵消掉。确定性方法里这叫 CPPR/CRPR(时钟 reconvergence 悲观度移除);统计框架下对应的处理是把公共段的方差从「两条路径方差之和」里减掉协方差项。做得粗糙的工具或老流程会在这里留一笔可观的虚悲观,尤其是深时钟树设计——时钟树有十几级,公共段占了大部分,抵消与否能差出几十皮秒。时钟树的结构背景见 CTS 时钟树综合 和 clock latency 之源与网络延迟。
第三个边界在串扰。信号完整性引起的增量延迟(aggressor 切换窗口对 victim 的推拉)本身是强非线性和强相关的,统计框架对它的处理各家工具不完全一致,通常是先用 SI 引擎算出增量延迟的标称值再叠加一个统计裕量。串扰的基础机制见 STA 串扰 SI 增量延迟。在低电压高密度设计里,SI 增量和 LVF 统计量的交互是报告里最容易被误读的部分。
第四个边界是三矩近似本身。三参数分布族(常用的是移位高斯或类似形式)表达能力有限:真实的延迟分布在极低电压下可能有更复杂的形状,三矩拟合在 3-sigma 以内吻合良好,推到 4-sigma 以外误差明显放大。这也是为什么追求极高良率(large sigma)的存储器、SerDes 等模块不完全依赖三矩传播,而是用 Monte Carlo 或高 sigma 专用分析方法。对标准数字逻辑签核,3-sigma 目标下三矩模型的精度已经被大量硅后相关性数据验证过,可以放心用。
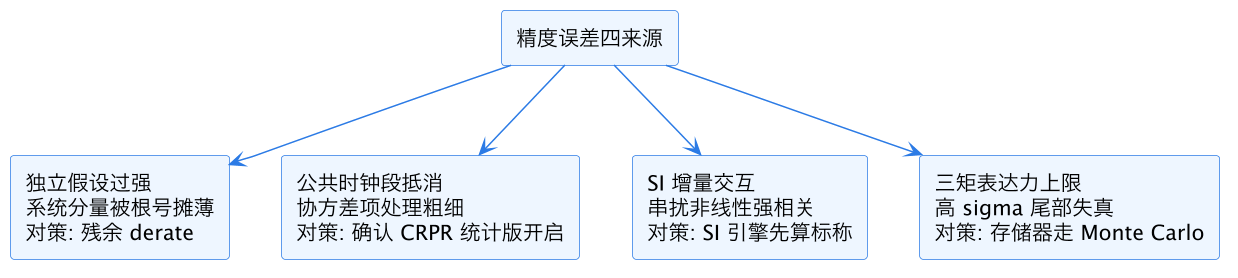
这张图建议存成团队里的签核自查清单:拿到 POCV 报告,先问四个问题——残余 derate 怎么设的、公共段抵消开没开、SI 增量怎么叠加的、目标 sigma 是几。四个答案都对,报告数字才值得信。另外别忘了分析模式的影响:GBA(graph-based analysis)下汇合点直接取最坏 arrival,PBA(path-based analysis)才逐路径重算,统计框架下两者的差距同样存在,STA GBA 与 PBA 分析模式 的取舍逻辑在 POCV 场景里原样适用,只是 PBA 的计算代价更高。
六、签核实战:读报告、配流程、做取舍
把前面五节落到日常工作上,是三件事:读得懂报告、配得对流程、知道什么时候该用什么方法。
读报告。POCV/SOCV 模式下的时序报告,delay 和 arrival 列会拆成均值和 sigma 贡献,路径级 slack 本质上是一个统计量:slack 均值减 n 倍合成 sigma 大于零才算过。看违例路径时,值得多扫一眼各级单元的 sigma/mean 比值——如果某几级单元的变异系数显著高于同路径其他级,它们通常是低驱动强度单元、长沟道低压单元或查表落在大 transition 大 load 角落的单元,优化手段是换驱动、插缓冲或收紧上游 slew,而不是盲目全局收紧约束。Signoff STA 与 PrimeTime 讲的是整体签核环境,统计列的读法可以对照那篇的报告样例。
配流程。引入 LVF/SOCV 统计时序的流程改造点主要有四个:库侧要确认每个签核角点都有对应 LVF 视图(缺一个角点整套方法退回 derate);约束侧要重审残余 derate 的设置,原来覆盖全部偏差的 derate 必须拆成「POCV 管随机」加「derate 管系统残余」,不拆就是双重悲观;模式侧要在工具里显式开启 POCV 并选择矩传播粒度(delay only 还是 delay 加 slew 加 constraint 全传播);报告侧要把目标 sigma、CRPR 处理方式固化进 signoff 检查清单。MMMC 框架下这些设置按角点独立配置,数据流之角点模式与 MMMC 有全局视角。
做取舍。三条经验性结论。其一,电压越低、工艺越先进、路径越长,POCV 收益越大——0.6V 附近的 near-threshold 设计没有统计时序几乎无法收敛,而 0.9V 以上的成熟节点设计,AOCV 常常依然够用。其二,POCV 省的是 setup 悲观度,hold 侧收益有限,hold 修复策略(换单元、插缓冲那套手艺)不用因为上了 LVF 而改方法学。其三,ECO 阶段要保持统计一致性:时序 ECO 改完单元后增量重算必须是 POCV 模式,拿确定性增量去贴统计全量的缝会引入隐性悲观或虚乐观,PR 时序收敛 ECO 和 signoff closure ECO 两篇讲的 what-if 流程在统计模式下同样成立,只是 every what-if 的输入都多了一组矩。
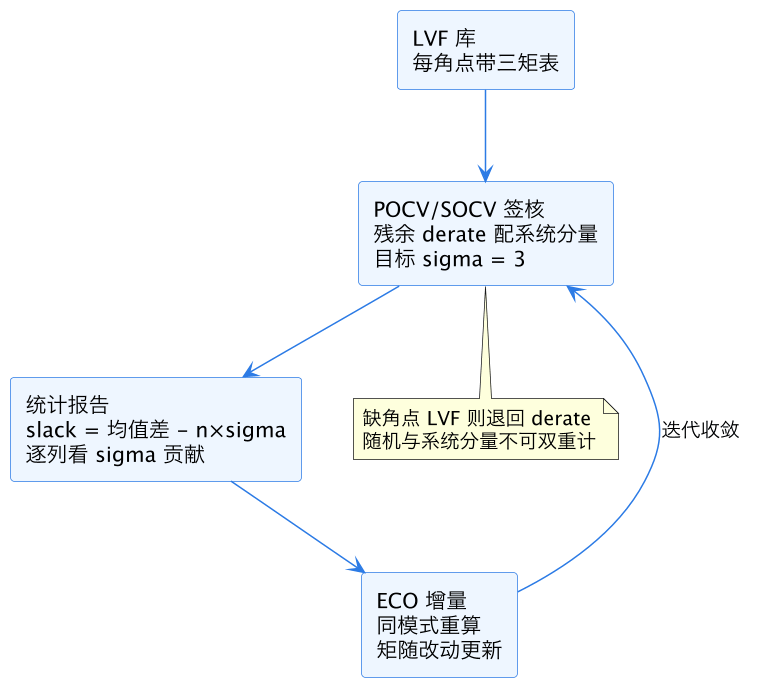
这张闭环图是全篇方法学的落点:LVF 库是输入,统计签核是引擎,报告是产出,ECO 是同模式的回路。四个环节任何一个退回确定性思维,整套统计方法学的收益就漏光了。
最后补一个组织层面的观察:LVF/SOCV 统计时序的推广阻力常常不在工具而在库和流程——LVF 特征化 license 与机时成本不菲,老设计的 signoff 基线切换到统计模式需要重新和 foundry 对良率目标,这些都是项目级决策。技术负责人评估时的算账方式应该是:把当前 derate 方法的总悲观度(可以拿一条典型关键路径,把 derate 乘出来的悲观量和 POCV 根号 N 算出来的悲观量对比)换算成频率或电压裕量,再看这个裕量值不值得换。先进节点上这笔账几乎总是划算的,这也是 LVF/SOCV 统计时序从「可选高级特性」变成「7nm 以下默认项」的原因。
这一篇在知识体系里的位置
本篇是 eda/ 目录下时序签核线的一篇枢纽深文,向上承接 STA derate 建模与 POCV 入门 的方法演进叙事与 MMMC 与 OCV 寄生参数 的框架,横向把库侧(Liberty NLDM 与 CCS 时序模型、CCS noise 模型、数据流格式之 Liberty 视图)、时钟侧(CTS 时钟树综合、clock latency 之源与网络延迟)、分析模式(STA GBA 与 PBA 分析模式)、干扰侧(STA 串扰 SI 增量延迟)串到统计时序这条主线上;向下接签核落地(Signoff STA 与 PrimeTime、PR 时序收敛 ECO、signoff closure ECO)。概念辨析类读者可先读 OCV/AOCV/POCV 辨析 建立坐标系,再回本篇看数学细节;老化等长期可靠性偏差与 LVF 的叠加问题则延伸到 可靠性老化 BTI 与 HCI。
总结
LVF/SOCV 统计时序把每个时序量从确定值升级为 mean、sigma、skewness 三矩分布:LVF 负责把 Monte Carlo 特征化出的三矩写进 Liberty 库,POCV/SOCV 引擎沿路径用「均值相加、sigma 平方和开根、max 汇合做矩匹配」的数学传播悲观度,让 setup 裕量随路径深度按根号 N 而非线性 N 增长;它的精度边界在独立假设、公共时钟段抵消、SI 交互和三矩表达力上限四处,签核实战的纪律是残余 derate 管系统分量、POCV 管随机分量、ECO 与报告全程保持统计模式一致。