融合综合 vs 传统两阶段:Genus-Innovus 与 Fusion Compiler 的流程差异和迁移注意
更新时间:2026-10-07。本篇是物理感知综合专题的流程对比篇:融合的机理与收益上限在 物理感知综合与融合流程 已经讲过「为什么」,本篇回答「怎么选、怎么迁」——融合综合 vs 传统两阶段到底差在哪一层、Genus 加 Innovus 的 iSpatial 与 Fusion Compiler 的统一引擎各自怎么落地、从 DC 加 ICC 老流程迁过来脚本要改哪些地方、迁完发现不达标怎么回退。入门读者可先补 逻辑综合 Design Compiler 建立两阶段流程的基线认知。
本文要回答的问题
- 融合综合 vs 传统两阶段,「融合」具体融合的是哪两个环节,界限划在哪?
- Genus 加 Innovus 的融合流与 Fusion Compiler 的单引擎路线,架构上差在哪?
- 融合带来的 QoR 收益从哪来,量级有多少,代价是什么?
- 从传统两阶段迁移到融合流,脚本、约束、库、团队分工各要动哪些?
- 融合流跑不达标时怎么定位是融合环节的问题,回退路径是什么?
一、两阶段流程的接缝:融合要消灭的到底是什么
传统两阶段流程把「逻辑综合」和「物理实现」切成两个项目:综合工具(DC/Genus 纯逻辑模式)在不知道单元摆在哪的情况下做优化,线长靠 WLM(Wireload Model,线负载模型,一种按扇出查表估线长的统计模型)蒙;物理工具(ICC/Innovus)拿到网表后先布局再优化,发现时序对不上就把问题踢回综合。融合综合 vs 传统两阶段的本质分歧就在这条接缝上:接缝两边各有一套延迟观,谁也说服不了谁。
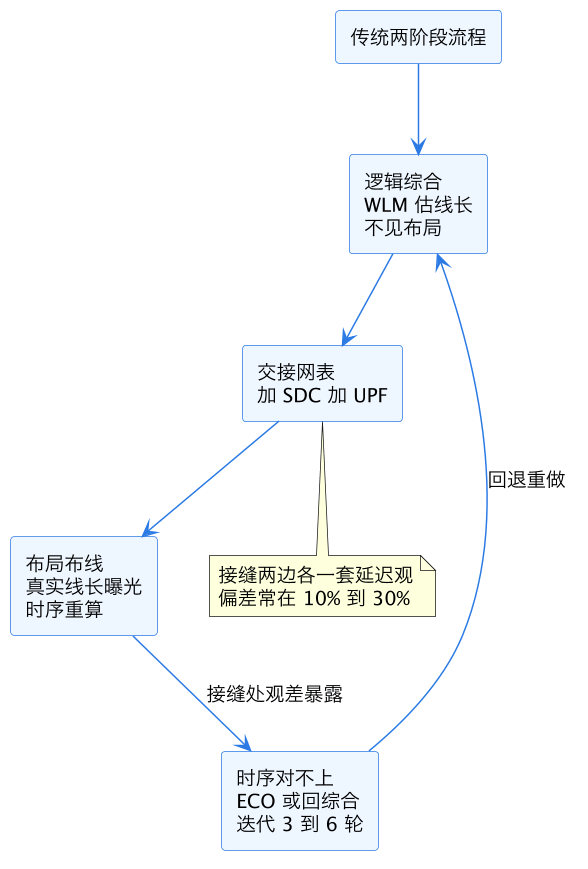
这张图里最关键的是交接那一格。综合用 WLM 估出来的线长和布局后真实走线的偏差,在 28nm 以下节点普遍有 10% 到 30%,局部热点(高密度区、宏单元夹缝)更离谱。综合按偏乐观的线长把驱动能力配小了,布局后全线降档;或者按偏悲观的线长配大了,面积功耗白送。两阶段流程为这条接缝付的学费是迭代轮次:一个 500 万门级别的模块,综合到 PR 再到时序对账,一轮就是两三天,三到六轮是常态。WLM 线负载模型综合 一篇把 WLM 失真的机理讲透了,此处不再展开。
二、融合流的两条路线:iSpatial 双工具协同 vs Fusion Compiler 单引擎
「融合」要消灭接缝,业界走出两条工程路线。Cadence 的 Genus 加 Innovus 走「双工具紧协同」:综合阶段就调用 Innovus 的物理引擎做快速原型布局(iSpatial 技术),综合的每一步优化都看着真实placement 信息做;Synopsys 的 Fusion Compiler 走「单引擎统一数据模型」:综合与布局跑在同一个二进制、同一份数据库里,根本不存在交接文件。融合综合 vs 传统两阶段的讨论落到选型上,其实是这两条路线之间的对比。
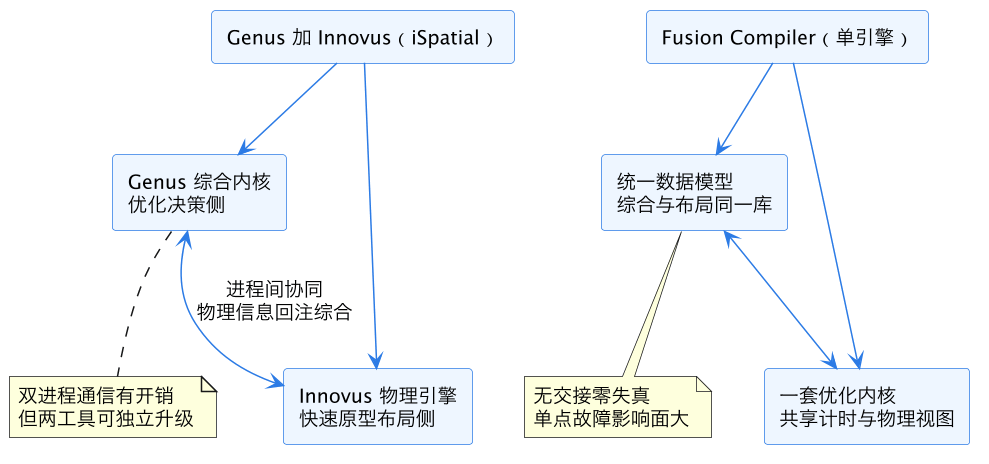
两条路线的取舍很现实。iSpatial 的好处是 Genus 和 Innovus 各自还是成熟独立产品,版本升级、问题隔离、团队技能都按原有边界走;代价是双进程之间有通信与数据一致性开销,原型布局的精度做了折中(要快就不能太精)。Fusion Compiler 的好处是物理视图与综合视图同源零失真,优化颗粒度可以做得更细(比如综合期就按真实拥塞图做重构);代价是所有鸡蛋在一个篮子里——引擎某个 bug 可能同时影响两个阶段,且全家桶绑定 Synopsys 生态更紧。两条路线的共同点是:综合阶段的每一步优化都能看到「接近真实的布局」,接缝被从根上拆掉。
| 对比维度 | Genus 加 Innovus(iSpatial) | Fusion Compiler | 传统两阶段 |
|---|---|---|---|
| 架构 | 双工具进程间协同 | 单引擎统一数据库 | 网表文件交接 |
| 综合期物理信息 | 快速原型布局回注 | 全量物理视图同源 | WLM 统计估计 |
| 工具升级 | 两工具可独立升 | 一体升级 | 可独立升 |
| 厂商绑定 | Cadence 生态 | Synopsys 生态 | 可混搭 |
| 典型 TAT 收益 | 迭代轮次减半 | 轮次减半加单轮提速 | 基线 |
| license 成本 | 两工具各一份 | 融合 license 打包 | 两工具各一份 |
三、QoR 收益从哪来:三笔钱与一个账单
融合流宣称的收益不是玄学,拆开来是三笔具体的钱。第一笔是「不配错驱动」:综合看着原型布局配 cell 尺寸,驱动不足和驱动过剩都减少,典型模块面积省 3% 到 8%。第二笔是「早发现拥塞」:综合期就看到拥塞热图,对结构性拥塞(多扇入汇聚、数据通路交叉)直接做逻辑重构,见 拥塞感知综合重构;两阶段流程里这类问题要到 place 才曝光,那时再改网表结构代价翻倍。第三笔是「少跑轮次」:综合到 PR 的时序观差从两位数百分比压到 5% 上下,迭代轮次从三五轮压到一两轮,对 tapeout 排期这才是最大的钱。
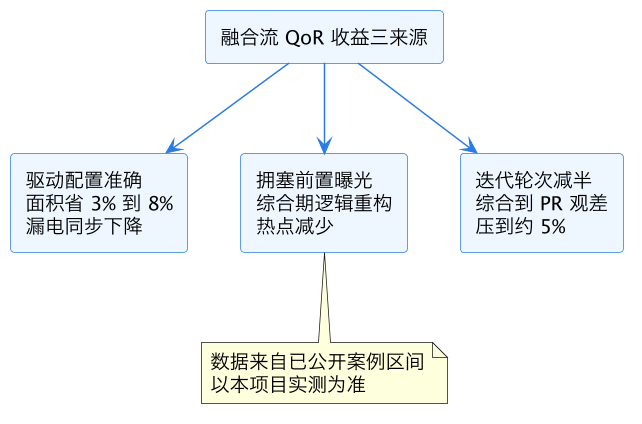
三笔钱的兑现程度因设计而异,有两个结构性前提值得记住。一是模块的「物理敏感度」越高收益越大:宏单元密集、数据通路宽、时钟频率顶格的模块,线长占延迟比重高,WLM 失真在两阶段流程里被放得最大,融合流的红利也最大;反过来,一个低频、低密度、以控制逻辑为主的模块,两阶段与融合的 QoR 差距可能小到不值得折腾迁移。二是收益会被「增量手段」部分对冲:老流程里靠 综合之增量编译流程 反复补跑也能把观差磨下来,融合流的真实增量是「把磨的功夫省掉」,不是「做到了以前做不到的事」——评估收益时对标基线要选对,别拿一个不跑增量的偷懒基线来放大融合的功劳。
账单也要摆上桌。融合流的代价主要是三项:单轮运行时间变长(综合期跑原型布局,单轮多花 30% 到 60% 机时,但轮次少所以总机时通常仍是省的);内存峰值明显上涨(物理引擎常驻,大模块内存需求上浮五成不罕见);license 结构调整(融合特性通常单独计价)。给一组工程水位:一个 300 万门模块在两阶段流下综合加 PR 一轮约 40 小时、平均 4 轮收敛共 160 小时;迁到融合流后单轮约 55 小时、平均 2 轮收敛共 110 小时,总机时省三成,排期省一半——轮次减半省的是「人等机器」的日历时间,比机时更值钱。
四、迁移清单:脚本、约束、库与团队四张表
从传统两阶段迁到融合流,工作量不在「会不会用新命令」,而在把原来分布在两个工具里的隐式约定摆到明处。按四张清单过一遍,漏项率会低很多。
| 迁移域 | 两阶段老做法 | 融合流新做法 | 风险点 |
|---|---|---|---|
| 综合脚本 | compile_ultra 或 Genus 纯逻辑流程 | 开启 physical 模式的融合综合命令组 | 老脚本里的 WLM 设定要清掉 |
| 约束 SDC | 综合一份、PR 一份,人工对齐 | 一份 SDC 全程贯通 | 两份 SDC 的历史漂移会曝光 |
| 物理库 | 综合只读 .db/.lib | 综合就要读 LEF、tech file、floorplan | 库交付节奏要提前 |
| floorplan | PR 阶段才定 | 综合输入就要稳定版 | floorplan 未定前综合结果不可信 |
| 团队分工 | 综合组与 PR 组分段交接 | 一人或一小组贯通综合到 place | 技能要求横跨两个域 |
迁移期最容易踩的三个坑值得点名。一是 SDC 双轨漂移的曝光:两阶段时代综合 SDC 和 PR SDC 各改各的,差出来的部分被接缝吃掉没人发现;融合流一份 SDC 贯通后,这些历史欠账会以「时序突然变好或变坏」的形式冒出来,迁前要先做一次两份 SDC 的 diff 审计。二是 floorplan 依赖前移:两阶段时代综合可以不等 floorplan,融合流的综合质量直接绑死在 floorplan 稳定度上,项目排期要把 floorplan 冻结点提前,数据流 S3 之 floorplan 与布局 的交付节奏要跟着改。三是边界优化策略:融合流里 ungroup 与边界优化的决策有了物理信息加持,老脚本里手工保留层级的约定要重审,见 综合之边界优化与 ungroup。
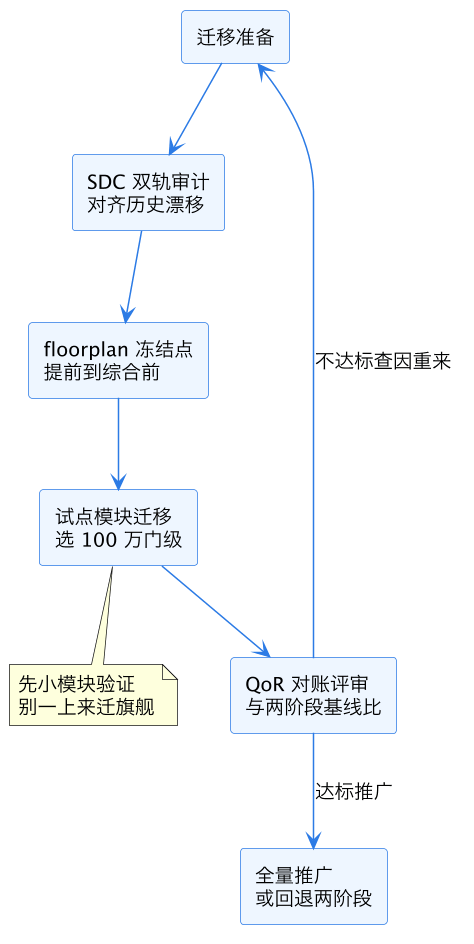
这张迁移路线图里最硬的纪律是「试点先行」:选一个 100 万门级、时序压力中等的模块做首轮迁移,跑出完整的 QoR 对账(时序、面积、功耗、拥塞、轮次五列对照两阶段基线),评审达标再推广。直接拿旗舰模块开刀的团队,大概率在 SDC 漂移和 floorplan 未冻结两个坑里同时翻车。
五、不达标怎么查:融合环节的归责与回退
融合流跑出来的结果不如预期,归责顺序有讲究。先查输入:floorplan 是否冻结后又被改过、SDC 是否真的一份贯通、物理库版本与 PR 侧是否同源——三项里任何一项漂移,融合流的「物理信息可信」前提就没了,表现是综合 QoR 好看但 PR 后依然对不上账,和两阶段的症状一样,容易误判成「融合没用」。再查配置:原型布局的精度档位(快而不精的档位在大模块上会把观差还回来)、拥塞驱动的重构强度(开太猛会把层级打散影响后端 ECO)。最后才查工具本身:把同一网表分别走融合流和两阶段流各跑一遍,对账差值就是融合环节的真实贡献,这个 A/B 实验是归责的终极手段。
归责过程中还有一个高频冤案要提前免疫:融合综合出的网表 PR 后时序变差,第一反应常是「融合综合的网表质量差」,实际查下来多数是 PR 侧沿用了两阶段时代的 setup 裕量设定——两阶段流程里 PR 工程师习惯给综合网表额外压一截不确定度(uncertainty)来吸收接缝观差,融合流观差已经压到 5% 上下,这截人工裕量不撤掉,等于让优化对着一个比签核更严的目标空转,面积功耗全涨。迁融合流后第一轮的纪律是:综合与 PR 的 uncertainty 预算重新切分,接缝吸收项清零,只保留真实工艺与模型不确定度。
回退预案要在迁移第一天就备好,不是失败后才补。融合流的中间产物(门级网表加 SDC)本身格式与两阶段兼容,任何一步不达标都可以切回「融合综合出网表、传统 PR 实现」的混合模式,甚至完全退回两阶段;真正不可逆的是团队节奏——如果全组按融合流排了三个月计划,回退的日历代价远大于技术代价,这正是试点模块先行、评审门禁放行的意义。迭代节奏与收敛判据的通用方法在 时序收敛迭代方法学,融合流只是把其中「综合到 PR」那一环的观差预算收紧了,判据框架照常适用。
这一篇在知识体系里的位置
本篇是物理感知综合专题的落地对比篇:机理前置在 物理感知综合与融合流程,传统两阶段的综合侧基线在 逻辑综合 Design Compiler 与 WLM 线负载模型综合;横向关联 拥塞感知综合重构(融合流收益的第二来源)、综合之边界优化与 ungroup(迁移时要重审的脚本约定)、综合之增量编译流程(融合流内的迭代手段);下游衔接 数据流 S3 之 floorplan 与布局 与 时序收敛迭代方法学。
总结
融合综合 vs 传统两阶段的分歧只有一处:综合与物理实现之间的接缝留不留——两阶段靠网表交接加 WLM 估计,观差 10% 到 30% 拿迭代轮次填;融合流(Genus 加 Innovus 的 iSpatial 双工具协同,或 Fusion Compiler 的单引擎统一库)让综合看着真实布局做优化,观差压到 5% 上下,换来面积省 3% 到 8%、轮次减半,代价是单轮机时与内存上浮、license 重谈。迁移的关键动作是 SDC 双轨审计、floorplan 冻结点前移、百万门级试点模块先行配 A/B 对账;不达标先查输入漂移再查配置档位,融合产物与两阶段格式兼容,回退通道始终开着。