综合拥塞预估:基于 RTL 结构的热点预判、重构手段与物理反馈迭代
更新时间:2026-10-04。布线拥塞(routing congestion)是物理实现里最难收尾的问题之一:等到 全局布线拥塞分析 在布局布线后报出一片红海时,能做的只剩 布局拥塞的 cell padding 这类「挪一挪、挤一挤」的局部手段,治不了根。真正的根往往在更上游——RTL 结构本身决定了局部区域的走线需求量。这一篇讲的是把拥塞问题拦在综合期:怎么只凭 RTL 和门级网表的结构特征就预判哪里会堵,综合工具能用什么重构手段把堵点消化掉,以及怎么用早期物理反馈(physical feedback)做迭代闭环。它是 逻辑综合 Design Compiler 的进阶话题,前置知识是 综合数据交接 和 线负载模型 的局限。
本文要回答的问题
- 为什么在综合阶段(还没有任何版图信息)谈论拥塞是有意义的,结构特征和最终布线拥塞之间的因果关系是什么?
- 哪几类 RTL/网表结构是拥塞的「惯犯」——大 MUX、交叉开关、高扇出网各是怎么制造拥塞的?
- 综合工具有哪些重构手段能在不动功能的前提下降低走线需求,各自的代价是什么?
- 纯结构预估的精度极限在哪里,为什么必须引入早期试布局的物理反馈,反馈闭环怎么搭?
- 工程上怎么定「综合期放行的拥塞标准」,什么样的网表不该丢给 P&R?
一、为什么综合期就能谈拥塞
先看拥塞的本质。布线拥塞 = 某个局部区域的走线需求量超过该区域布线轨道(routing track)的供给量。供给侧由工艺金属层数、间距规则和 Floorplan 与宏摆放 决定,综合期管不着;但需求侧——一个区域里有多少条网、每条网要跨多远——在很大程度上由逻辑结构先天决定。一个 64 选 1 的 MUX,无论怎么摆,64 条数据输入线都要汇聚到选择逻辑的附近;一个 8×8 的交叉开关(crossbar),64 条输入和 64 条输出两两相连,天然就是几百条走线在一个小区域里纵横交错。这类「结构性走线密度」在 RTL 写成的那一刻就定了,布局做得再好也只能摊薄,不能消除。
这就是综合拥塞预估的立足点:布局是拥塞的放大器或缓冲器,逻辑结构才是拥塞的源头。综合工具看到的网表里,多路选择树、总线汇流、扇出上百的控制信号,全都对应未来版图上的走线需求热点。统计上,网表级结构特征(局部扇入汇聚度、Rent 指数、高扇出网数量与分布)和最终布线后拥塞图的相关性已经被大量工程实践证实——工具厂商正是基于这个相关性做综合期的 congestion map 预估。
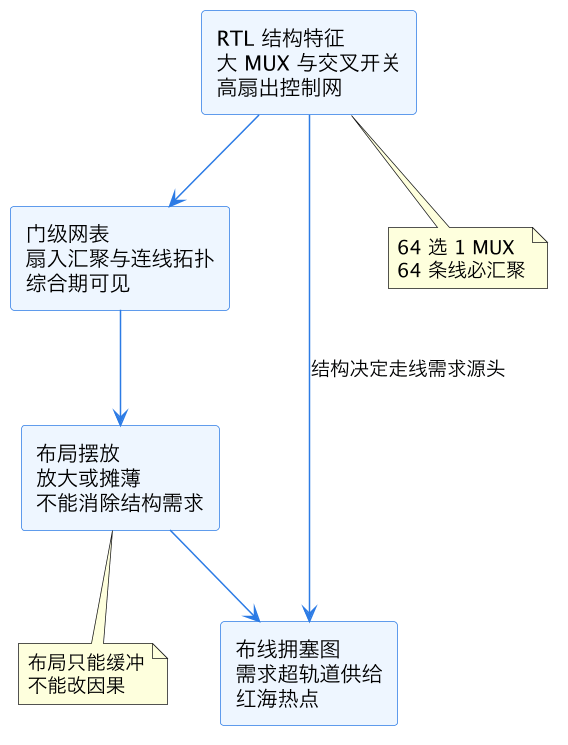
这张图是全篇的因果链:拥塞需求从 RTL 结构一路传导到布线结果,布局只是中间的可调旋钮。读图时盯那条从 RTL 直达拥塞图的斜向箭头——它表示即使布局完美,结构性热点依然会显形;综合期能做的,就是在箭头出发的一端把需求量本身改小。
二、三类结构惯犯:MUX、交叉开关、高扇出网
不是所有结构都等量制造拥塞,实战里 80% 的结构性热点来自三类惯犯。
第一类:大位宽多路选择器(大 MUX)。数据通路里 32 选 1、64 选 1 的 MUX 常见于总线仲裁、寄存器堆读口、重配置逻辑。综合工具默认把 case 语句映射成树状两级或三级 MUX 单元堆叠,64 条数据线在很小的物理区域内逐层汇聚,局部 pin 密度和走线交叉数急剧升高。更糟的是总线位宽叠加——64 选 1 本身已是汇聚结构,如果是 64 位总线的 64 选 1,就是 4096 条数据线的汇聚,任何布局器都救不了。
第二类:交叉开关(crossbar)。NoC 路由、总线矩阵、通道选择器里,N 输入 M 输出全互连,连线数正比于 N×M。8×8 单比特 crossbar 是 512 条连接关系,32 位位宽就是一万六。crossbar 的拥塞特征和 MUX 不同:不是「汇聚」而是「穿越」——大量走线必须水平垂直双向穿过同一块区域,纵横两层金属同时吃紧。
第三类:高扇出网(high-fanout net)。复位、时钟使能、扫描使能、配置寄存器输出,一扇几千。在展开它之前先补一个判断方法:怎么在没有工具报告时从 RTL 里手算热点嫌疑。看代码时盯三个信号——case 语句的分支数乘以位宽(乘积过千基本必热);模块端口里成对出现的大规模输入输出总线(典型的 crossbar 指纹);以及某个寄存器输出在 always 块敏感列表和赋值右侧出现次数异常多的信号(高扇出苗子)。这套肉眼筛查在设计评审阶段就能用,不必等网表。高扇出本身不一定堵(缓冲树会把负载摊开),但它带来两个次生问题:一是缓冲树(buffer tree)在热点区额外吃掉布线资源;二是扇出跨越的物理范围大,每条分支都要走长线,长线占用上层金属,挤占本就紧张的高速总线资源。扫描链重排与时序 那篇提过扫描使能的扇出问题,DFT 结构是高扇出网的大户。
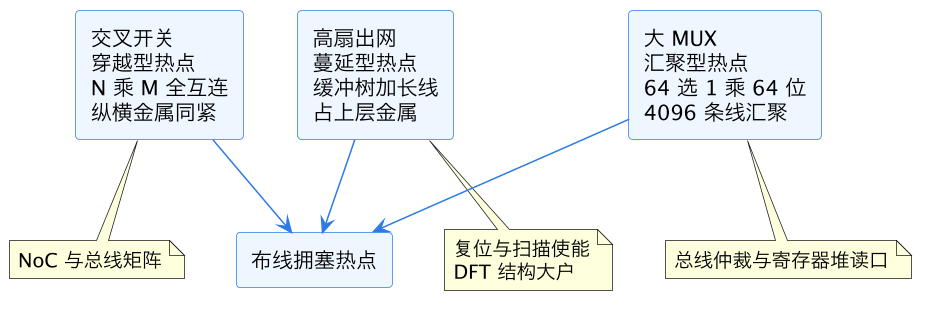
这张图把三类惯犯并排:汇聚、穿越、蔓延,是三种不同的拥塞形态,对应的综合期对策也不同——下一节的重构手段就是按形态对症下药的。
三、综合期的重构工具箱
综合工具(DC 家族的 physical guidance 模式、Genus 的物理感知综合)在不动功能的前提下有一箱重构手段,按三形态对应使用。
对付汇聚型:MUX 结构重构。核心思路是把「物理上必须汇聚的大 MUX」改写成「可以分散实现的选择逻辑」:多级流水线 MUX(在选择路径中间插寄存器,把一级汇聚拆成两级,每级汇聚规模减半,代价是加一拍延迟);独热码重编码(把二进制选择信号改独热,综合工具就能用 AND-OR 结构而非 MUX 树,走线从「扇形汇聚」变成「总线+局部门」,布局友好得多);以及资源分配(resource sharing)——多个分时复用的大 MUX 合并成一个,直接砍掉汇聚点数。这需要在 综合约束 SDC 之外配合工具的 datapath 优化选项。
对付穿越型:层次与接口重构。crossbar 的走线穿越量由互连拓扑决定,综合期能做的是:合理切分层次边界(把 crossbar 收进独立模块、给它预留独立的物理区域,而不是让它的逻辑散落到各主控模块里——后者会让穿越走线遍布全芯片);接口精简(检查是否有实际从未用到的互连通道,功能验证确认后砍掉);以及在允许改架构时把全互连降级成分组互连(8×8 拆成两个 4×4 加一级交换,连线数从 64 降到 40 左右)。
对付蔓延型:扇出预算与缓冲策略前置。给高扇出网设 max_fanout 约束让综合早期就插入缓冲树而不是留到最后;复位树、扫描使能树这类规则结构手工例化平衡缓冲树,比在 P&R 阶段让工具临时长树可控得多;配置寄存器这类「全局广播」信号,可以在 RTL 就改成多份寄存器副本(寄存器复制,register duplication),用寄存器数量换走线长度。所有重构手段的效果和代价都要在 综合 QoR 报告 里逐项核对——降拥塞不是免费的。
| 重构手段 | 针对形态 | 收益 | 代价 |
|---|---|---|---|
| 流水线 MUX 拆分 | 汇聚 | 汇聚规模减半 | 加一拍延迟、面积略增 |
| 独热码重编码 | 汇聚 | 走线变总线加局部门 | 触发器与门数增加 |
| 资源分配合并 | 汇聚 | 汇聚点直接减少 | 时分复用引入控制逻辑 |
| 层次边界收敛 | 穿越 | 穿越走线收进局部区域 | 层次间时序接口变紧 |
| 全互连降分组 | 穿越 | 连线数近半 | 架构改动、需验证 |
| 寄存器复制 | 蔓延 | 长线变多份短线 | 寄存器数与功耗增加 |
四、纯结构预估的极限与物理反馈闭环
结构预估有一个绕不开的盲区:它不知道布局会把逻辑放到哪里。同样一个 64 选 1 MUX,落在芯片中央空地还是落在宏单元夹缝里,拥塞后果天差地别;高扇出网是否跨越大半个 die,取决于物理区域分配。所以现代综合流程不把宝押在纯结构预估上,而是搭一条物理反馈(physical feedback)闭环。
闭环的标准搭法:第一轮综合用物理感知模式跑完,直接做一次「试布局」(quick placement / 早期 global placement,见 全局布局时序驱动 的轻量版本),生成预估拥塞图(congestion map);把热点反标(annotate)回网表——找出落在热点区内的逻辑单元和网,追溯到对应的 RTL 模块;对号入座用上一节的重构手段处理;改完重综合、再试布局,比较两张拥塞图确认热点确实消退,而不是挪了个地方(拥塞重构最常见的失败模式就是把热点从模块 A 挤到模块 B)。一般 2-3 轮迭代收敛,超过三轮还在搬家的热点,多半需要动架构而不是动综合选项。
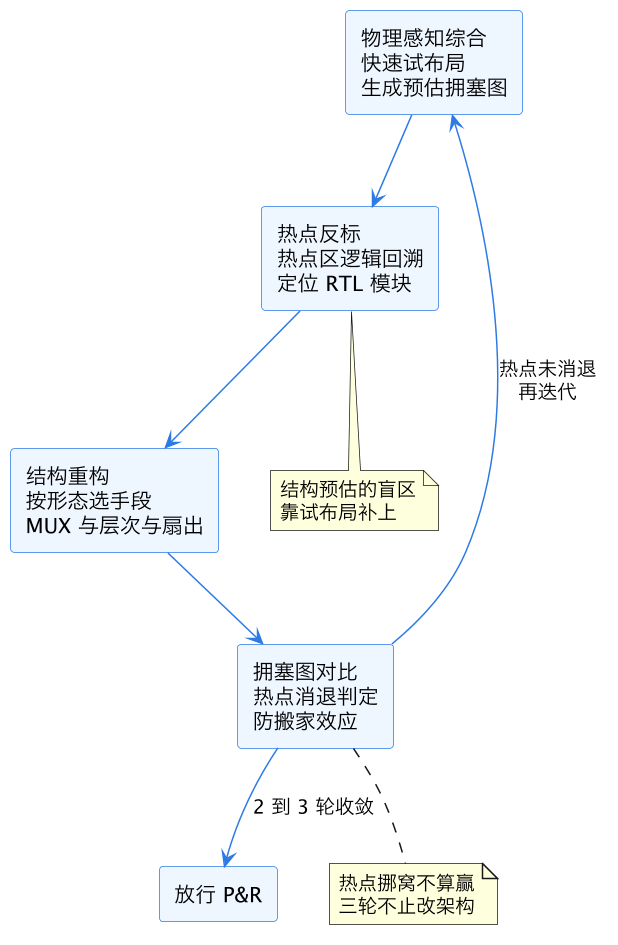
这张图就是反馈闭环的运行图。注意「拥塞图对比」这个节点:闭环的灵魂不是「又跑了一遍」,而是「两张图叠着看」。实战里推荐保留每一轮的 congestion map 截图,把热点坐标和归属模块列成表,逐轮打勾销项——这同时就是给 P&R 团队交接的历史记录,和 数据流 S3 布局布线 的入口检查对齐。
五、放行标准:什么样的网表不该丢给 P&R
最后一节落地成可执行的放行判据。综合交付 P&R 之前,综合拥塞预估侧至少要查四条。第一,试布局拥塞图的溢出率(overflow,走线需求超供给的轨道占比):全芯片均值应贴近零,局部热点区的峰值溢出不超过工艺和工具商给出的经验阈值(常见口径是热点格点溢出边数控制在个位数、且热点总面积小于芯片面积 1% 左右),具体数值以本单位 布线拥塞与 DRC 串扰 的历史收敛数据为准。第二,结构惯犯清单销项:全芯片大于 32 选 1 的 MUX、N×M 大于 64 的 crossbar、扇出大于 500 的网,逐个确认要么已重构、要么有书面豁免(例如延迟不允许插流水)。第三,高扇出网缓冲树已建、max_fanout 违例清零。第四,层次边界与 floorplan 区域对齐:crossbar 类模块已收敛到独立区域,没有「逻辑散养」。
任何一条不过却强行交接,代价会在下游指数放大——P&R 阶段修不动的拥塞最终只有两条出路:要么 拥塞驱动的布局优化 用 padding 硬摊薄,牺牲面积和时序;要么走 时序收敛 ECO 甚至退回 RTL 重综合,损失以周计。综合期花两三天做重构迭代,买的是后端几周的收敛时间,这笔账怎么算都值。
还有一条容易被忽略的组织纪律:拥塞重构往往不是综合工程师一个人能拍板的。插流水线会改延迟、砍互连通道会改架构、寄存器复制会改验证环境——这三类手段都碰功能边界,必须拉设计和验证一起评审,改动记录进 ECO 变更传播 的台账。反过来,「max_fanout 约束、缓冲树前置、层次边界收敛」这类纯实现侧手段,综合工程师可以自主决策、不必逐级请示。把手段按「是否碰功能」分两栏管理,是避免重构卡在审批链上的实用做法。
这一篇在知识体系里的位置
本篇是 eda/ 目录综合线从「时序面积优化」走向「物理可布性优化」的关键一篇。上游接 逻辑综合 Design Compiler 与 线负载模型(解释了为什么纯综合看不见真实走线)、综合约束 SDC 与 综合 QoR 报告(重构手段的载体与验收口径);横向关联 DFT 侧的 扫描链重排与时序(高扇出网大户);下游直连 全局布线拥塞分析、布局拥塞 cell padding、全局布局时序驱动,最终汇入 数据流 S3 布局布线 的交接闸门。读完本篇,看到 RTL 里一个大 case 语句或一张总线矩阵,你应当能条件反射地预判它在 congestion map 上的颜色。
总结
综合拥塞预估的核心逻辑是「布局只能摊薄、结构才决定源头」:大 MUX 制造汇聚型热点、交叉开关制造穿越型热点、高扇出网制造蔓延型热点,三者贡献了大部分结构性拥塞;综合期用流水线 MUX 拆分、独热码重编码、资源分配、层次收敛、互连降级、寄存器复制等手段对症下药,再用「物理感知综合 → 试布局拥塞图 → 热点反标回溯 RTL → 重构 → 两图对比销项」的物理反馈闭环迭代 2-3 轮,交付前按溢出率、结构惯犯清单、高扇出违例、层次区域对齐四条标准放行——综合期两三天换后端几周,这是拥塞问题性价比最高的拦截点。