FPGA 原型验证专题 36:商用原型平台版图——HAPS、Protium 与第三方多 FPGA 板的能力边界与选型
更新时间:2026-09-13。本文是原型外围姊妹系列第十一篇、模块 A(商用平台生态与选型)第一篇。06 原型验证系统全景与文档地图给的是仿真/Emulation/原型三种手段的速度光谱,02 多 FPGA 原型系统 ASIC 分区/TDM讲多片的机制与选型要素;本篇下沉到厂商与产品级:市场上具体有哪几类平台、它们的架构和商业模式如何决定了能力边界,以及怎么按项目选。后续 37 原型/Emulation/仿真选引擎 决策树/多引擎排班讲原型 vs Emulation 的引擎选择,38 国产与第三方原型平台生态 可用性/工具链/迁移成本展开供应链备选,44 自建/购买/租云原型 TCO 模型 盈亏平衡/机会成本算账。
一、为什么平台选型值得单独写一篇
一个中大型 SoC 项目的原型平台投入(板卡+Compiler license+调试 IP+维护)常在几十万到几百万美元量级,一旦选定,分区库、替换库、约束模板、调试脚本、团队经验全部沉淀在该平台上,中途换平台的代价接近推倒重来。更麻烦的是,各家市场材料的参数表看起来都差不多("支持 XX 亿门、XX MHz、XX 块 FPGA"),但这些数字的口径差异极大,不理解架构就无法分辨"纸面容量"和"你的设计真正能跑起来的容量"。选型错误的典型代价:买回来发现割边放不下、编译一轮一周、软件团队等板三个月、调试可见性差到只能点灯。
二、三大类平台的架构谱系
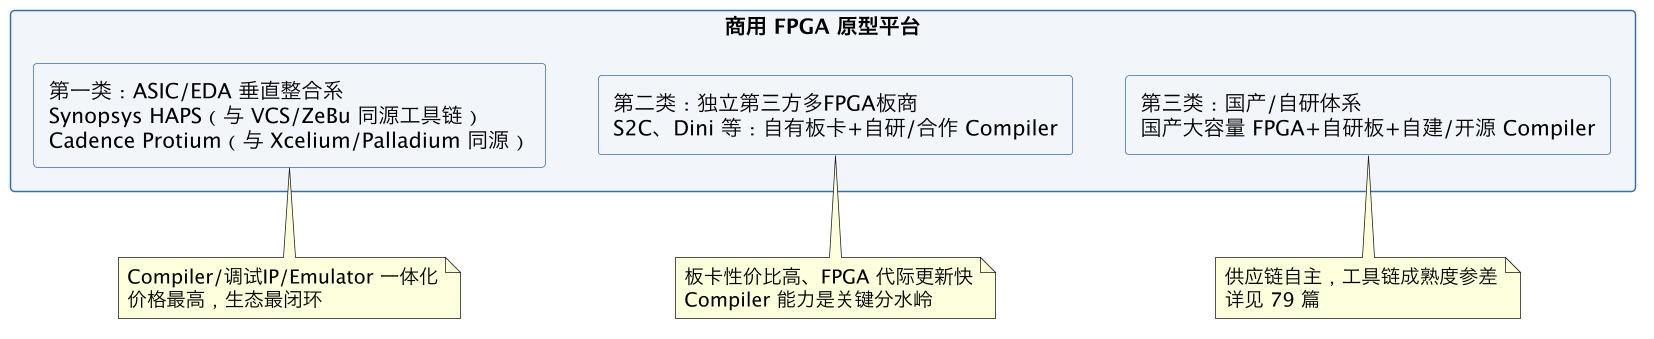
第一类:EDA 垂直整合系(HAPS、Protium)。这类平台的核心卖点不是板子本身——板子用的也是 Xilinx/AMD 或 Intel 的高端 FPGA——而是与该厂商上游验证工具链的一体化:
- Synopsys HAPS:FPGA 原型线,与 Synopsys 的仿真器 VCS、硬件仿真器 ZeBu、HAPS Connect 接口子卡生态、DesignWare IP 模型库同源。其 Compiler(原型综合/分区流程)、调试(Deep Trace 类,见 39 商用原型调试 IP 深跟踪/动态探针/可见性预算)、事务处理器库(SCE-MI/Transactor,26 事务处理器 SCE-MI 三类通道/transactor 实现)成套交付。对已经重度使用 Synopsys 流程的团队,激励模型、覆盖率、事务接口可以在仿真/Emulation/原型三态间复用(41 原型在 SoC 验证矩阵中的定位 用例分配/RACI/证据移交的引擎排班)。
- Cadence Protium:对位产品,与 Xcelium 仿真、Palladium 硬件仿真器、Protium 的分区编译和调试套件一体。它在工作模式上明确区分"协同加速验证模式"(Xcelium 在前,早期、高可见性)和"ICE 独立模式"(后期、跑真软件真接口),两态同一硬件切换——27 在电路仿真 ICE 与协同加速模式 接线/时钟纪律讲的两种模式在这类平台上是产品化的一键切换。
垂直整合系的本质优势是验证环境可移植性:同一个 testbench/transactor/软件镜像能在仿真器、Emulator、原型三档速度/可见性之间滑动,团队不必为每档引擎重写环境。代价是价格最高、且整套体系绑定单一供应商。
第二类:独立第三方多 FPGA 板商(S2C、Dini Group 等)。这类公司以板卡设计能力立身:更大的单板容量、更快跟进 FPGA 新工艺代际、更密的板间互联、丰富的接口子卡库(34 以太网/USB/MIPI 外设接入 子卡生态/等时实时性讲的 daughter card 生态很多来自这类厂商)。它们搭配自研或合作的原型 Compiler。选型时的关键认知是:板卡人人能买高端 FPGA 来做,真正的分水岭是 Compiler——分区质量、割边自动 TDM、替换库完备度、调试可见性(80 篇)。同一批 FPGA,不同 Compiler 跑同一个设计,可达频率和编译周转可能差出一倍以上。这类平台通常性价比明显更高、商务更灵活,适合有一定自研能力、不想被单一 EDA 体系锁定的团队。
**第三类:国产/自研体系。**国产大容量 FPGA + 自研原型板 + 自建或开源 Compiler 的路线,在供应链自主诉求下快速发展。其现状、差距与迁移成本由 38 国产与第三方原型平台生态 可用性/工具链/迁移成本专门展开,这里只强调选型判断框架与前两类相同(Compiler 和调试能力决定可用性,而非单板门数标称值)。
三、五个维度的产品级对比
理解了谱系,看平台时按下面五个维度逐一核实,而不是只看门数:
| 维度 | 要问的真实问题 | 常见市场话术陷阱 |
|---|---|---|
| 有效容量 | 我的设计(含替换后的 SRAM/DSP/时钟)综合后占多少 LUT/FF/BRAM,留 20~30% 余量后需要几片? | "单板 XX 亿门"按最密 ASIC 门标称,不含调试插桩和 TDM 开销 |
| 可达速度 | 用与我相似割边规模的参考设计,实测 DUT 系统时钟多少 MHz?跨片比是多少? | "高达 XX MHz"是无跨片/微设计的理想值 |
| 编译周转 | 从 RTL 改动到可下载比特流,全流程多少小时?能否增量/并行综合/只重编受影响片? | 只报综合时间,不含分区、实现、多片串行 P&R |
| 调试可见性 | 能看多少信号、多深、是否免全量重编译插探针?跨片信号可见吗(39 商用原型调试 IP 深跟踪/动态探针/可见性预算)? | "全信号可见"实际要重编译且深度极浅 |
| 接口生态 | 我需要的 DDR/PCIe/MIPI/网络子卡是否现成(72~75 篇)?自研接口能否接? | 接口子卡清单长但不含我要的那几类 |
此外还要看两个"软"维度:替换库/IP 模型库的完备度(常见 DDR 控制器、PHY、模拟 IP、时钟结构有没有现成替换模型,直接决定平台准备期长短,对应 11 ASIC→FPGA 等价单元替换 SRAM/时钟/IO/PHY)和团队学习曲线/厂商现场支持响应(第一次分区失败时有没有人当天到场)。
四、为什么平台往往锁死自家 Compiler
第一次做选型的团队常问:能不能买 A 家的板子、用 B 家的 Compiler?绝大多数情况下答案是否定的,原因不在商务壁垒,而在深度技术耦合:
- **板级互联拓扑是 Compiler 的分区约束输入。**两片 FPGA 间布了多少对差分线、走哪几个连接器、SerDes 通道怎么连、时钟网络如何分布——这些物理拓扑(35 多 FPGA IO 引出与引脚规划 连接器/电平/SI/取舍讲的引脚/互联账)是分区算法决定割边落点、TDM 通道映射的硬约束。Compiler 必须精确知道目标板的互联数据库,换块板分区结果就不成立。
- **TDM 通道与时钟/复位编排是配套 IP。**跨片 TDM 的物理层、同步、时钟停插逻辑(13 跨 FPGA 互联与 TDM SerDes/跨片同步/降频)是 Compiler 自动插入的,其协议和板级连线绑定。
- **调试 IP 要埋在综合/分区流程里。**探针、交叉触发、trace 网络(14 可观测性插桩 dont_touch/probe/可见性预算、81 篇)必须在网表阶段插入并占互联资源,是 Compiler 流程的一部分。
- **时序/约束模板与板卡对应。**I/O 标准、bank、时序例外模板按具体板卡预置。
所以"板子 + 通用 Compiler"在多 FPGA 原型领域基本不存在(单 FPGA 原型或完全自研 Compiler 另说)。选平台就是选"板卡 + Compiler + 调试 IP + 替换库 + 接口子卡 + 厂商支持"这一整套捆绑,比价时必须按整套比,不能只比单板价格。
五、按项目特征匹配平台
选型不是选"最好的",而是选"与项目特征最匹配的"。给四类典型项目的倾向:
- 超大规模 SoC、软件协同和 ICE 是主诉求、已重度使用某 EDA 厂商流程:倾向垂直整合系,仿真/Emulation/原型环境复用的收益能覆盖高价;37 原型/Emulation/仿真选引擎 决策树/多引擎排班会量化这一点。
- 中大设计、预算敏感、团队有 FPGA 自研能力、需要大量专用接口子卡:第三方板商 + 其成熟 Compiler 往往性价比最高,但务必用自己的真实设计做 benchmark(见下节)。
- 供应链自主是硬约束、或需长期沉淀自有原型能力:国产/自研路线,接受工具链成熟度差距并用工程能力补(79 篇)。
- 一次性、短期峰值需求、不愿沉淀硬件资产:先看租用/云原型(44 自建/购买/租云原型 TCO 模型 盈亏平衡/机会成本),而不是买板。
容量与扩展节奏也要匹配:不仅看当前设计规模,还要看项目周期内设计会不会涨(RTL 迭代加功能、换更大代际工艺)、要不要多板并联。选型时预留一代余量,避免项目中期被迫加板却发现同型板停产/互联拓扑不兼容。
六、选型阶段必须做完的动作与问题清单
**1) 用你自己的设计做 benchmark,而不是看 PPT。**把一份有代表性的(规模和割边数接近最终设计的)网表交给 2~3 家候选厂商,要求在其平台上实测:实际占用 FPGA 数、综合+分区+实现总时长、DUT 实测频率、能同时观测的信号数和深度。这是识破标称值的唯一办法。有条件让厂商现场跑 bring-up demo(点灯到跑一段真实固件,呼应 29 固件 shift-left RTL 冻结前 bring-up/驱动开发)。
2) 向供应商要清楚的问题清单:
- 替换库覆盖我用到的这些具体 IP/PHY/存储型号吗?缺的怎么办、谁开发、多久?
- 编译器对我的黑盒/层次结构/时钟结构有什么硬性限制(07 面向原型的 RTL 交付规范 层次/黑盒/电源域)?
- 分区不收敛/割边超了,工具给什么反馈,需要多少手工干预?
- 动态插探针是否免全量重编译?跨片信号、门级信号能不能看(80 篇)?
- 接口子卡的速率适配保真边界(72 篇):哪些能代表真实时序、哪些只能验功能?
- License 模式:按座位/并发/时间?编译和运行是否分别计费?调试 IP 是否另售(44 自建/购买/租云原型 TCO 模型 盈亏平衡/机会成本算总账)?
- 板卡供货周期、备件、返修 SLA、停产与换代承诺(34 以太网/USB/MIPI 外设接入 子卡生态/等时实时性同理)。
- 出口管制/供货合规对我的多站点布局有无限制(F5 主题,见规划)。
**3) 评估团队与支持。**问厂商要同规模、同行业的参考客户并私下交流;评估现场支持团队的规模和响应时间;估算自己团队需要多长培训才能独立跑通一次完整构建。
七、一个 benchmark 实测记录长什么样
光说"带自己的设计实测"还不够,给一份可以直接照抄的 benchmark 记录表,评审时按行填数、不同厂商同表横向比:
| 记录项 | 为什么要记 | 单位/口径 |
|---|---|---|
| 输入设计版本 | 保证三家跑的是同一份网表(含黑盒/SRAM 清单) | git hash + 综合后网表 |
| 实际占用 FPGA 数 | 标称门数无意义,数片数和每片利用率 | 片;每片 LUT/FF/BRAM 峰值占用率 |
| 最高占用率 | 超过 80~85% 后期插探针/加功能就放不下(F1 主题) | %,留 20~30% 余量 |
| 割边总数与剩余互联余量 | 决定频率,也决定还能不能加跨片信号 | 割边数/物理通道数,剩余比例 |
| TDM 比 | 直接量化跨片代价(13 跨 FPGA 互联与 TDM SerDes/跨片同步/降频) | 最坏/平均 TDM 比 |
| DUT 实测系统时钟 | 不是工具标的上限,是该设计实际收敛频率 | MHz |
| 全流程构建耗时 | 干净构建 + 一次小改增量构建分别测 | 小时:分,分段(综合/分区/实现) |
| 手工干预次数 | 自动分区不收敛时工程师介入几处 | 处;每处耗时 |
| 调试演示 | 现场复现 80 篇那个"死锁→深 trace→跨片定位" | 深度/换点耗时/是否重编译 |
| 接口 bring-up | 指定一类真实子卡(如 PCIe 或 MIPI)从连好到互通 | 天;卡在哪 |
| 报价拆分 | 板/Compiler/调试 IP/子卡/年维护/现场服务分列 | 三年 TCO(44 自建/购买/租云原型 TCO 模型 盈亏平衡/机会成本) |
三个容易被演示手法美化的点要特别盯:其一,厂商可能替你预先手工优化分区才报出好看的频率——要求说明分区自动化程度、把网表随机改 5% 后重跑一次;其二,频率可能是在关掉调试插桩的裸网表上测的——要求带探针重测;其三,构建耗时只报综合不报多片串行实现——要端到端墙上时间。把这三行单列,benchmark 就不会被 PPT 化。
八、合同与谈判中容易漏掉的非技术条款
技术 benchmark 打平之后,决定三年体验的往往是合同条款。选型阶段就应把下面几条谈清楚并写进协议:
- 工具缺陷的响应与修复时限:Compiler/调试 IP 的缺陷按严重度分级约定响应时间(如阻断性问题 X 个工作日内给 workaround),并保留若干"修复积分"或服务额度;口头承诺的"下个版本修复"不具约束力。
- 替换库/新 IP 的补齐义务:把你的设计里尚未覆盖的具体 IP/PHY/存储型号列成附件,约定谁开发、交付节点、逾期罚则——这是国产/第三方路线最常延期的一项(38 国产与第三方原型平台生态 可用性/工具链/迁移成本)。
- License 的弹性条款:项目高峰期的临时并发数、license 借用(离线/异地)、并购或组织调整后的转让权、停用后已生成比特流/数据库的继续使用权;编译、运行、调试分开计费时要求给出三年费用上限(cap)。
- 供货与停产承诺:板卡备件供应年限、末次采购(last-time-buy)通知期、同互联拓扑的兼容升级路径,避免项目中期加板时被迫换平台重分区(76 篇)。
- 数据与现场支持边界:厂商现场支持是否能进保密区域、远程支持要不要传网表/比特流、是否接受只给复现脚本不给 RTL 的排障方式(G3 保密主题)。
- 验收款与里程碑挂钩:把 benchmark 表的关键指标(片数、带探针频率、调试演示、子卡互通)写成验收条件,尾款在现场验收通过后支付——这是防止"PPT 平台"最有效的一条。
九、常见坑速查
- 只按单板门数比价,买回来割边放不下/频率达不到 → benchmark 用自己的设计;
- 把平台当标准品买,忽视 Compiler 和替换库 → 锁死的是整套体系;
- 不留容量余量,项目中期设计增长被迫换板 → 预留一代;
- 忽视调试可见性,等 bring-up 才发现跨片信号看不见 → 把 80 篇问题写进招标;
- License 只算编译不算调试 IP/接口子卡/运行时 → TCO 按整套全周期算(85 篇);
- 只听销售、不联系参考客户 → 私下问"你们最痛的三件事"。
与系列及现有篇目的链接
- 引擎级决策:37 原型/Emulation/仿真选引擎 决策树/多引擎排班
- 国产/第三方与迁移:38 国产与第三方原型平台生态 可用性/工具链/迁移成本
- 成本模型:44 自建/购买/租云原型 TCO 模型 盈亏平衡/机会成本
- 平台机制底座:06 原型验证系统全景与文档地图、02 多 FPGA 原型系统 ASIC 分区/TDM、12 多 FPGA 分区算法 割集/容量/图划分、13 跨 FPGA 互联与 TDM SerDes/跨片同步/降频
- 调试与接口能力:39 商用原型调试 IP 深跟踪/动态探针/可见性预算、31 速率适配器 Speed Adapter 弹性FIFO/两种范式、35 多 FPGA IO 引出与引脚规划 连接器/电平/SI/取舍
总结
一句话总结:商用原型平台分三类——Synopsys HAPS、Cadence Protium 这类 EDA 垂直整合系(卖的是仿真/Emulation/原型三档引擎共用同一套 transactor、testbench、覆盖率与软件镜像的环境可移植性,价格最高、绑定最深),S2C/Dini 这类独立第三方多 FPGA 板商(板卡容量大、跟进 FPGA 代际快、接口子卡丰富、性价比高,但真正分水岭是其 Compiler 的分区/TDM/替换库/调试能力而非单板门数),以及国产/自研体系(79 篇专讲);评估时不能看"单板 XX 亿门、高达 XX MHz"的标称,而要用自己规模和割边数接近最终设计的真实网表做 benchmark,逐维度核实有效容量(留 20~30% 余量后用几片)、可达速度(相似割边的实测频率与跨片比)、编译周转(全流程小时数而非只算综合)、调试可见性(信号数/深度/动态插探针是否免全量重编译/跨片可见性)、接口子卡与替换库完备度,外加 license 模式和现场支持;平台之所以锁死自家 Compiler 不是商务壁垒而是技术耦合——板级互联拓扑是分区约束、TDM 物理层与时钟复位编排是自动插入的配套 IP、调试 IP 要埋进综合分区流程、时序约束模板按板预置,所以选平台本质是选"板卡+Compiler+调试 IP+替换库+子卡+支持"的整套捆绑,比价必须按整套全周期 TCO(85 篇)而非单板价;匹配上,超大设计且已重度使用某 EDA 流程、以软件协同 ICE 为主的选垂直整合系,预算敏感又有自研能力、需要大量专用接口的选成熟第三方并务必现场 benchmark,供应链自主是硬约束的走国产自研并接受用工程能力补工具链差距,短期一次性需求先看租用/云,且容量要预留一代避免中期换板;招标阶段必须问清替换库对具体 IP 的覆盖、编译器对黑盒/时钟结构的限制、分区不收敛的反馈与手工干预量、跨片门级信号可见性、速率适配的保真边界、license 是否拆分计费、供货与停产承诺,并私下联系同规模参考客户问"最痛的三件事",才能避开"按门数买回来却割边放不下、编译一轮一周、软件团队干等三个月"这类本可预防的选型事故。