SV 场景随机化分层:合法/非法/边界场景生成、场景库与权重选择
更新时间:2026-09-28。在 约束随机验证方法学 里,我们解决了「单笔事务怎么随机」的问题:
rand字段加约束,randomize()一把梭。但真实验证跑下来会发现,只随机单笔事务远远不够——协议违规、背靠背 burst、复位打岔这类 bug 藏在「事务与事务之间的关系」里,也就是场景层。这一篇讲 SV 场景随机化分层:怎么把激励组织成合法、非法、边界三层场景,怎么用场景库和权重选择调度它们,以及如何用覆盖率数据反向调权。
本文要回答的问题
- 为什么说「事务随机」不等于「场景覆盖」,两者的差距在哪里?
- 合法、非法、边界三类场景各自怎么定义、怎么生成?
- 场景库怎么组织,virtual sequence 在其中扮演什么角色?
- 权重选择怎么设,跑回归时如何按覆盖率反馈动态调整?
- 场景分层和覆盖率模型如何闭环,避免随机激励空转?
一、从事务随机到场景随机:差的那一层是什么
约束随机的基本功是 randomize() 一个 transaction:地址落在合法区间、burst 长度符合 AXI 的 1-256、字节使能与对齐匹配。这层随机在 constraint、inside 与 dist 权重 里已经讲透。但把一万笔各自合法的事务串起来,得到的往往是「一万次重复的正常操作」——每笔都是合法写后跟合法读,地址平滑分布,时序不紧不慢。
Bug 不住在这里。真实项目里翻出来的缺陷,大多符合下面的画像:写正在进行时来了复位;两个 master 在同一拍抢同一个从设备;burst 在边界地址 0xFFF 处跨页;FIFO 深度恰好打满的那个周期 valid 撤了。这些事件的共同点是:它们由「多笔事务之间的时序与组合关系」构成,单笔事务的约束表达不出来。这就是场景层要管的事。
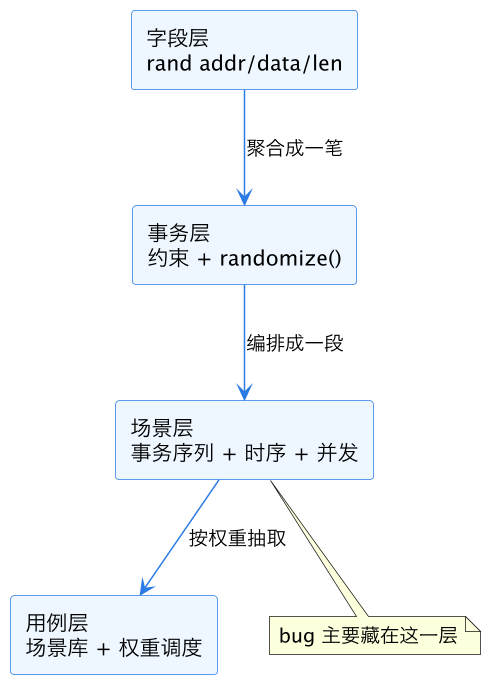
上图是激励的四层金字塔。字段层和事务层由 SV 语言机制直接支持,场景层和用例层没有内建语法,靠的是 sequence 编排加一套自己的组织方法——也就是本篇说的「分层」。分层的价值不只是覆盖面,还有可维护性:新增一个协议分支场景,只往库里加一个类,不动已有用例。
二、三层场景:合法、非法、边界的定义与生成
场景分层的经典切法是把场景库按「与协议规范的距离」分成三层,每层的生成手段和预期检查结果都不同。
合法场景层:完全在协议规范内活动,追求参数组合的广度。比如 AXI 环境里遍历所有 burst 类型 × 长度 × 对齐方式的组合,或者让读写以不同比例交织。生成手段就是常规 sequence 里 randomize() seq_item,约束保证合法。这一层的目标是验证 DUT 在所有正常输入下功能正确,检查靠 scoreboard 自动比对。
非法场景层:故意违反协议,验证 DUT 的错误处理路径。比如送出超过最大长度的 burst、在 reset 生效期间拉起 valid、发送保留编码的命令字。生成手段有两种:一是写专门的 error sequence,用 constraint_mode(0) 关掉合法性约束再叠加错误约束;二是在合法事务生成后,用回调在驱动前注入错误(如 corrupt 校验和)。这一层最容易踩的坑是忘了告诉 scoreboard「这是故意的」——必须配套 error predictor 或把该段事务标记为预期报错,否则 scoreboard 会把正确的错误响应当 failure 报出来。
边界场景层:合法但踩在规格书的临界值上。地址跨页、计数器回绕、FIFO 深度恰好等于 outstanding 上限、两个事件同拍发生。工程经验里边界层的缺陷密度往往最高,因为 RTL 里的 off-by-one 和临界时序路径都蹲在这里。生成手段是把约束的权重向边界值倾斜,或者干脆写定向场景类(如 cross_page_write_seq),让随机只在边界附近的邻域内游走。
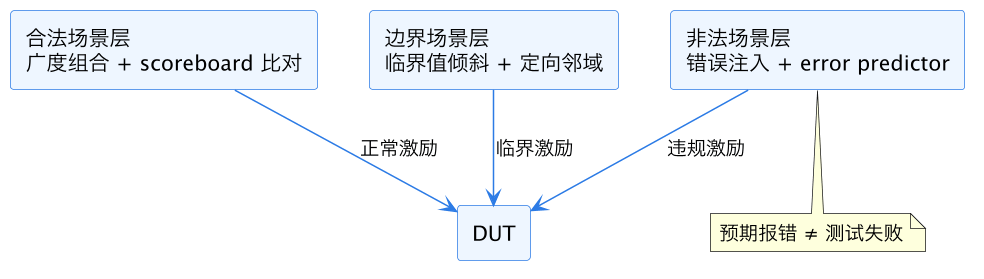
三层之间不是互斥的用例划分,而是同一场景库里并存的三类条目。一次回归里三层都在跑,区别只在被抽中的频率——这就引出了下一节的选择机制。
三、场景库的组织:sequence 类族谱与 virtual sequence
场景库的物理载体是一组 sequence 类。组织原则是:每个可独立复用的场景片段一个类,基类抽取公共参数,virtual sequence 负责把片段编排成完整剧情。
class axi_base_seq extends uvm_sequence #(axi_txn);
  rand int unsigned txn_count = 20;
  rand bit [31:0]   base_addr;
  constraint c_addr { base_addr[11:0] == 0; }  // 默认 4KB 对齐
  task body();
    repeat (txn_count) begin
      axi_txn tx = axi_txn::type_id::create("tx");
      start_item(tx);
      if (!tx.randomize() with { addr inside {[base_addr : base_addr+32'hFFF]}; })
        `uvm_fatal("RAND", "randomize failed")
      finish_item(tx);
    end
  endtask
endclass

class axi_cross_page_seq extends axi_base_seq;   // 边界场景
  constraint c_addr { base_addr[11:0] == 12'hFF0; }  // 故意贴页边
endclass

class axi_illegal_len_seq extends axi_base_seq;  // 非法场景
  task body();
    axi_txn tx = axi_txn::type_id::create("tx");
    start_item(tx);
    tx.len_c.constraint_mode(0);                  // 关合法约束
    if (!tx.randomize() with { len > 255; })
      `uvm_fatal("RAND", "randomize failed")
    tx.expect_error = 1;                          // 通知 scoreboard
    finish_item(tx);
  endtask
endclass
virtual sequence 在多个 agent 的 sequencer 上调起这些场景片段,制造「跨接口的场景」:比如 CPU 接口发起配置写的同时,数据接口正在跑背靠背 burst——两个 agent 各自只看到自己的事务流,剧情由 virtual sequence 在更高层编排。virtual sequence 与组件层的关系见 UVM 组件与 phase,sequencer/driver/scoreboard 的协作细节见 sequence 与 driver/scoreboard 协作。
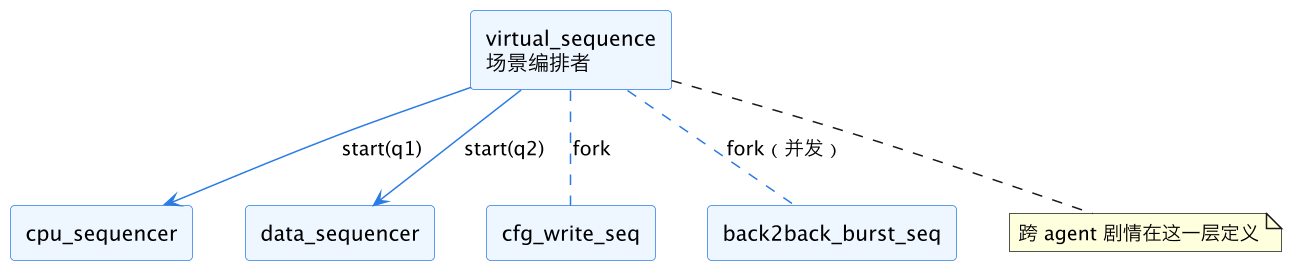
图中的 fork 是关键:virtual sequence 里两条分支并发启动,配置写与数据 burst 在时间上重叠。单 agent 视角永远造不出这种重叠,这正是场景层存在的理由。
四、权重选择:场景被抽中的概率怎么定
场景库建好之后,每次仿真从库里抽哪些场景、各抽多少次,靠权重控制。最简单的做法是 $dist 或在 test 层用一个 case 加权随机:
typedef enum {LEGAL, EDGE, ILLEGAL} scen_kind_e;
function scen_kind_e pick_kind();
  rand int unsigned w;
  scen_kind_e k;
  void'(std::randomize(w) with {
    w dist { [0:69] := 1, [70:89] := 2, [90:99] := 3 };  // 合法:边界:非法 ≈ 7:2:1
  });
  case (w) inside
    [0:69]  : return LEGAL;
    [70:89] : return EDGE;
    default : return ILLEGAL;
  endcase
endfunction
权重的经验起点是:合法场景占大头(六成到七成),因为广度组合需要大量样本;边界场景两到三成;非法场景一成左右——非法场景的单次检查价值高,但跑多了会把 regression 时间耗在已验证过的错误路径上。这只是起点,不是结论。权重应该是覆盖率的函数,不是拍出来的常数:某个 covergroup 的 cross bin 长期打不满,说明对应场景的抽取概率太低或约束根本放不开,前者调权,后者改约束。
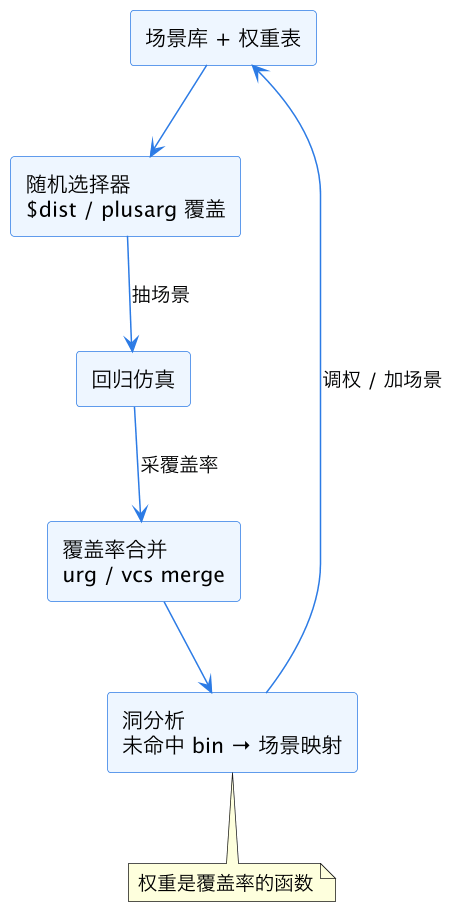
这个闭环流程里有两个工程细节。其一,权重必须能被命令行覆盖——用 $value$plusargs 或 UVM 的 +uvm_set_config_int 传入权重,CI 上才能不改代码就跑「全非法场景专场」「边界场景加倍」这类定向回归。其二,覆盖率合并与洞分析的方法论见 覆盖率合并与排除流程,场景到 bin 的映射关系最好直接写进覆盖率模型的注释里,分析时少一层猜测。
另一个容易忽视的配合点是随机稳定性:调权重、加场景之后老种子的激励序列全变,历史 bug 无法复现。处理办法是给每个场景类独立 seed 空间,把「场景选择」与「场景内部随机」隔成两条随机流,框架见 随机稳定性与 seed 管理。
五、把三层落到回归:一个可执行的组织模板
把前面的零件组装成一个可落地的回归策略,常见做法是三档用例套餐:
| 套餐 | 场景配比 | 单次时长 | 触发频率 | 目的 |
|---|---|---|---|---|
| smoke | 合法 95%,定向小场景 | 分钟级 | 每次提交 | 快速抓低级回归 |
| nightly | 合法 60% / 边界 25% / 非法 15% | 小时级 | 每晚 | 广度覆盖 + 洞收敛 |
| weekend | 权重按洞分析动态调 | 天级 | 每周 | 攻未命中 bin、长序列压力 |
三档共享同一个场景库,区别只在权重表和场景重复次数。smoke 用例甚至可以退化成近乎定向——随机空间被收窄到「每笔必中」的范围,保证三分钟内有结论。nightly 是主力,权重来自上一轮洞分析。weekend 允许激进:把某个顽固 bin 对应的场景权重拉到 50%,配合 randc 或排除已命中值的动态约束做饱和攻击,相关技巧见 randc 与动态数组随机。
回归 triage 时,这个分层结构还提供了天然的归因线索:失败集中在非法场景层,大概率是 error predictor 或协议理解变了,而不是数据通路坏了;失败集中在某个边界场景类,直接顺着场景类的约束就能圈出 RTL 的嫌疑模块。归因效率本身就是分层设计的收益之一,配合 回归管理与 triage 的流程食用更佳。
六、场景库治理:命名、登记与剪枝
场景库用到一年以后,问题不再是「怎么写场景」,而是「库里三百个类哪些还活着」。治理靠三件小事。
命名即元数据。 场景类名里编码层别与目标,比如 axi_edge_cross_page_seq、axi_ill_len_overflow_seq——edge/ill/legal 前缀让 triage 时不用打开文件就知道层别,回归报表按前缀聚合就能出「各层失败分布」。团队约定一旦定下就别中途改风格,两百个类改名是没人愿意干的活。
登记进场景清单。 每个场景类在验证计划文档里占一行:类名、层别、命中的 covergroup/bin、作者、加入日期。这张表是洞分析的索引——看到某个 bin 没命中,先查表确认库里有没有对应场景,再决定是调权还是新写。没有这张表,「这个 bin 到底有没有人管」每问一次都要考古一次。
定期剪枝。 每过一个里程碑做一次场景体检:连续三个里程碑从未被抽中过(或抽中但从未贡献新覆盖)的场景,要么权重该调,要么场景本身和约束组合已经不 reachable,后者直接删类。场景库不是越大越好——每个类都是编译时间、维护成本和新人认知负担,死掉但赖在库里的场景类比没写更糟。剪枝的依据数据同样来自覆盖率合并,流程见 覆盖率合并与排除流程。
| 治理动作 | 频率 | 依据数据 |
|---|---|---|
| 命名规范检查 | 每次新增类 | 团队约定 |
| 场景清单同步 | 每次新增类 | 验证计划文档 |
| 场景剪枝 | 每里程碑 | 覆盖率命中历史 |
七、常见坑
- 只随机单笔事务就当成了场景覆盖:一万笔合法事务可能连一个跨页场景都没造出来,先看场景层的覆盖数据再下结论。
- 非法场景忘了配 error predictor:scoreboard 把正确的错误响应报成 mismatch,回归一夜红,查半天发现是测试平台自己的锅。
- 权重写死在代码里:CI 无法做定向专场,每次调权都要改代码重编译,用 plusarg 或 config_db 外置。
- 场景类之间互相复制粘贴:公共参数不收进基类,协议改一处要改十几个文件,场景库越大越烂。
- 场景层约束与事务层约束打架:sequence 的
with内联约束和事务类自带约束冲突时randomize()静默失败,必须检查返回值,细节见 constraint_mode 与内联约束。 - 覆盖率洞不映射回场景:看到 bin 没命中只会加随机次数,不回头检查是不是场景库里根本没有能打到那个 bin 的条目。
- 三层一锅烩在一个巨型 sequence 里:合法、边界、非法用
if揉在一起,权重调不动、triage 看不出层别,违背了分层的初衷。
这一篇在知识体系里的位置
- 向上承接:约束随机验证方法学 给出事务层随机的基础,本篇把它抬升到场景层。
- 横向相关:constraint、inside 与 dist 权重 是字段与事务层的权重机制,本篇的场景权重是它的用例层对应物;solve-before 与 soft 约束 决定场景约束冲突时的求解行为。
- 向下支撑:覆盖率合并与排除流程 提供洞数据来源,回归管理与 triage 消费本篇的三层用例结构。
总结
SV 场景随机化分层把激励组织成合法、非法、边界三类场景组成的场景库,用 virtual sequence 编排跨 agent 剧情,用外置权重控制抽取概率,并以覆盖率洞分析反向调权形成闭环——事务随机保证「每笔都对」,场景分层才保证「该发生的都发生过」。