毛刺功耗:成因、占比与三种结构性压制手段
SAIF 功耗精度里提过一个事实:RTL 零延迟仿真永远看不见毛刺,所以 RTL SAIF 算出的功耗系统性偏低。那被漏掉的这部分到底有多大、从哪来、能不能从设计上压掉?这就是毛刺功耗(glitch power)要回答的问题。它和 时钟门控压的「不必要的翻转」不同——毛刺是功能上完全无用的跳变,电路算出的最终值一次都对,中间却白白多跳了好几次,每一次跳变都是真金白银的充放电。
本文要回答的问题
- 组合逻辑的毛刺到底是怎么产生的?为什么说路径延迟差是根源?
- 毛刺在总动态功耗里占多少?哪些结构是毛刺重灾区?
- 平衡树重构怎么从拓扑上减少毛刺?代价是什么?
- 门控和重定时各自从什么角度压制毛刺传播?
- 三种手段怎么选、怎么配合?工程上先动哪一个?
一、毛刺的成因:路径延迟差引发的输出振荡
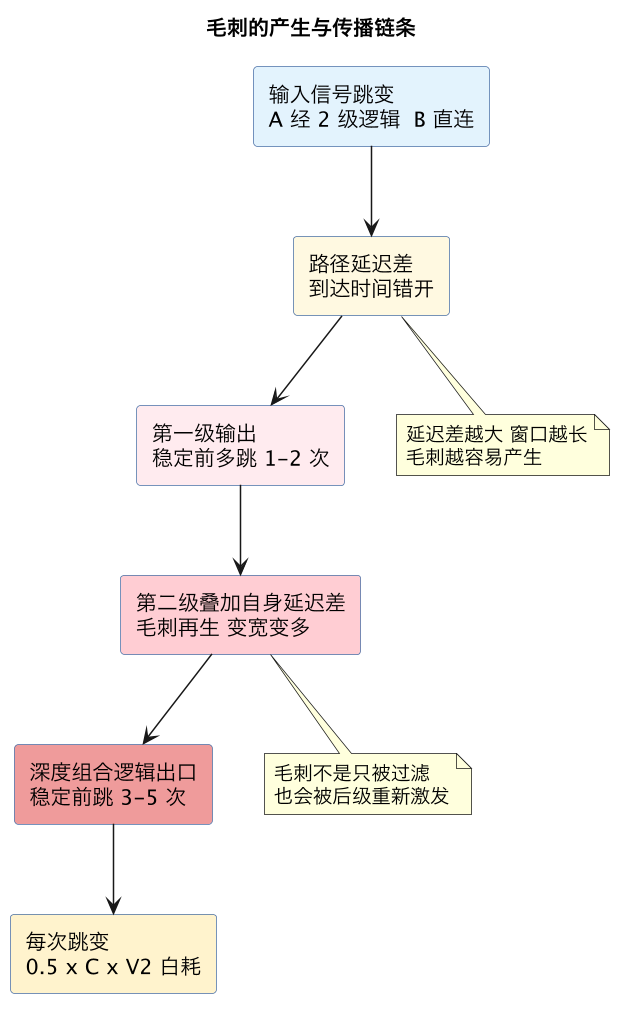
理想情况下,一个组合逻辑门的输入在同一时刻到达,输出翻一次就稳定。真实电路里,同一门的多个输入走过的路径长度不同、经过的门数不同,到达时间有先有后——这个到达时间差(arrival time skew)就是毛刺的源头。
举个最小例子:一个二输入与门,A 经过一级反相器才到,B 直连。某一拍 A 从 0 变 1、B 从 1 变 0,功能上输出应该一直是 0。但 B 先到(变成 0 之前 A 的旧值还是 0),随后 A 的新值 1 到达时 B 已经翻成 0——中间如果 A 先翻而 B 还没翻,输出就会短暂弹出一个「1」的尖峰,几十到几百皮秒后回落。这个尖峰就是毛刺:它对最终逻辑值毫无贡献,却真实地给输出负载电容充了一次电又放掉。
更麻烦的是毛刺会传播和再生。第一级产生的尖峰进入第二级逻辑,和第二级自己的路径延迟差叠加,可能在输出端再激发出新的跳变。级数越深,毛刺像滚雪球一样越滚越多。一个 16 级进位链的加法器,高位输出在稳定前可能来回跳 3-5 次。RTL 仿真是零延迟模型,信号一拍到,这些中间跳变全部不可见——这就是为什么 VCD 与 SAIF 活动率数据流里强调只有带 SDF 反标的门级仿真才能把毛刺收进翻转率统计。
二、占比与重灾区:哪些结构在给毛刺打工
经验数字:毛刺功耗占总动态功耗的 10%-30%,具体落在哪取决于设计里有什么。重灾区有三类。
第一类是异或树和校验逻辑。XOR 门对任何输入跳变都敏感(输入翻输出必翻),路径稍微不齐输出就来回跳,宽位 ECC、CRC、奇偶校验树的毛刺活动率可以是功能翻转率的 3-4 倍。
第二类是乘法器和宽位运算。阵列乘法器内部大量部分积加法链,进位波纹 + 异或求和两个毛刺放大器叠在一起,毛刺功耗能占乘法器自身动态功耗的 40% 以上——AI 加速器里密密麻麻的 MAC 阵列让这个问题格外扎眼。
第三类是数据选择器(MUX)长链和译码器。多级 MUX 的选择信号到达不齐时,输出会在不同数据通道之间短暂「串台」,产生与数据无关的跳变。
| 结构类型 | 毛刺相对功能翻转的倍数 | 占总动态功耗典型份额 |
|---|---|---|
| 普通控制逻辑 | 1.1-1.3 倍 | < 5% |
| 加法器/进位链 | 1.5-2.5 倍 | 5%-10% |
| XOR 树/校验逻辑 | 3-4 倍 | 视占比可达 10%+ |
| 阵列乘法器 | 2-4 倍 | 模块内可达 40% |
值得注意的是毛刺还和电压强相关:延迟差是绝对的皮秒数,低压下门延迟整体变大、相对 skew 占比变小,但 SPEF 寄生提取不准时 signoff 对毛刺窗口的估计也会跟着失真。要拿到毛刺的真实账,最终还是要靠带 SDF 的门级仿真喂给 Voltus/RedHawk 功耗签核这类工具链。
三、手段一:平衡树重构——从拓扑上消除延迟差
既然毛刺的根源是路径延迟差,最对症的办法就是把路径做齐。平衡树(balanced tree)重构把链式、偏斜的逻辑结构改画成深度一致的树形:所有输入到输出的逻辑级数相同,信号几乎同时到达每一级,毛刺窗口被压到最小。
经典例子是进位链和归约树。一个 8 输入的归约 XOR,写成链式是 7 级深度、每级延迟差累计,毛刺满树飞;重构成 3 层满二叉树后,每一层的输入都来自同一层、到达时间天然对齐,毛刺活动率通常能砍掉 50%-70%。加法器从行波进位换成超前进位(CLA)本质也是同一思想:用并行前缀树取代串行链。
代价有两个:一是面积,树形结构往往比链式多 20%-40% 的门;二是布线拥塞,树的对称性要求高,绕线会引入新的延迟差,所以平衡树在综合后还要靠布局布线工具保对称,否则纸面平衡会被绕线打破。现代综合工具有专门的 glitch 优化 pass(比如对高活动率网络做结构哈希重构),但只对工具「看得到活动率」的设计有效——又回到 SAIF 质量问题上来了。
四、手段二与三:门控切断传播,重定时改换位置
门控压制的思路不是消灭毛刺,而是掐断它的传播窗口。在深度组合逻辑的输出端(或关键中间级)加一级由使能控制的锁存/门控,只有当逻辑已经稳定后才放行信号到下游。常见于乘法器阵列:输入操作数无效时整块阵列用 AND 门把输入钉在常数,阵列内部一个毛刺都不产生;操作数有效时,使能信号刻意延迟半个到一个时钟周期再打开输出寄存器,让内部毛刺先在「静默期」里跳完、衰减掉,下游只看到稳定值。这使能时序的取舍与 时钟门控检查里的 ICG setup 检查一脉相承——门控信号本身不能带毛刺,否则就是把污染源接到了水龙头上。
重定时(retiming)则从流水线位置下手:把寄存器移进长组合逻辑锥的中间,把一条 15 级的深锥切成两段 7-8 级的浅锥。毛刺数量大致随逻辑深度指数增长,深度减半后每段的毛刺大幅缩水;同时寄存器本身是一个「毛刺滤波器」——采样沿只采稳定值,上一段的残余毛刺被天然截断。重定时的好处是不改功能、不改接口,现代综合/物理实现工具可以自动做;限制是它只能移动寄存器不能凭空造,时序紧张的深锥未必有合法的移动空间,且寄存器数量增加会多付时钟树功耗——时钟树本来就是不产生毛刺的「干净」开销,这笔交换通常是划算的。
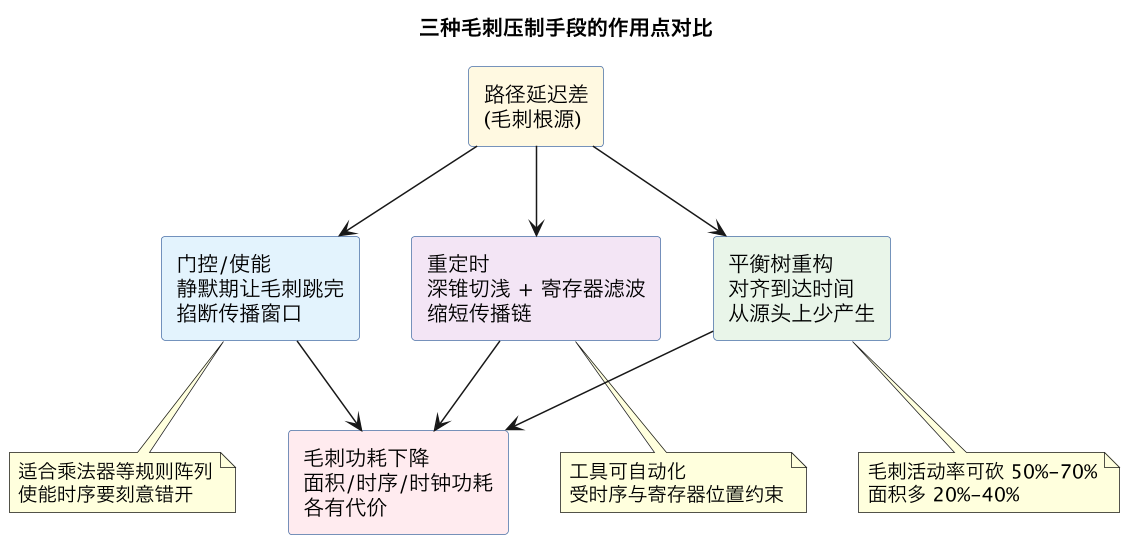
工程上的出手顺序一般是:先跑带活动率的综合让工具做自动重构(平衡树类),再对高活动率的规则模块手工加门控,最后用时序驱动的重定时收尾。三者不互斥,作用点不同:一个少产生、一个不传播、一个早截断。
这一篇在知识体系里的位置
- 上游:毛刺为什么只有门级仿真看得见,见 SAIF 功耗精度;活动率数据的导出链路见 VCD 与 SAIF 活动率数据流。
- 同层:延迟差与寄生参数的关系见 SPEF 寄生提取;门控信号的时序约束见 时钟门控检查。
- 下游:压制手段见效后的功耗账最终由 Voltus/RedHawk 功耗签核收口。
总结
毛刺功耗是组合逻辑各输入路径延迟差造成的功能性无用跳变,占总动态功耗 10%-30%,XOR 树、乘法器、MUX 链是重灾区;RTL 仿真天然看不见它,必须靠门级加 SDF 仿真计量;压制靠三板斧——平衡树从源头对齐到达时间、门控在静默期掐断传播、重定时把深锥切浅并用寄存器滤波,三者作用点互补,按「自动重构、手工门控、时序重定时」的顺序出手最划算。