UVM reg block map 结构:block/map/reg/field 四层体系与地址映射复用全解
更新时间:2026-09-28。在 UVM 寄存器模型集成 里,我们把 RAL(Register Abstraction Layer,寄存器抽象层)接进了 env,让 sequence 用
regmodel.ctrl.write()就能发总线事务。那一篇讲的是「模型怎么连上 DUT」,这一篇往里走一层,专门拆开 UVM reg block map 结构本身:field、reg、block、map 四层对象各自管什么、地址是怎么从 field 一路滚到总线字节的、以及一个子系统 block 怎样在不同 SoC 里换基址复用。理解这套层次,是写得出可复用寄存器模型的前提。
本文要回答的问题
- uvm_reg_field、uvm_reg、uvm_reg_block、uvm_reg_map 四层到底是什么关系,谁包含谁?
- 一个 field 的访问最终怎么变成某个地址上的总线读写?
- default_map 是干什么的,为什么一个 block 可能挂不止一张 map?
- create_map 和 add_reg 的参数各是什么意思,offset 按什么单位算?
- 同一个子系统 block 被集成到两颗 SoC、基址不同,模型怎么做到不改代码复用?
一、四层对象:field、reg、block、map 各司其职
UVM reg block map 结构的核心是一棵四层包含树。最底层是 uvm_reg_field,对应寄存器里一段连续的比特,比如 CTRL[3:0] 这个 mode 域;field 上面是 uvm_reg,对应一个完整寄存器,有自己相对于所在 map 基址的偏移;再往上是 uvm_reg_block,对应一个功能模块的全部寄存器集合,比如一个 UART 或一个 DMA 通道;最特别的是 uvm_reg_map,它不是「包含者」而是「视图」——同一份寄存器物理实体,从不同总线接口看过去地址不同,每个视角就是一张 map。
这四层里只有 map 让人绕弯,前三层和 RTL 的直觉完全对应:field 是比特切片,reg 是地址单元,block 是模块边界。map 之所以单独成层,是因为「寄存器存在」和「寄存器在哪个地址可见」是两件事。一个 DMA 控制器挂 AXI 是一种地址,挂 APB 调试口又是另一种地址,寄存器本身只有一份,map 负责把同一份 reg 投影到不同地址空间。
每一层各自持有的状态也要分清。field 持有访问策略(RW、RO、W1C 之类)、复位值、以及 volatile 标记——volatile 为 1 表示硬件可能自己改这个 field,模型的 mirror 不能盲目相信。reg 持有 offset 和 backdoor HDL 路径,自身几乎不做决策,读写请求进来后按 field 拆包。block 持有子 block 列表和默认 map 指针,是复用和例化的单位。map 持有「reg → 字节偏移」的登记表和总线属性(字节序、单元宽度、是否 byte addressing)。一次 write 调用自上而下穿过四层,每一层只动自己管的那部分信息,职责切得很干净。
值得单独说一句的是 uvm_reg 这个类的两个「值」:desired value 是软件想写进去的值,set() 只改它,不发总线;mirrored value 是模型认为 DUT 当前应有的值,由 predictor 根据总线观测更新。write() 把 desired 推到 DUT 并同时刷新 mirror(显式预测模式下等 predictor 确认),read() 从 DUT 取回并可选刷新 mirror,mirror() 则专做「读回来比对 mirror」的检查。很多 scoreboard 写错,根子就是没分清这三个方法的语义边界——想静默改期望值用 set,想知道硬件实况用 read,想做一致性检查用 mirror 开 check。
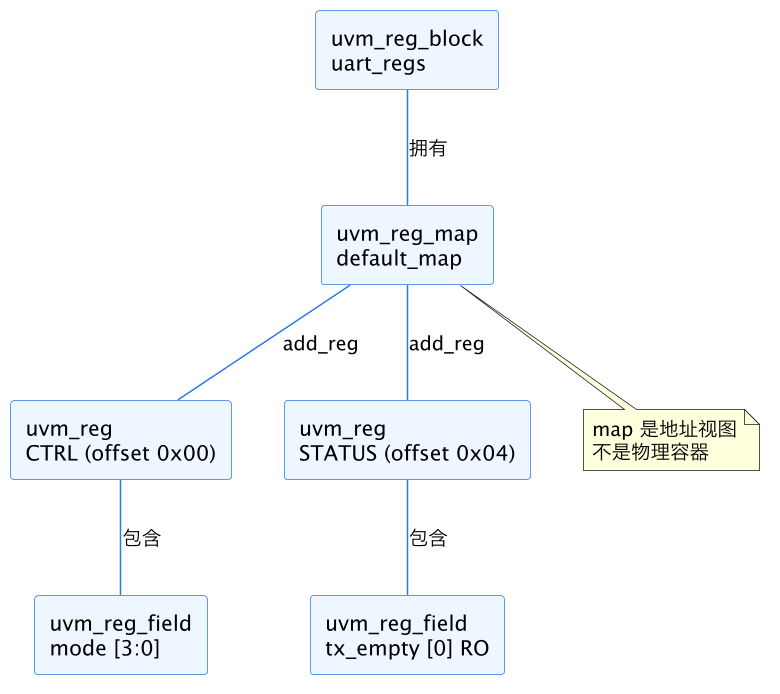
上图要盯着看的是连线的语义差异:block 到 map 是「拥有」,map 到 reg 是「登记」,reg 到 field 是「包含」。add_reg 这一步把一个 uvm_reg 挂进某张 map 的某个偏移上,一个 reg 可以被多张 map 各登记一次,但只属于一个 block。这个区分直接决定了后面多 map 和复用小节的玩法。
二、地址是怎么算出来的:从 field 到总线字节
sequence 里一句 regmodel.uart.ctrl.mode.set(4'h5) 最后变成总线上对某个字节地址的写,中间经过一串确定的换算。field 知道自己在 reg 里的 bit 偏移(lsb position),reg 知道自己在 map 里的 offset,map 知道自己挂在 block 里的基址。发起访问时,模型从 field 一路上溯到 map,拼出 reg 级地址,再交给 adapter 翻成总线 transaction。
offset 的单位是一个高频踩坑点:create_map 的第三个参数 n_bytes 声明的是这张 map 一个地址单元占几个字节,也就是总线数据位宽换算出来的字节数。32 位 AHB/APB 总线上 n_bytes=4,此时 add_reg 给的 offset 是字节地址,相邻两个 32 位寄存器 offset 差 4,不是差 1。不少人从 IP-XACT 或 Excel 表抄「寄存器序号 0、1、2」直接填进 add_reg,结果所有访问都打到了错误地址,后门路径还能对上前门却全错——因为后门走的是 HDL 路径,和 map 无关。
| 换算环节 | 由谁持有 | 例子 |
|---|---|---|
| field 在 reg 内的 bit 位置 | uvm_reg_field(configure 的 lsb) | mode 占 CTRL 的 [3:0] |
| reg 在 map 内的字节偏移 | add_reg 的 offset 参数 | STATUS 在 0x04 |
| map 的基址 | create_map / 上层 block add_submap | uart 挂在 0x4000_0000 |
| 字节地址到总线 transaction | reg adapter | bus_req.addr = 0x4000_0004 |
这张表从左到右就是一次 frontdoor 访问的地址流水线。任何一级填错,表现都是「读写不偏不倚错一个固定量」,定位时按这张表从下往上倒查最快。
字节序(endianness)和地址单位是另外两个要在 create_map 时一锤定音的参数。UVM_LITTLE_ENDIAN 与 UVM_BIG_ENDIAN 决定多字节寄存器在总线上的排布,填反了 32 位寄存器读出来就是字节翻转的值;最后一个布尔参数 byte_addressing 默认 1,表示 offset 按字节计,某些 DSP 风格的地址空间按字计时才需要改成 0,配合 n_bytes 把单位换算交给 map。还有个细节:field 在 reg 内部永远按 bit 位描述,不受总线字节序影响——字节序只在 reg 被打包成总线字节流的那一刻起作用,这个边界清楚了,一半的字节序 bug 就能提前避免。
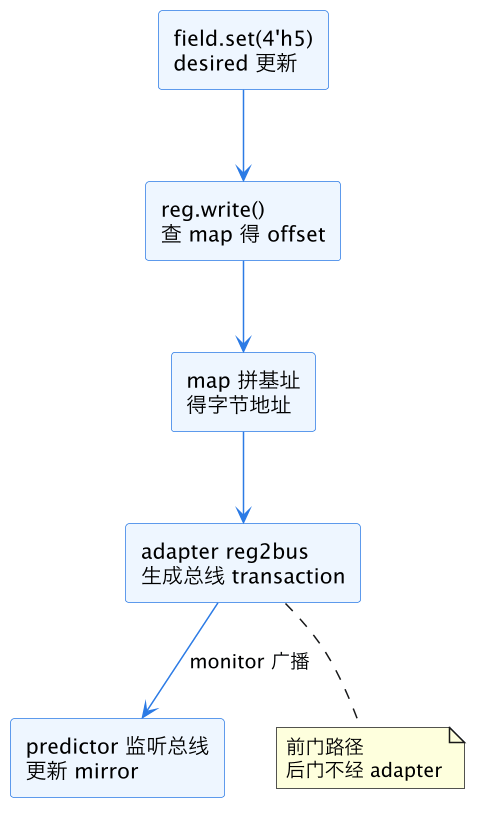
上图把一次前门写的完整链路拉直:set 只碰 desired,write 触发查表,地址在 map 层定型,adapter 做协议翻译,最后由 predictor 闭环更新 mirror。后门路径(write(..., UVM_BACKDOOR) 或 poke)在 adapter 那一步分叉,直接走 HDL 层级 force/deposit,不经过总线,也就不会被 predictor 看到——所以后门写完要么显式 predict,要么靠下一次前门访问校准,否则 mirror 就和 DUT 脱节。
三、default_map 与多 map:同一份寄存器的多张地址视图
每个 uvm_reg_block 至少有一张 default_map,不显式创建时 UVM 会生成一张占位。调用 reg.write() 而不指定 map 时,走的就是 default_map,对单接口模块这层完全透明,很多人写了几年 RAL 都没意识到它的存在。真正需要正眼看它,是在一个模块有两个以上总线接口的时候。
典型场景是一颗带 AHB 高速口和 APB 低速调试口的子系统:寄存器物理上只有一份,AHB 从 0x4000_0000 看,APB 从 0x8000_0000 看,两个口的访问还可能要做并发仲裁检查。做法是建两张 map,把同一批 uvm_reg 各 add_reg 一遍,offset 按各自总线视图填写。
class dma_regs extends uvm_reg_block;
  rand uvm_reg ctrl;
  rand uvm_reg status;
  uvm_reg_map ahb_map;
  uvm_reg_map apb_map;

  virtual function void build();
    ahb_map = create_map("ahb_map", 'h0, 4, UVM_LITTLE_ENDIAN);
    apb_map = create_map("apb_map", 'h0, 4, UVM_LITTLE_ENDIAN);

    ctrl   = uvm_reg::type_id::create("ctrl");
    status = uvm_reg::type_id::create("status");
    ctrl.configure(this,   null, "");
    status.configure(this, null, "");
    ctrl.build();  status.build();

    ahb_map.add_reg(ctrl,   'h00, "RW");
    ahb_map.add_reg(status, 'h04, "RO");
    apb_map.add_reg(ctrl,   'h10, "RW");  // APB 侧视图 offset 不同
    apb_map.add_reg(status, 'h14, "RO");
  endfunction
endclass
sequence 里要区分接口就显式带 map:regmodel.dma.ctrl.write(status, val, .map(ahb_map))。两条通路还会各配自己的 adapter 和 sequencer,分别绑定到对应 agent——这就是 AMBA AXI UVM 验证环境 里双 agent 结构在寄存器层的对应物。物理寄存器只有一份,mirror 值也只有一份,从哪个口写的 mirror 都同步更新,这正是「map 是视图不是容器」带来的好处。
多 map 还有一个不那么显眼但很实用的用途:安全视图。有些芯片的寄存器在特权模式和非特权模式下可见性不同,甚至同一 offset 在两种模式下映射到不同物理寄存器。建模时可以建 secure_map 和 nsecure_map 各登记一份,测试非特权访问越界时,从 nsecure_map 发起读写、期望返回错误响应,比在 sequence 里手算地址清楚得多。同理,带重映射(remap)寄存器的芯片,可以建 remap 前后的两张 map,切换 remap 位后换 map 访问,模型代码不用跟着 remap 逻辑改。
用多 map 时要克制一个冲动:不要给每个寄存器各建一张 map。map 的粒度是「一条总线通路」或「一种地址视角」,不是「一组相关寄存器」。寄存器分组是 block 的职责,地址视角才是 map 的职责,两者混淆会让 add_reg 的登记表碎成几十张小表,adapter 和 predictor 的接线跟着爆炸,模型的可读性反而比不用 RAL 还差。
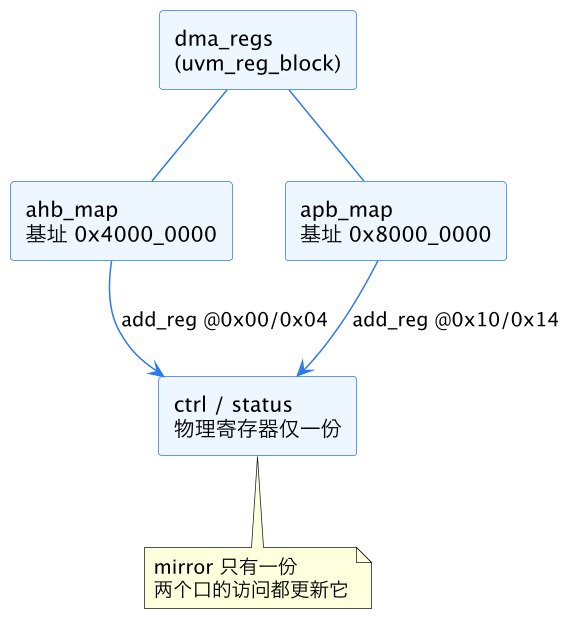
读这张图注意箭头指向的是同一个方框:两张 map 各自登记同一批 reg,offset 可以不同。如果哪天发现「APB 写了 ctrl,AHB 读出来不是刚写的值」,先怀疑 DUT 仲裁,而不是模型——模型侧它们是同一份存储。
四、子系统复用:add_submap 与基址上移
寄存器模型最值钱的特性是层次复用。block 级验证时给 UART 写的 uart_regs,到了 SoC 级不该重写一遍。UVM 的做法是:上层 block 把下层 block 实例化为成员,再用 add_submap 把下层 block 的 map 挂到本层 map 的某个偏移上,下层所有寄存器的地址随之上移。
class soc_regs extends uvm_reg_block;
  rand uart_regs uart0;
  rand uart_regs uart1;

  virtual function void build();
    default_map = create_map("default_map", 'h0, 4, UVM_LITTLE_ENDIAN);
    uart0 = uart_regs::type_id::create("uart0");
    uart1 = uart_regs::type_id::create("uart1");
    uart0.configure(this, "uart0_regs");
    uart1.configure(this, "uart1_regs");
    uart0.build();  uart1.build();
    default_map.add_submap(uart0.default_map, 'h4000_0000);
    default_map.add_submap(uart1.default_map, 'h4001_0000);
  endfunction
endclass
关键点有三个。第一,uart0 和 uart1 是同一个类的两份实例,寄存器定义零重复,改 field 只改一处。第二,configure 的第二个参数是后门 HDL 路径前缀,实例不同路径不同,所以每个实例要单独 configure,这是 内存后门与 scoreboard 里讲的后门访问能落到正确 DUT 实例的前提。第三,子 block 自己 create_map 时基址填 'h0,真正的基址由上层 add_submap 的 offset 决定——同一份 uart_regs 搬到另一颗 SoC,只改 add_submap 一行。
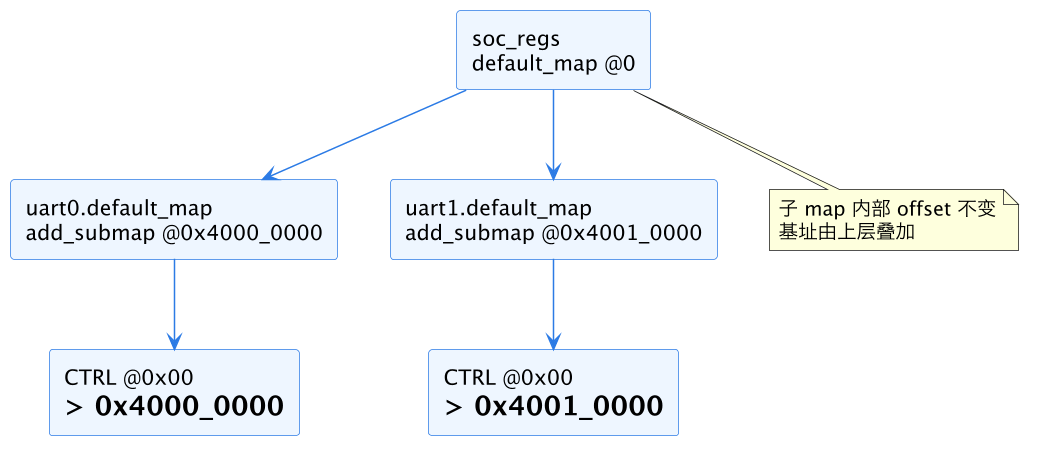
图上两条链结构完全对称,只是 add_submap 的偏移不同。uart 内部 CTRL @0x00 这个知识没有变,最终字节地址是沿途各层偏移之和。这也是为什么子系统 block 的 map 基址必须留 0:它不是「地址为 0」,而是「基址待上层指定」。
这套机制还有几个工程上的推论。其一,实例化 N 个同型子系统(多通道 DMA、多口 UART、多核簇)时,通道数量适合做成 block 的参数,build 里循环 create + add_submap,offset 用 base + i * stride 算出来,十几行代码顶过去手写几百行。其二,SoC 顶层的地址表(通常维护在 Excel 或 IP-XACT 里)和 add_submap 的偏移是单一事实源的两端,最好让寄存器模型由同一份表生成,人工对照迟早错位——很多团队用脚本从 IP-XACT 直接吐 uvm_reg_block 代码,就是为了掐断这条出错路径。其三,子 block 的后门路径前缀(configure 的第二参)必须和 DUT 实际层级逐字对齐,模块改名、加 wrapper 层都要同步改,否则后门静默打空,而前门完全正常,这种「半边绿」的失败最难查。
子系统复用还有一种变体值得一提:同一份寄存器定义,不同产品裁剪掉部分寄存器。做法不是删代码,而是在 block 的 build 里按参数跳过某些 add_reg——寄存器对象照常创建(field 定义保留,覆盖率模型不变),只是不登记进 map,访问这些 offset 自然落入地址空洞。这样裁剪配置收敛为几个布尔参数,模型主体跨产品零改动,也是 参数化类验证环境 思路在寄存器层的延伸。
五、预测器挂在哪一层:map 与 adapter 的接线位
四层体系还有一个常被问到的问题:uvm_reg_predictor 到底挂在哪。答案是挂在 map 上,且每张有独立总线通路的 map 各挂一个。predictor 的输入是对应总线 agent 的 monitor 广播出来的 transaction,经过 adapter 的 bus2reg 翻成 reg 级访问,再去更新 mirror。AHB 口和 APB 口各有一个 monitor、各有一种 transaction 类型,自然各要一对 adapter + predictor,分别 set_map 到 ahb_map 和 apb_map。
这套接线和 UVM 组件与 phase 里的 connect_phase 惯例一致:predictor 在 env 层创建,adapter 句柄 set 进去,map 句柄也 set 进去,monitor 的 analysis_port 连到 predictor 的 bus_in——用的就是 SystemVerilog TLM 通信 讲的 port/export/imp 那一套。只要 monitor 忠实广播,无论前门 sequence 写的、后门改的(显式 predict 时)、还是 DUT 中断拉起的寄存器变化,mirror 都能跟上,scoreboard 才敢拿 get_mirrored_value 当参考。
| 场景 | map 数量 | predictor 数量 | 典型坑 |
|---|---|---|---|
| 单总线单接口 | 1(default_map) | 1 | 忘记 set_map,predict 全落空 |
| 双总线双接口 | 2 | 2 | 两个 predictor 共用一个 adapter 实例 |
| 子系统嵌套复用 | 上层 1 + 子层各 1 | 按物理口算 | 子 map 基址非 0 导致地址翻倍 |
三个场景的共性问题都是「map 与实际总线通路不一一对应」。记住判据:DUT 有几条能发起寄存器访问的总线路径,就该有几张 map、几对 adapter/predictor,数量对不上几乎必然漏预测。
预测模式本身也值得交代一句。UVM 默认是显式预测(auto_predict 关闭):前门 write/read 之后 mirror 不立即更新,等 predictor 从总线上「看见」这笔访问才刷新,这能抓出「软件以为写了、实际总线没打成」的问题,是推荐姿势。打开 auto_predict 则 write 返回即刻更新 mirror,模型永远乐观,适合早期 bring-up 阶段 monitor 还没就绪时凑合用。判断当前处于哪种模式只需一行:regmodel.default_map.set_auto_predict(0) 关掉自动预测。项目从 auto 切到显式的那个节点,通常会冒出一批此前被掩盖的访问失败,这不是模型变脆弱了,是模型开始说真话了。
到这里,UVM reg block map 结构的四个抓手——层次、地址、视图、预测——就都摆上了桌面。剩下的就是把手头的寄存器表翻成代码:先定 block 边界,再按总线通路数定 map 数量,然后自底向上 configure field、build reg、add_reg 进 map,最后在 env 里接 adapter 和 predictor。顺序错了多半还能编译过,但行为会在某次莫名其妙的地址错位里暴露,按本文的层次自底向上走一遍,能省掉大量对着波形倒查的时间。
这一篇在知识体系里的位置
本篇属于 UVM 中级篇,向上承接 UVM 寄存器模型集成(模型与 env/adapter/sequencer 的接线全景),向下支撑 block 到 SoC 的层次复用,与 block/subsystem/SoC 验证差异 里讲的「子系统环境直接抬升复用」是同一件事在寄存器维度的投影。多 map 双通路的验证思路可延伸到 AMBA AXI UVM 验证环境;frontdoor/backdoor 两条访问路径的分工见 UVM RAL 前门与后门访问,预测器挂法则与 SystemVerilog TLM 通信 的 analysis 通路一脉相承。把 field/reg/block/map 四层想透,寄存器建模剩下的就是体力活。
总结
UVM reg block map 结构就是一棵「field 属于 reg、reg 登记进 map、map 挂在 block」的四层树:field 管比特、reg 管偏移、map 管地址视图(一份寄存器可被多张 map 以不同 offset 投影)、block 管模块边界,create_map 定字节宽度、add_reg 定字节偏移、add_submap 把子系统基址上移——四层各守一段地址换算,拼起来就是从 reg.write() 到总线字节的完整链路,也是同一份模型跨 SoC 复用的全部机关。