覆盖率驱动回归分诊:按覆盖洞聚类失败、bin 反推激励与定向补充用例
更新时间:2026-09-29。在 覆盖率合并与排除流程 里,多轮回归的覆盖率已经合并成一张总账;在 回归管理与失败分诊 里,失败用例按日志签名做了第一层归堆。但真实的收敛后期会卡在一种难受的局面:覆盖率 92%,剩下 8% 的洞打不进去,同时每晚回归还挂着十几个失败用例——失败和覆盖洞是不是一回事?先修 bug 还是先补激励?这一篇给出覆盖率驱动的分诊方法:把失败映射到覆盖洞上聚类,从 bin 定义反推激励缺口,再用最小代价的定向补充把洞关掉。
本文要回答的问题
- 回归失败和覆盖洞同时存在时,先处理哪个,判定标准是什么?
- 怎样把几十个失败用例按「它们本该覆盖什么」聚成 3-4 堆?
- 一个未命中的 cross bin,怎么反推出激励空间缺了哪块?
- 「激励不够」和「RTL 真 bug」在一晚的回归报告里怎么区分?
- 补洞的三种手段——加种子、加定向用例、改约束——各自什么时候用?
一、为什么分诊要以覆盖率为轴
传统分诊以用例为轴:失败列表按用例名排序,一个一个看日志。这在回归早期没问题,因为失败大多是环境刚接上的低级问题。但收敛后期,用例轴的两个缺陷会放大。
第一,失败用例和覆盖贡献脱钩。一个用例挂了,你不知道它挂之前已经贡献了多少覆盖率——也许它 80% 的 bin 都打完才死在最后一个 corner 上,那它的失败对覆盖洞的解释力就只剩那一个 corner;也许它 reset 后就死了,什么覆盖都没贡献,那它的失败本质上是「激励没送到」,不是 RTL 问题。
第二,多个失败可能指向同一个洞。AXI 从机回 SLVERR 的路径上挂了 6 个用例,按用例轴看是 6 件事,按覆盖率轴看是同一件事:cross {resp=SLVERR, burst=INCR, len>8} 这一片没人打进去。修一个地方,6 个失败可能一起消失。
覆盖率驱动的分诊把这两层关系显式化:每个失败用例先问「它原计划打哪些 bin、实际打了哪些、死在哪」,再把失败映射到覆盖洞上。下面这张流程图是整篇的骨架。
这张图里最核心的转换发生在「映射」这一步:分诊的输出不再是「用例 A 失败」,而是「bin 集合 S 未被覆盖,失败用例 A/B/C 都死在通往 S 的路径上」。后面所有动作都建立在这次翻译之上。
二、第一步:把失败用例映射到覆盖洞
映射依赖一个前提:用例和覆盖目标是可追溯的。如果 testplan 里每个用例都标了它负责哪些 covergroup,这一步就是查表;如果没标,就得靠数据反推。这也是 验证计划与覆盖率映射 强调「用例-特性-bin 三级关联」的原因——映射质量直接决定分诊效率。
实际操作里,映射做三件事。
第一件,取每个失败用例的部分覆盖率。仿真器都支持每用例单独存 UCDB(或等效格式),失败用例在挂掉之前采到的 bin 是实打实的贡献。把失败用例的 UCDB 单独 merge 一份,和它的计划目标做差,差集就是「它答应打但没打到」的洞。
第二件,标记死的位置。日志里最后一个采样的 covergroup、scoreboard 第一次报 mismatch 的时间点,大致圈出失败发生在激励路径的哪一段。常见三类死法:
| 死法 | 日志特征 | 覆盖贡献 | 初步定性 |
|---|---|---|---|
| 没跑起来 | reset 后无激励,timeout | 接近零 | 环境/激励问题 |
| 中途挂 | 打了若干 bin 后 mismatch | 部分贡献 | 待定,看挂点 bin |
| 收尾挂 | 打完大部分 bin,最后 check 失败 | 接近全量 | 疑似 RTL bug |
第三件,把失败按「目标 bin 集合」分桶。两个用例目标 bin 集合交集超过 70%,就归一桶;交集很小就分开。这个阈值不用精确,目的是把 14 个失败缩成 3-4 个桶,让后面的定性工作按桶做而不是按用例做。
三、第二步:按覆盖洞聚类,给每堆定性
聚类完成后,每个桶面对同一个问题:**这片 bin 没打到,是因为激励根本没到,还是激励到了但 DUT 行为错了?**这是覆盖率驱动分诊里最有价值的判定,因为它直接决定下一步走 RTL 修复流程还是走激励补充流程。
这个判定的逻辑依据是「激励路径的递进性」。一个 cross bin cmd=WRITE && len=15 && resp=SLVERR 打不到,先看它的上游:cmd=WRITE && len=15 这个更浅的 cross 有没有命中?如果连浅层组合都空着,说明激励发生器压根没产生过这种组合,是激励空间缺口;如果浅层命中了成百上千次、唯独加上 resp=SLVERR 这一维就全军覆没还伴随用例挂,那大概率是 DUT 在这个组合下行为异常——激励到了,响应错了,这是真 bug 的信号。
定性时还有两个容易判错的情况要当心。
一是约束过度裁剪伪装成激励缺口。写 covergroup 的人按 testplan 建了 bin,但写约束的人为了跑通环境加了 len < 8 的软约束,cross 里 len>8 的那一半永远打不进去。这种洞的修法不是加用例,是放约束——所以在定性为「激励缺口」之前,先 grep 一遍约束确认不是被人为切掉的。
二是非法 bin 伪装成洞。有些组合在协议里根本不合法(比如 AXI 的 burst=FIXED && len>16),激励永远不会产生它,这不是洞,是该标 illegal/ignore 的 bin。把它留在报告里,覆盖率永远差一口气,还会误导分诊。这类 bin 的清理属于 覆盖率合并与排除流程 里讲的排除动作,分诊时发现就该顺手标掉。
把「定性分流」这一节的判定顺序整体收敛起来看,就是一张逐级收窄的分诊漏斗:从报告里全部未命中 bin 出发,每一层剥掉一类「不是真问题」的部分,最后落到三种可执行动作上。
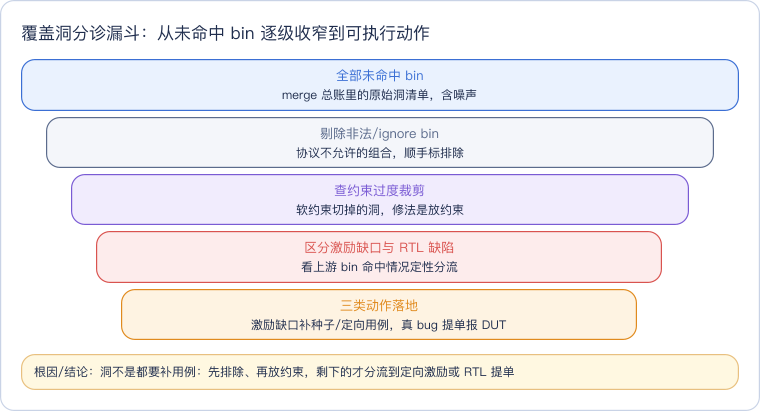
这张漏斗图的价值在于防止「见洞就补用例」的条件反射:前两层剥掉的洞根本不该进激励补充流程,只有穿过「定性分流」那一层的洞才轮到第五、六节讲的反推与定向手段。每层都有明确的退出判据,分诊时按层走,不会漏也不会冤。
四、第三步:从 bin 反推激励缺口
定性为「激励缺口」的桶,接下来的问题是:缺的到底是什么激励?这一步的核心方法是把 bin 定义当作一份激励规格书来读。
covergroup 的 bin 定义本身就是对「应该出现什么激励」的精确陈述。一个未命中的 bin {addr inside {[0x1000:0x1FFF]} && kind==RD} 直接告诉你两件事:地址要落在 4K 边界后的某段,类型要是读。反推就是把这个陈述翻译成激励发生器的参数空间缺口。
covergroup cg_axi @(posedge clk);
  cp_kind: coverpoint tr.kind {
    bins rd = {RD};
    bins wr = {WR};
  }
  cp_len: coverpoint tr.len {
    bins short = {[0:3]};
    bins mid   = {[4:11]};
    bins long_ = {[12:15]};
  }
  cp_resp: coverpoint tr.resp {
    bins okay   = {OKAY};
    bins slverr = {SLVERR};
    bins decerr = {DECERR};
  }
  cx_corner: cross cp_kind, cp_len, cp_resp {
    ignore_bins ignore_wr_err =
      binsof(cp_kind.wr) && binsof(cp_resp.decerr);
  }
endcovergroup
假设 merge 后报告显示 cx_corner 里 <rd, long_, slverr> 和 <rd, long_, decerr> 两个 bin 空缺。反推分三步。
第一步,分解维度。缺的组合里 kind=RD、len in [12:15] 是输入侧维度(激励发生器可控),resp 是输出侧维度(DUT 行为决定)。输入侧维度决定「要造什么样的 transaction」,输出侧维度决定「DUT 要处在什么状态才会回这个响应」。
第二步,查输入侧为什么缺。看激励发生器的约束:len 的分布是不是 dist 权重把长突发压得太低?地址发生器是不是只在低段打转?多数情况下,长突发缺失就是因为默认 dist 是均匀或偏向短包——回归跑了 200 个用例,每个用例 1000 笔,长读一笔都没抽中,组合数一乘,稀有度指数级放大。
第三步,查输出侧条件。slverr 需要从机拒绝,decerr 需要地址落到空洞。如果 testbench 里的 slave 模型默认永远回 OKAY,那不管你打多少长读,resp 那一维永远是 okay——这不是随机性问题,是环境配置问题,必须把错误注入打开。
反推的输出应该是一份「激励缺口清单」,每条写明:缺的 bin、输入侧要什么参数、输出侧要什么环境状态、当前为什么没满足。这张清单就是下一步补充用例的需求文档。
| 缺失 bin | 输入侧要求 | 输出侧条件 | 当前缺口原因 |
|---|---|---|---|
| rd × long_ × slverr | len∈[12:15] 的读 | slave 注错 | len 权重过低 + 注错开关未开 |
| rd × long_ × decerr | len∈[12:15] 的读 | 地址落空洞 | 地址发生器只走低段 |
| wr × mid × slverr | len∈[4:11] 的写 | slave 注错 | 注错序列未覆盖写方向 |
五、第四步:定向补充的三种手段与选择
缺口清单在手,补洞有三条路,代价从小到大:加种子、加定向用例、改约束。
手段一,加种子。缺口是「理论上能抽到、概率偏低」时用。不动任何代码,在回归脚本里给相关用例追加 20-50 个种子。优点零风险,缺点是对组合数大的洞(比如三维 cross 每维 1/10 概率,组合起来千分之一)效率差。经验法则:估算单个种子命中概率大于 1/50 的洞,用加种子;低于这个数,别指望暴力。
手段二,定向用例。写一个带 inline 约束的用例,把缺的维度直接锁死:
class fill_gap_seq extends base_seq;
  task body();
    axi_txn tx;
    repeat (200) begin
      tx = axi_txn::type_id::create("tx");
      if (!tx.randomize() with {
        kind == RD;
        len  inside {[12:15]};
      }) `uvm_fatal("GAP", "unsolvable")
      start_item(tx);
      finish_item(tx);
    end
  endtask
endclass
同时把 slave 模型的错误注入打开(比如每 20 笔回一次 SLVERR)。定向用例的要点是只锁缺的维度,其余保持随机——锁太死会丢掉附带覆盖率,也容易被评审质疑「这是为了打 bin 而打 bin,不是真实场景」。好的定向用例应该像真实流量的一种模式,只是恰好高频经过目标 bin。
手段三,改约束或权重。当缺口反映的是系统性偏斜——比如 dist 权重从一开始就把长突发压到 1/100——修补应该落在约束本身,让后续所有回归长期受益。但收敛后期改公共约束有外溢风险:权重一变,所有用例的激励分布都变,可能把已经打满的 bin 打稀,还可能引入新的时序压力暴露不稳定用例。所以这条路的纪律是:改完必须全量回归,不能只看目标 bin。
三种手段的优先级是明确的:先加种子试一轮,抽不中再上定向用例,只有确认是分布设计缺陷时才动约束。这个顺序保证每一步的代价和外溢风险都可控。
六、闭环:补洞后的验证与防回退
补完不是结束。定向补充的用例要过三道检查才能算闭环。
第一,复跑确认洞真的关了。把补充用例单独跑一遍,merge 进总账,确认目标 bin 命中。只看「用例通过」不够——用例通过但 bin 依然空着的情况很常见(比如 inline 约束锁了 len 但 slave 注错没生效,resp 维还是 okay),必须看覆盖率数据。
第二,确认没有误伤。补充用例加入回归池后,全量回归的总覆盖率应该单调不降;如果掉了,查是不是改约束时动了公共分布。
第三,把洞登记进防回退清单。收敛期的洞有个讨厌的特性:今天补上,下个月改 RTL 或改约束又掉回去。把关掉的洞记录成「bin → 负责用例 → 最低命中次数」的清单,回归脚本里加一道检查,目标 bin 命中数低于阈值就报警。这样分诊的成果才沉淀成资产,而不是一次性救火。
到这里,覆盖率驱动回归分诊的完整链路就走完了:失败映射到 bin、按洞聚类、定性分流、反推激励、定向补充、闭环防回退。它的价值不在任何一个单点技巧,而在于把「失败分析」和「覆盖率收敛」两件原本各做各的事拧成了一条流水线——失败列表变短的同时,覆盖洞也在变小,两个指标互为印证。
这一篇在知识体系里的位置
- 数据基础:覆盖率合并与排除流程 提供干净的总账和已排除的非法 bin,分诊的映射和定性都建立在它之上。
- 横向配合:回归管理与失败分诊 按日志签名做第一层归堆,本篇是它的下游——签名归堆解决「是不是同一个错误」,覆盖洞聚类解决「是不是同一片激励缺口」。
- 追溯前提:验证计划与覆盖率映射 的用例-特性-bin 关联决定了本篇映射步骤是查表还是反推。
- 激励侧延伸:补充用例涉及的随机化控制手段(
rand_mode、constraint_mode、动态加权)见 SV 随机化回调。
总结
覆盖率驱动回归分诊把失败用例从「按名字排队看日志」改造成「按覆盖洞聚类定性」:先把每个失败映射到它承诺但没打到的 bin 上归桶,再用「上游 bin 是否命中」区分真 RTL bug 与激励缺口,对激励缺口把 bin 定义当规格书反推出缺的输入维度和环境条件,最后按「加种子 → 定向用例 → 改约束」的代价顺序补洞,并用命中数清单防回退——让失败收敛和覆盖率收敛互为印证、同步推进。