flip-chip bump 规划:电源 bump 比例、信号逃逸布线与 bump/IO 协同实战
flip-chip bump 规划(bump map planning)是 SoC 物理实现里最典型的「跨界工种」,本篇从工程实战角度把它讲透。
Floorplan 与电源规划讲的是 die 内部电源网格怎么搭,先进封装 3D-IC讲的是多颗 die 怎么堆;但在两者之间还有一层经常被低估的规划工作——flip-chip bump 规划:这颗 die 正面朝下扣到封装基板上时,几千个焊点(bump)各自是电源、地还是信号,信号怎么靠 RDL(再布线层)从阵列内部「逃」到基板走线。这层规划做不好,后端 IR drop 签核会反复爆,封装基板被迫加层涨价,甚至整版 bump 图返工。本篇按工程顺序讲:bump 图怎么从功耗反推、电源/地/信号的比例怎么分、逃逸布线怎么规划、bump 与 IO 环怎么协同。
本文要回答的问题
- flip-chip 相比 wire-bond 为什么需要全阵列 bump 规划?bump 图由什么决定?
- 电源 bump 与地 bump 的数量怎么从电流需求反推?经验比例是多少?
- 信号 bump 的逃逸布线(escape routing)怎么规划?bump pitch 如何决定 RDL 层数?
- bump 阵列与 die 上的 IO 环、电源网格怎么协同对齐?
- bump 规划常见的翻车场景有哪些?怎样在 floorplan 早期就把坑排掉?
一、为什么 flip-chip 需要一张认真的 bump 图
wire-bond(引线键合)时代,芯片对外连接全在四周 pad 环上,电源和信号抢同一圈 shoreline,IO 数量受周长限制。flip-chip 把 die 正面朝下,通过整面阵列的 bump 直连基板,IO 数量上限从「周长 ÷ pad 距」变成「面积 ÷ bump 间距²」,同时电源可以从 die 中央正上方直接灌进来——这是它支持高功耗 SoC 的根本原因。
但自由的代价是规划的复杂度。几百到上万个 bump,每个都要回答三个问题:类型(VDD/VSS/信号/空)、位置(阵列坐标)、对应的 die 内部连接点。这张 bump map 一旦冻结,后续 die 的 IO 环摆放、电源网格打孔、封装基板的叠层设计全部以它为准——bump 图是芯片团队和封装团队之间的第一份契约,改一次代价以周计。
bump pitch(bump 间距)是整张图的「粒度参数」。当前主流区间:标准 flip-chip 约 130-180μm,高密度设计做到 90-110μm,先进封装(Cu pillar、micro-bump)进入 40-55μm。pitch 每缩一档,同样面积能放的 bump 数按平方增长,但 RDL 逃逸布线难度和基板成本也同步上升——规划的第一课是:不要为用不到的密度付钱。
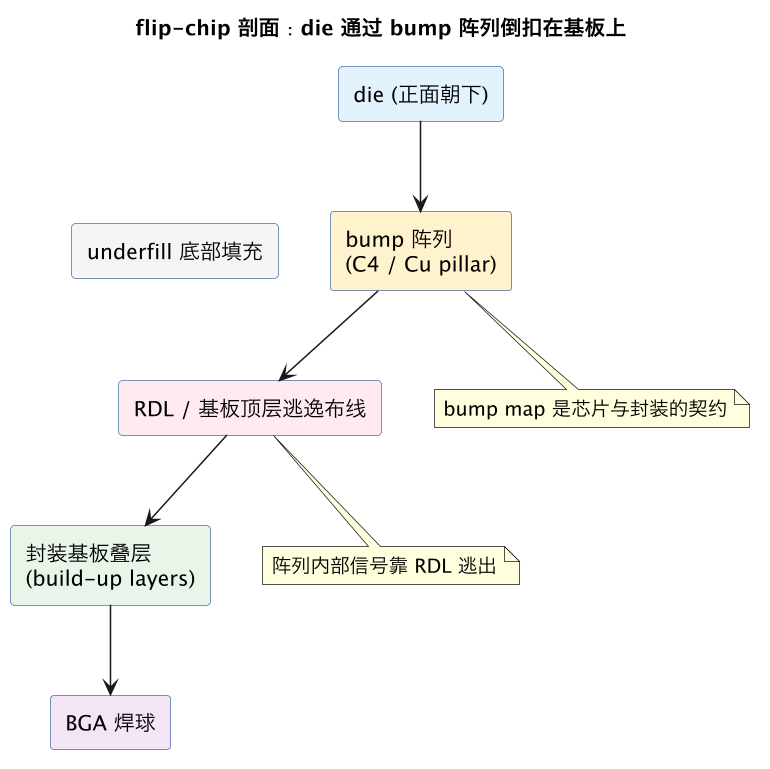
这张剖面图里最关键的一层是 RDL:bump 阵列是二维网格,但基板走线只能从阵列边缘「往外走」,位于阵列内部的信号 bump 必须先靠 RDL 把它们水平引到阵列边缘附近,才能垂直穿过基板孔。信号 bump 埋得越深,逃逸路径越长、要占的 RDL 轨道越多——这是第三节的主题。
二、电源 bump 比例:从电流反推数量
bump 规划的第一个定量问题是:这么多 bump 里,多少个给电源、多少个给地、多少个给信号?答案不是拍脑袋,是从电流预算反推的。
单个 bump(含其过孔和 RDL 连接)有载流上限,工程上常按经验值取:标准 C4 bump 在 130-150μm pitch 下大约 100-200mA(视温度、电迁移寿命要求打折;电迁移的背景见 信号 EM 与电源 EM)。假设核心电源域峰值电流 40A,按 150mA/bump 再留 30% 裕量,VDD bump 需求约 350 个。地 bump 承载回流,电流总量与电源相等,通常数量与 VDD 相等或略多——VDD:VSS 常见 1:1 到 1:1.2。
但电流不是唯一约束,还有三个修正项:
- IR drop 的空间分布:die 中央的功耗热点正上方必须有足够密的电源 bump,否则电流绕行导致局部压降。全局总数够了、热点局部密度不够,照样过不了 Voltus/RedHawk 签核。
- 回流路径与信号完整性:高速信号 bump 附近必须有足够近的 VSS bump 提供回流回路,否则串扰和地弹噪声上升。常见做法是信号区按「每 N 个信号 bump 配 M 个 VSS」的图案化配比(如 8:1 到 4:1)。
- 去耦 bump 的预留:片外去耦电容位置对应的 bump 簇要单独留出来,与片上 decap(见 decap 插入与 IR)形成两级去耦。
| bump 类型 | 典型占比(高功耗 SoC) | 数量决定因素 | 主要失效风险 |
|---|---|---|---|
| 核心 VDD | 20%-30% | 核心峰值电流 ÷ 单 bump 载流 | IR drop、电源 EM |
| VSS(地) | 25%-35% | 等于 VDD 加信号回流配比 | 地弹噪声、回流绕行 |
| IO 电源 | 5%-10% | IO 域数量与驱动强度 | IO 电源噪声 |
| 信号 | 30%-40% | 接口位宽总和 | 逃逸布线拥塞 |
| 空 bump(depopulated) | 2%-5% | 机械应力、逃逸通道预留 | 浪费密度 |
空 bump 常被误以为是「浪费」,实际是规划工具箱的一部分:在阵列里故意留出的空位是 RDL 走线的垂直通道,机械上还能缓解 die 角落的应力集中。
还有一个容易被初级规划者漏掉的修正项是 bump 自身的工艺类型。C4(可控塌陷芯片连接,锡铅或无铅焊球)直径大、载流高、应力缓冲好,是 130μm 以上 pitch 的主力;Cu pillar(铜柱加焊帽)直径细、电阻低、间距能做到 110μm 以下,但硬度高、应力直接传到 die 的 low-k 介质层上,先进节点的脆介质经常扛不住满阵列 Cu pillar,需要在敏感区域混用 C4 或加应力缓冲设计。同一颗 die 上不同类型 bump 的载流定额不同,电源 bump 计数时必须按实际选型分域计算,不能一张表用到底。
三、信号逃逸布线:从阵列内部到基板边缘
逃逸布线(escape routing)回答的问题是:阵列第 5 行第 12 列那个信号 bump,它的线怎么走到基板外层去?对标准 flip-chip,前一两圈 bump 可以直接从基板顶层走线出去(dogbone 扇出),更内层的信号必须先经 die 上的 RDL 层水平「搬家」到靠近阵列边缘的位置,再穿过 bump 落到基板。
bump pitch 直接决定每条 RDL 走线通道里能挤几根线。两个相邻 bump 之间构成一个走线通道,通道宽度 = pitch − bump 直径 − 2×间距规则。以 150μm pitch、bump 直径 75μm、线宽线距 10/10μm 估算,一个通道里能走 2-3 根线。要把 N 圈深的信号全部逃出,所需 RDL 层数大致按「最内圈信号数 ÷ 每圈通道可走的线数」估算。
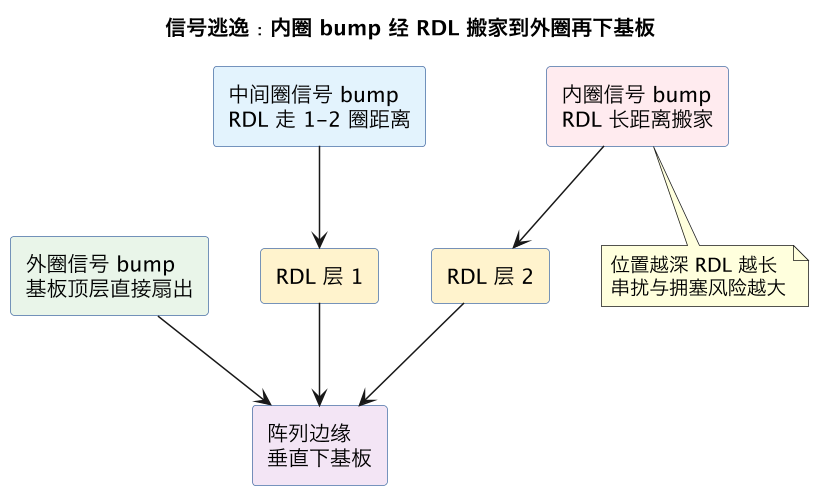
这张图解释了 bump 规划里一条朴素的原则:把长距离、高速、对噪声敏感的信号尽量排在阵列外圈,把短距离、低速、能忍受绕行的信号留在内圈。DDR、SerDes 这类接口的 bump 位图在 floorplan 早期就要先钉下来(常配合 IO 时序预算约束 一起评估),再让电源地 bump 填充剩余空间;反过来「先铺电源阵列、信号见缝插针」的做法,几乎必然导致高速信号被埋在内圈,逃逸布线层层加。
RDL 层数是直接的金钱变量:一层 RDL 对应一次光刻加电镀工序,设计逃逸方案时要在「多一层 RDL」和「加大 die 面积放宽 pitch」之间算经济账。工程上另一个省层手段是 depopulation——在内圈故意成排留空 bump,形成纵向走线走廊,常常一层 RDL 就能省下来。
逃逸布线还有两条进阶纪律。其一是差分对与等长约束:高速差分信号的两个 bump 必须相邻且逃逸路径等长,否则会引入模式转换噪声,规划 bump 位图时要把差分对当作不可拆分的单元整体摆放。其二是电源地 bump 充当屏蔽:关键高速信号两侧摆上 VSS bump,等于给它配了就地回流通道和串扰屏蔽,这种「地-信号-地」的三明治图案比事后补去耦有效得多。此外,逃逸出去的 RDL 走线本身也要过一遍电阻检查——内圈信号绕出去的路径可能长达 2-3mm,对供电类的模拟信号(如 PLL 的干净电源),这段 RDL 的压降必须单独核算。
四、bump 与 IO 环、电源网格的协同
bump 阵列不是孤立的一层,它向下要和 die 上的 IO 环与电源网格对齐,向上要和基板叠层对齐。协同的三条主线:
bump 与 IO 环对齐。wire-bond 的 IO pad 在 die 边缘,flip-chip 的 IO 驱动单元却仍常沿边或沿接口模块边界摆成环。bump 落在 IO 单元正上方(direct bump on IO)走线最短,但 bump 的机械应力会压坏 IO 单元下方的敏感器件,很多工艺要求 bump 与有源电路错开一段距离,用 RDL 桥接——这叫 bump-on-RDL。bump-on-IO 省布线、bump-on-RDL 保可靠性,高速模拟 IO 几乎一律走后者。
bump 与电源网格对齐。die 内部的电源网格(stripe/ring,见 floorplan 电源规划)通过顶层金属的 bump pad 开口(UBM)接到 bump。理想情况是电源 bump 正好落在主干 stripe 与顶层 metal 的交汇点上,过孔阵列垂直打下来,电流路径最短。bump 阵列与 stripe 周期错位半个 pitch,就会被迫用 RDL 做「之」字形绕行,每一段绕行都是白送的电阻和电感。所以 floorplan 阶段就要把 bump pitch 与电源 stripe 周期设成整数倍关系,这是典型的「早期一句话、后期省一周」。
bump 与基板对齐。基板侧每个 bump 对应一个 pad 加过孔,基板厂家对最小 pad、过孔环、走线密度有自己的规则集,bump 图必须在封装协同设计(co-design)评审里过一遍基板厂的可制造性检查。封测厂反馈的约束(如某区域禁止 bump、角上第一圈必须空)要回写到 bump map 约束文件里,作为下一轮迭代的输入。
协同的时序也值得强调:bump map 初版必须在 die floorplan 冻结之前就出,因为 bump 阵列的位置反过来约束 IO 环和电源 stripe 的可行解空间。实践中芯片团队和封装团队各拿着半个问题的约束,只有 bump map 这一份文档把两半拼起来——这也是为什么 bump map 评审通常要 RTL 前端(接口位宽)、后端(floorplan)、SI/PI 仿真、封装厂四方到场。任何一方缺席,后面都会以一轮 bump 图返工作为补课。
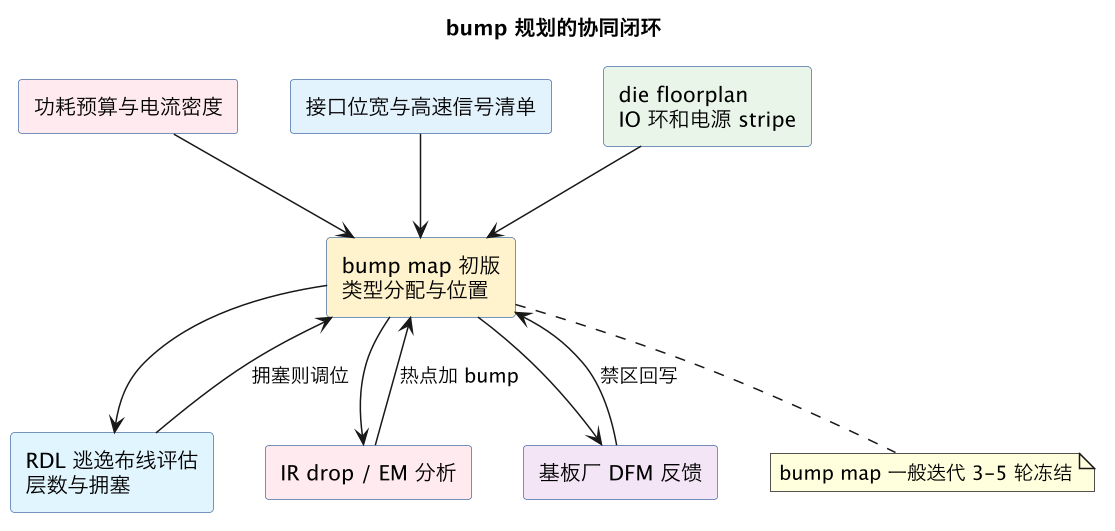
这张图的重点是右侧三条回流箭头:bump map 从来不是一次画对的,逃逸拥塞、IR 热点、基板厂禁区各会打回一轮修改。把电流预算、接口清单、floorplan 三个输入在画第一版之前就备齐,是把迭代轮数从 7 轮压到 3 轮的关键。
五、常见翻车场景与早期排坑
把踩过的坑列成清单,比背理论更能救命:
- 电源 bump 全局够、局部缺。总数按平均电流算的,热点区域(大核、NPU)上方的 bump 密度没单独校核,IR drop 签核阶段局部压降超标 30mV,被迫在热点上方做电源 bump 加密——此时 RDL 已经布完,牵一发动全身。预防:bump 规划阶段就用 无向量 IR 分析 做一版粗估。
- 高速信号埋内圈。电源阵列先把中间铺满,DDR bump 被挤到第 6 圈,逃逸布线两层 RDL 走不完,最后 die 加大 0.4mm 放宽 pitch,面积成本直接上升。预防:高速接口 bump 位图先于电源阵列冻结。
- bump 与 stripe 周期错位。stripe 按 40μm 周期铺、bump 按 150μm 摆,交汇点全靠 RDL 绕行,电源路径电阻比理论值高 20%。预防:pitch 与 stripe 周期取整数倍。
- 忽略基板厂禁区。角上应力区被要求空两圈,bump 图角上却摆了信号,封测厂打回重做。预防:第一轮 bump 图就送给基板厂预审。
- 回流 bump 配比不足。信号:VSS 按 12:1 配的,SI 仿真地弹噪声超标,补地 bump 又要抢信号位置。预防:高速区按 4:1 起步,SI 团队早期介入。
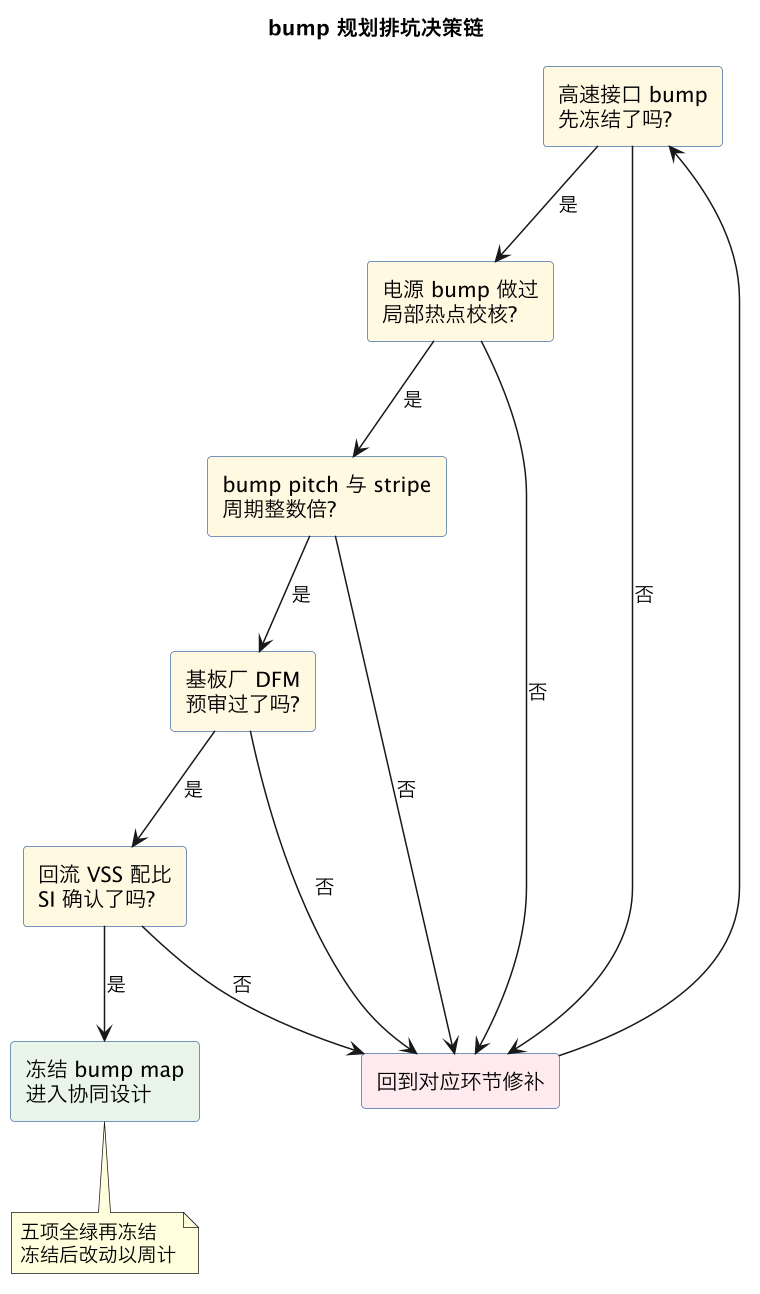
五条检查全部通过之后再冻结 bump map,是这个决策链的全部含义。顺序也有讲究:高速信号和电源密度是「空间资源分配」问题,必须先定;周期对齐和 DFM 是「实现细节」问题,放在后面——上游的错会在下游被指数放大。
这一篇在知识体系里的位置
本篇属于芯片实现流程中 floorplan 与封装协同的交叉地带。向上,die 内部布局与电源规划见 Floorplan 与电源规划,数据交接全景见 S3 floorplan/place 数据交接;向下,bump 决定的电源分配质量最终由 Voltus/RedHawk 电源签核 验收,载流约束的物理背景在 信号 EM 与电源 EM;横向,多 die 场景下 bump 思想升级为 micro-bump 与 TSV 规划,见 先进封装 3D-IC,片上去耦配合见 decap 插入与 IR。
总结
flip-chip bump 规划的本质是「在空间资源有限的一张网格上分配三种角色」:电源和地 bump 数量从峰值电流除以单 bump 载流反推、再按热点局部密度和信号回流配比修正,高速信号 bump 抢外圈优先冻结、内圈信号靠 RDL 逃逸布线搬家,bump pitch 与电源 stripe 周期取整数倍对齐——五条排坑检查全绿之后再冻结 bump map,因为这份芯片与封装的第一份契约,改一次以周计。