iverilog 多文件工程组织:filelist、-f 清单与 -y 库目录
单文件时代 iverilog design.v tb.v 一把梭;一旦设计按模块拆成十几个文件,命令行就放不下了。本篇讲 iverilog 编译多文件工程的标准组织方式:直接列文件、-f 读 filelist、-y 库目录自动检索,以及 iverilog 与商业仿真器在编译顺序上的关键差异。仿真在整条数字设计流程里的位置见 仿真是什么,文件目录如何划分见 RTL 工程目录规范。
本文要回答的问题
- 模块拆成多个
.v文件后,iverilog 命令行要写哪些东西? - filelist(
.f清单)长什么样,-f除了文件还能放什么? -y/-Y库目录按什么规则找模块?文件名和模块名必须一致吗?- iverilog 编译是否要求文件按依赖顺序排列,和 VCS 的顺序敏感有什么区别?
一、这一步在流程里的位置
写完 RTL 之后、看波形之前,中间的动作就是「编译组织」:把分散在各文件里的模块和 testbench 一起交给仿真器,产出一个可执行的 vvp 映像,再用 vvp 运行。它吃的是分文件的 RTL 与 tb,吐的是 sim.vvp 和仿真打印/波形。组织多文件工程的操作路径随文件数量演进,颜色按角色区分:蓝是输入与整理动作,橙是编译执行,绿是跑通后的判定:
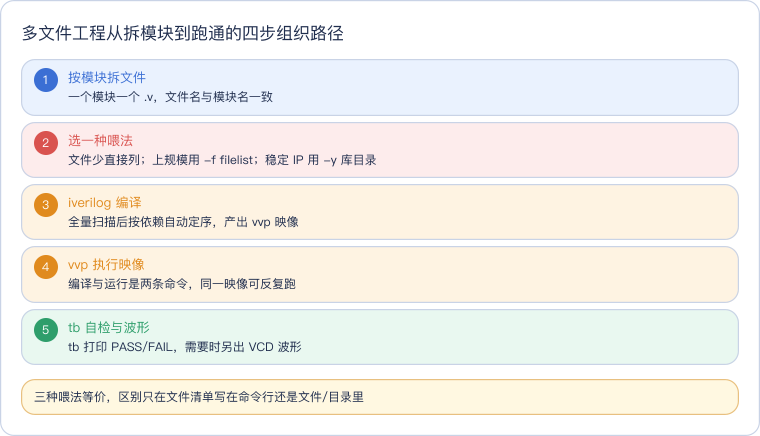
读这张卡抓住一条主线:真正随工程成长变化的只有第 2 步——文件清单放哪儿。第 1 步的拆文件纪律(文件名等于模块名)是 -y 自动检索能成立的前提;第 3、4 步的编译与运行对三种喂法完全相同,第 5 步的判定由 tb 自己下结论。
本篇的示例工程有三个设计模块和一个 tb:tb_top 例化 datapath,datapath 又例化 regfile 和 alu。依赖是一棵树,但三种组织方式喂给 iverilog 的输入形式不同:
读这张图抓两点:模块依赖方向是 tb 向下找三个设计模块;而三种组织方式的区别只在「怎么把这些文件告诉 iverilog」,编译和运行本身不变。真正工程化时,这段命令通常收进 Makefile,可直接套用 仿真工程Makefile通用模板。
二、命令逐段解读
以方式 2 的完整命令为例逐段拆开:
iverilog -g2012 -Wall -o build/sim.vvp -f filelist.f
vvp build/sim.vvp| 参数 | 作用 | 不加会怎样 |
|---|---|---|
-g2012 | 启用 SystemVerilog/Verilog-2012 语法特性 | 用 logic、always_comb 等语法时报语法错 |
-Wall | 打开全部常用告警(位宽、隐式声明、timescale 等) | 隐患只沉默通过,不推荐 |
-o build/sim.vvp | 指定输出映像路径 | 默认在当前目录生成 a.out |
-s <模块名> | 强制指定顶层模块 | 多顶层或编译库文件时需要;本工程 tb 是唯一顶层,可省略 |
-f filelist.f | 从清单文件读取参数(文件路径、甚至别的 - 选项) | 文件多了只能全挤在命令行 |
-y rtl | 把 rtl 登记为库目录,缺模块时按模块名去那里找 | 库里的模块必须显式列在命令行,否则报 Unknown module type |
-Y .v | 追加库检索的文件后缀 | 默认只认 .v;模块放在 .sv 文件里时要加 -Y .sv |
vvp 是第二步:iverilog 不直接执行仿真,它把设计编译成 vvp 字节码映像,vvp build/sim.vvp 才真正跑起来。两步分离的好处是同一个映像可以带不同的 vvp 参数(如 -l 落日志)反复运行。
编译顺序:iverilog 不敏感,这是它和 VCS 类工具最大的区别。 iverilog 先把命令行和清单里的所有文件全部扫描一遍、收集全部模块定义,再在细化(elaboration)阶段按例化关系解析依赖。因此文件顺序随便排——本篇实测里把 tb 放最前、被依赖的 alu 放最后,结果完全一致。传统 VCS 流程对命令行文件顺序敏感(先编译被依赖者),所以商业流程普遍依赖 filelist 严格排序;迁到 iverilog 时不必再维护这个顺序,但保持「被依赖者在前」的清单习惯依然有利于跨工具复用。
三、输入输出文件
三种方式的输入形式不同,输出完全一样。
方式 1:命令行直接列文件。 文件少(五个以内)时最直观:
iverilog -g2012 -Wall -o build/sim.vvp rtl/alu.v rtl/regfile.v rtl/datapath.v tb/tb_top.v方式 2:-f 读取 filelist。 清单一行一个路径,# 开头是注释;清单里还可以放编译选项、甚至再嵌套 -f:
# filelist.f —— 顺序无所谓,iverilog 全量扫描后自行定序
rtl/alu.v
rtl/regfile.v
rtl/datapath.v
tb/tb_top.viverilog -g2012 -Wall -o build/sim.vvp -f filelist.f文件上几十个以后,filelist 是工程的事实标准:新增模块只改清单、不碰脚本,也方便在不同仿真器间共用同一份清单。
方式 3:-y 库目录。 命令行只显式给 tb,细化时发现缺模块,iverilog 就去 -y 指定的目录里按「目录/模块名.后缀」找文件:
iverilog -g2012 -Wall -o build/sim_lib.vvp -y rtl tb/tb_top.v这里它要找 datapath 就打开 rtl/datapath.v,再顺着例化找到 rtl/regfile.v、rtl/alu.v。硬约定是文件名必须等于模块名——模块叫 alu 就必须存在 alu.v,写成 alu_core.v 便检索不到。这套机制来自 Verilog-XL 时代的库目录惯例,适合把稳定 IP 堆在一个目录里随用随取。
三种方式的输出都是同一个东西:vvp 映像(一个不可移植到别的仿真器、只给 vvp 执行的中间文件,类似 .out),运行后由 tb 的 $display 打印判定,由 $dumpvars 另产 VCD 波形。
四、常见错与检查点
报错 Unknown module type:模块根本没被喂进来。 现象是细化期 error: Unknown module type: datapath 并列出 missing 模块清单。检查三处:文件是否在命令行或 filelist 里;用了 -y 时文件名是否与模块名严格一致、后缀是否被 -Y 覆盖。详细判据见 Unknown module type 排查。
报错 already been declared:同一模块被编译两次。 文件同时出现在命令行和 filelist、或在 filelist 里重复一行,都会报 duplicate module。-y 库目录天然避免这个问题——库里的模块只在被需要时加载一次。重复定义的完整辨析见 duplicate module 排查。
timescale inherited 告警:只有 tb 写了 `timescale。 只有带时延的文件声明时间单位时,其余模块会继承先编译文件的 timescale,-Wall 下逐文件告警。做法是每个 RTL 文件头都补 `timescale 1ns/1ps,别依赖继承顺序。
filelist 里的相对路径相对于谁: 相对于执行 iverilog 时的工作目录,不是清单文件所在目录。统一在工程根目录执行编译可以避开所有路径歧义。
五、真实跑一遍
三模块工程(alu + regfile + datapath + 自检 tb,tb 先写两个寄存器再验证 10+3=13、10&3=2)在本机 Icarus Verilog 13.0 上依次跑四种编译——命令行列文件、颠倒顺序、-f 清单、-y 库目录,外加两个预期失败的检查点:
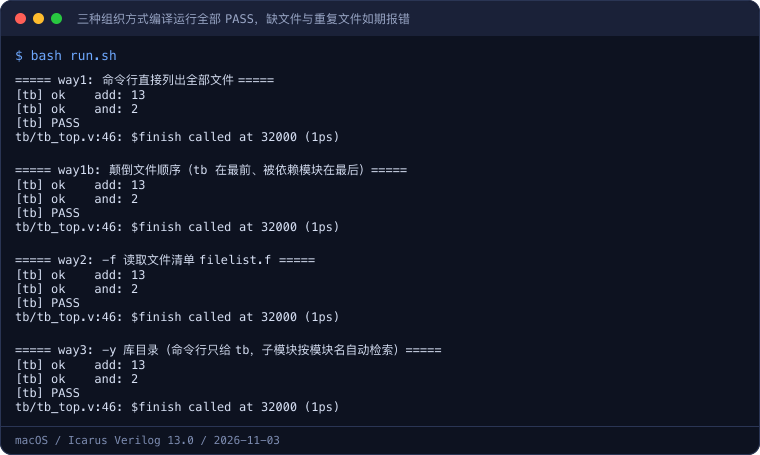
读这段实录抓三点:四种编译方式跑出的结果逐字节相同,都是两条 [tb] ok 后跟 [tb] PASS,证明文件顺序和输入形式不影响细化结果;way1b 故意把 tb 放在最前、alu 放在最后依然通过,这就是 iverilog 全量扫描后按依赖定序的直接证据;实录后半的两个检查点分别以退出码 2 报出 Unknown module type 与 duplicate module,对应上一节的前两个高频错,报错信息里直接点名缺失或重复的模块名,照着查即可。
终端卡展示的是分步执行,下面这段原始日志记录了方式一从编译到 PASS 的完整收尾:
Icarus Verilog version 13.0 (stable) (v13_0)

===== way1: 命令行直接列出全部文件 =====
[tb] ok    add: 13
[tb] ok    and: 2
[tb] PASS
tb/tb_top.v:46: $finish called at 32000 (1ps)
实验环境
- 机器/系统:Mac mini / macOS(Icarus Verilog 本机原生安装)
- 工具版本:Icarus Verilog version 13.0 (stable) (v13_0)
- 日期:2026-11-03
- 完整命令:
bash run.sh(内部依次执行方式 1/1b/2/3 的iverilog+vvp,以及两个预期失败检查点;等价于make cli、make flist、make lib)
代码获取
完整工程(rtl/ 三个模块 + tb/tb_top.v + filelist.f + Makefile + run.sh)在公开仓 experiments/flow-iverilog-multi-file-project,克隆后执行 make run 即可复现本文全部输出。
这一篇在知识体系里的位置
本篇是开源 EDA 流程步骤簇的一环:向上接 仿真是什么 建立的「编译 → vvp 运行 → 看波形」闭环,工程化落地直接配 仿真工程Makefile通用模板;文件在工程里如何摆放见 RTL 工程目录规范。本篇讲正常流程,编译报错类问题(Unknown module type、duplicate module、timescale 冲突)走 eda/ 下对应的 ts- 排查页。
总结
iverilog 多文件工程组织有三种等价喂法:文件少时命令行直接列;工程上规模后用 -f filelist.f 维护清单,加模块只改清单;稳定 IP 放库目录用 -y 自动检索,但文件名必须与模块名一致(非 .v 后缀用 -Y 追加)。iverilog 先全量扫描再按模块依赖细化,文件顺序不敏感,这与 VCS 类工具的顺序敏感不同;产物统一是 vvp 映像,由 vvp 执行、tb 打印 PASS/FAIL。