RTL工程推荐目录组织结构:为什么 rtl/tb/sim/syn 要各归其位
更新时间:2026-10-28。本文是芯片设计入门层的一篇问答页。很多刚写完第一个 FIFO 或状态机的读者,接下来面对的第一个工程问题不是语法,而是「文件往哪放」:仿真脚本和 RTL 混在一起、综合报告和波形挤在同一个文件夹,第二个月就找不到自己写的代码了。这一篇给出业界通行的一套 RTL 工程目录组织方式,并解释每一层为什么存在。
本文要回答的问题
- RTL 工程推荐的目录结构长什么样,各目录分别放什么?
- 为什么「所有 .v 平铺一个目录」会在第二个月失控?
ip/和lib/有什么区别,买来的 IP 和自己写的复用模块该放哪?- 仿真产物(波形、日志、覆盖率)该不该进版本库?
简短结论
推荐结构是按流程阶段分层:rtl/ 放可综合源码、tb/ 放验证环境、sim/ 放仿真脚本与运行产物、syn/ 放综合工程,外购 IP 进 ip/、自有可复用模块进 lib/。判断一个文件该放哪,只问一个问题:它属于哪个流程阶段、能不能重新生成。能重新生成的一律不进版本库(或进库也隔离到独立目录),不能重新生成的按阶段归位。
一、先给推荐目录树
一套中小型数字前端工程(单模块到子系统级)的推荐结构如下:
project/
├── rtl/            # 可综合 RTL 源码(.v/.sv),按模块再分子目录
│   ├── core/
│   └── periph/
├── tb/             # 验证环境:testbench、激励、reference model
│   ├── unit/       # 单元级 testbench
│   └── top/        # 系统级 testbench
├── sim/            # 仿真脚本(filelist、Makefile、回归脚本)
│   └── work/       # 仿真产物:波形/日志/覆盖率(gitignore)
├── syn/            # 综合工程:约束 .sdc、综合脚本、网表与报告输出
├── ip/             # 外购/第三方 IP 核(供应商交付,原样存放)
├── lib/          # 自有可复用模块库(跨项目复用的成熟单元)
├── doc/            # 设计文档、寄存器手册、接口说明
└── README.md # 工程说明:如何编译、如何仿真、如何综合读这棵树抓两条主线:一是按流程阶段纵向切——设计(rtl)、验证(tb)、仿真运行(sim)、综合实现(syn)各站各位,对应 数字芯片设计全流程 里的前端环节;二是按「能不能重新生成」横向切——源码和约束是资产,必须进版本库;波形、日志、网表、报告是产物,随时能用脚本重新跑出来,隔离在 sim/work/ 之类目录并加进 .gitignore。
二、为什么平铺一个目录会在第二个月失控
新手最常见的做法是:建一个文件夹,把 fifo.v、fifo_tb.v、run.do、波形 vsim.wlf、综合报告全扔进去。第一个月只有三五个文件时没有问题,第二个月开始失控,原因有四条:
- 文件数量按组合数增长。一个模块至少对应三类文件:RTL 本体、testbench、filelist/脚本;跑一次仿真又多出日志、波形、覆盖率文件。10 个模块的平铺目录里轻松超过 100 个文件,肉眼检索成本陡增。
- 无法区分「资产」与「产物」。平铺时
git status里波形、日志和源码混在一起,要么误提交几百 MB 的波形,要么.gitignore写成一长串逐文件例外,维护不下去。 - 工具的工作目录互相踩踏。仿真器默认在当前目录生成
work/库,综合工具默认在当前目录生成工程缓存,平铺意味着两套工具的临时文件落在同一处,清理时很容易误删脚本。 - 协作时没有人能看懂。第二个人加入工程时,平铺目录等于把「哪个文件是干什么的」这件知识只存进了原作者脑子里,工程交接变成口口相传。
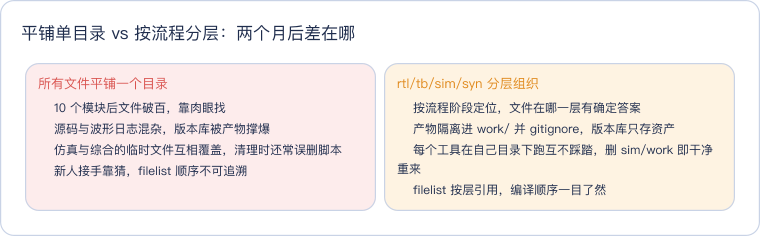
这张对比卡的核心判断是:分层不是洁癖,而是把「文件该放哪」从人脑记忆变成目录结构本身的规则。规则一旦外化,工具脚本可以自动遵循(比如回归脚本固定从 sim/ 启动、日志固定写 sim/work/),人也只需要记住四五条分层语义。
三、各层的职责与边界
rtl/ 只放可综合代码。这是工程的资产核心,也是综合工具的输入。判断标准很硬:这段代码能不能过综合?testbench 里的 #delay、initial 激励、覆盖率组都不是可综合代码,再小也不许进 rtl/。模块多起来后按功能再分子目录(core/、periph/),但层级别超过两层,过深反而难找。RTL 写法本身的约定见 RTL 设计。
tb/ 放验证环境。testbench、激励生成、reference model、checker 都归这里。单元级和系统级分开(tb/unit/ 与 tb/top/),因为两者的复用方式不同:单元 testbench 跟着模块走,系统 testbench 跟着集成走。验证方法学的背景可参考 SystemVerilog Testbench 基础。
sim/ 是仿真的「工作区」。filelist(.f 文件)、编译脚本、回归 Makefile 放 sim/ 顶层;一切运行产物(编译库、日志、波形、覆盖率数据)放 sim/work/ 并整体 gitignore。这样「重跑一次仿真」的操作永远等价于「进 sim/ 敲 make」,产物弄脏了 rm -rf work 就行。
syn/ 放综合工程。时序约束 .sdc、综合 Tcl 脚本、输出的网表与报告。约束是资产(进版本库),网表和报告是产物(可重新生成)。综合阶段本身的流程见 逻辑综合。
下面这张分层图把各层与工具的对应关系画出来,注意箭头的方向——产物永远从资产单向流出,绝不回流:
读这张图抓住一条主线:左边一列是「资产链」(rtl、tb、约束、脚本),右边两个节点是「产物」。资产之间互相引用(filelist 把 rtl 和 tb 组织成编译顺序),产物从资产单向流出——任何时候删掉产物目录,用资产加脚本都能完整重建。这条单向性是目录结构好不好用的试金石:如果你的工程里出现了「脚本要读某个上次仿真留下的文件才能跑」,说明资产和产物的边界已经破了。
四、ip/ 与 lib/ 的边界
这两个目录最容易混淆,区别在所有权和可改性:
- ip/:外购或第三方交付的 IP 核。供应商怎么给就怎么放,原样不动——哪怕目录组织很丑也不重排,因为下一版升级还要整包替换。IP 核的背景见 IP 核是什么。
- lib/:自己团队沉淀的、跨项目复用的成熟模块(通用 FIFO、CDC 同步器、总线桥)。这些是你自己的代码,可以改、可以重构,但改动要按库的标准走评审,因为影响的不止当前项目。
判断口诀:不能改的进 ip/,能改但改了影响别人的进 lib/,只属于当前项目的进 rtl/。有的团队干脆把 lib/ 独立成另一个 git 仓库、以子模块方式引入,这是规模上来之后的自然演化,起步阶段放在工程内即可。
各类目录该进版本库与否,可以用一张思维导图收拢:
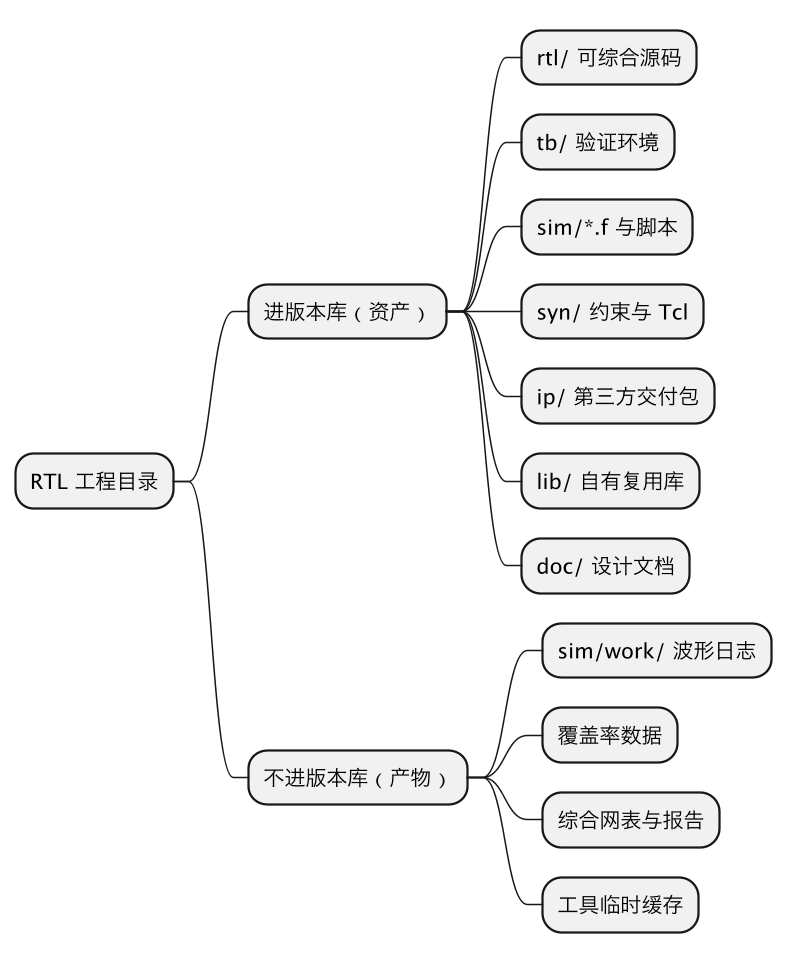
这张图回答的是「.gitignore 该怎么写」:左边分支全部提交,右边分支整体忽略。实践中唯一有争议的是 ip/——加密 IP 体积大时有的团队选择不入库、改用内部文件服务器管理,但「资产要可追溯」的原则不变,只是换了存放介质。
五、常见误区
- 误区一:按文件类型分层(
verilog/、tcl/、sdc/各一个目录)。这会切断「同一个流程阶段」的内聚性——仿真需要 filelist、testbench、RTL 三类文件协同,按类型分意味着每次干活要跨三个目录。按阶段分层、目录内自然混合文件类型,才是正确切法。 - 误区二:把 EDA 工具自动生成的工程目录直接提交。工具工程目录里混着大量缓存和绝对路径,提交后换台机器就打不开。正确做法是只提交生成该工程的脚本(Tcl/Makefile),工程本身现场重建。工具链层面的背景见 EDA 工具链。
- 误区三:filelist 里写绝对路径。工程一换目录或换机器就全军覆没。filelist 一律用相对路径,或以环境变量(如
$PROJ_HOME)为锚。 - 误区四:为了「干净」把产物目录也提交一份「重要的那次结果」。重要的结果应该固化成「资产」——比如把关键回归的通过标准写进脚本、把签字版报告复制到
doc/,而不是把整个work/塞进版本库。
延伸阅读
- 前端各阶段在芯片全流程中的位置:数字芯片设计全流程
- RTL 代码本身的写法约定:RTL 设计
- 验证环境怎么搭:SystemVerilog Testbench 基础
- 综合阶段吃什么输入:逻辑综合
- 工具全景:EDA 工具链
一句话总结
一句话总结:RTL 工程推荐的目录组织是按流程阶段分层——rtl/ 放可综合源码、tb/ 放验证环境、sim/ 放仿真脚本与产物(产物 gitignore)、syn/ 放综合约束与工程,外购 IP 原样进 ip/、自有可复用模块进 lib/;判断文件归属只问「属于哪个流程阶段、能不能重新生成」,资产进版本库、产物单向流出可重建;「所有 .v 平铺一个目录」之所以第二个月失控,是因为它无法区分资产与产物、让多工具临时文件互相踩踏、并把工程知识锁死在原作者脑子里。