EDA 仿真工程目录组织与 Makefile 模板:make run 一键仿真实录
更新时间:2026-10-25。本文是「EDA 实验室 · 仿真段」的一篇入门实验文。第一个 iverilog 仿真 讲的是「单个 .v 文件怎么编译跑起来」,iverilog 常见报错速查 讲的是编译失败怎么办;本篇解决的是下一个问题——当文件从一个变成十个,目录怎么摆、命令怎么固化成 Makefile,让
make run一条命令完成编译加仿真,而不是每次手敲一长串。模板工程已完整跑通,日志逐行可核对。
本文要回答的问题
- 一个最小的 EDA 仿真工程需要哪几个目录?各自放什么?
- Makefile 里「编译产物依赖源码」的依赖关系怎么写,才能做到改了源码自动重编、没改不重复劳动?
make run/make lint/make clean三个目标的标准分工是什么?- 为什么生成物目录(sim/)必须和源码目录分开、且能一键删除?
先给本次实测的结论卡,数字全部来自后文真实日志:
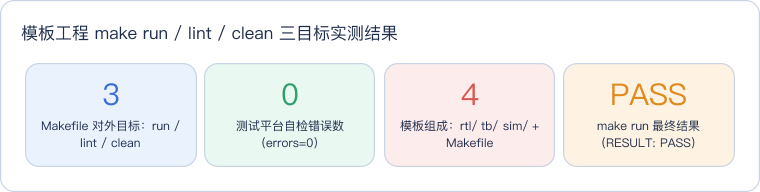
读这张卡抓一个判断:这个模板的全部复杂度就是「三个 make 目标 + 四个组成部分」,没有脚本、没有环境变量魔法——新手照抄就能用,用到工程长大再演化。
一、为什么需要目录组织:从单文件到工程的坎
第一个 iverilog 仿真 里一个 .v 文件搞定一切,命令也只有一条 iverilog -o sim.vvp counter.v。但真实学习项目很快长成这样:设计文件好几个、测试平台好几个、编译产物一堆 .vvp 和 .vcd 波形,全部堆在一个目录里,两周后自己都分不清哪些是源码、哪些是垃圾产物。
失控的代价很具体:删产物时误删源码(没有版本控制的新手项目里这是事故)、换机器复现时要从聊天记录里翻当时敲的命令、想加个 lint 检查不知道往哪放。目录组织和 Makefile 解决的就是这三件事:源码与产物物理隔离、构建命令固化成目标、质量检查一键可达。
业界成熟项目的目录当然更复杂(doc/、script/、ip/、constraint/ 等等),但对学习与中小实验,过度设计比没有设计更害人——每多一个目录就要多回答一次「这个东西该放哪」,犹豫本身就是成本。下面这个四件套模板是「最小够用」的甜点。
二、模板结构:rtl/ tb/ sim/ 加一个 Makefile
先把「不分目录」的对立面摆出来,后面每条规矩才有着落。新手项目典型的失控路径是这样的:第一天一个 counter.v 一个 tb.v,命令行手敲 iverilog 很顺手;第三天加了第二个模块,把命令改成 iverilog a.v b.v tb.v;一周后目录里躺着 sim.vvp、sim2.vvp、a.out(某次忘了 -o)、三个 .vcd 波形和一份「最终版_v2_真的最终.v」。此时想回答「哪些文件能删」已经要靠猜,想换台机器复现要翻终端历史。目录组织不是在项目大了以后才需要的奢侈品,而是从第二个文件开始就回本的纪律。
模板的结构与数据流用一张图说清(蓝色是手写源码,橙色是构建入口,灰色是生成物,绿色是终点判定):
读这张图抓住一条主线:只有 rtl/、tb/、Makefile 三样是「资产」,sim/ 目录里的一切都是「可以随时重生的产物」。这条分界线是目录组织的核心原则——版本控制只收资产,.gitignore 里写上 sim/ 一行就永远不会把波形文件误提交;清理磁盘时 make clean 删掉整个 sim/ 零心理负担。
各目录的取舍逻辑:
| 目录/文件 | 放什么 | 关键决策 |
|---|---|---|
rtl/ | 只放可综合的设计源码 | 设计视图的单一入口,综合工具只扫这里 |
tb/ | 只放测试平台 | 与 rtl/ 平级而非混入——testbench 不可综合,混放会污染综合文件列表 |
sim/ | 编译产物、波形、日志 | 纯生成物目录,Makefile 负责创建,make clean 整个删除 |
Makefile | 构建入口 | 放工程根目录,make 不带参数也能跑出有意义的行为 |
配合这个结构,工程的 .gitignore 只需要一行:sim/。版本控制里永远只有手写资产,克隆下来 make run 就能从零重建全部产物——这也是「这个工程是否组织良好」的一条快速检验标准:clone 到干净目录,一条命令能否跑通。
三、Makefile 模板逐段解剖
模板 Makefile 全文如下,后面逐段讲每个写法解决什么问题:
IVERILOG ?= iverilog
VERILATOR ?= verilator

RTL     = rtl/counter16.v
TB      = tb/tb_counter16.v
SIM_DIR = sim
VVP     = $(SIM_DIR)/counter16.vvp

.PHONY: run sim lint clean

run: sim

sim: $(VVP)
	vvp $(VVP)

$(VVP): $(RTL) $(TB)
	mkdir -p $(SIM_DIR)
	$(IVERILOG) -g2012 -o $(VVP) $(RTL) $(TB)

lint:
	$(VERILATOR) --lint-only -Wall $(RTL)

clean:
	rm -rf $(SIM_DIR)
工具变量用 ?= 而不是 =:IVERILOG ?= iverilog 允许外部用环境变量覆盖(比如 CI 里指向容器内的特定版本),本地不设则用默认。这是「能跑就不挡路」的写法。
run: sim 的别名目标:对外暴露的入口叫 run,内部真正实现叫 sim——用户记 make run 一个动词即可。.PHONY 声明这四个目标不对应真实文件,防止目录里恰好出现同名文件时 make 误判「已是最新」。
核心是这个依赖规则:
$(VVP): $(RTL) $(TB)它声明「编译产物依赖全部源码」。Make 拿文件的修改时间做比较:只有 rtl/ 或 tb/ 里任何文件比 sim/counter16.vvp 新,才重新编译;都没动过,make run 直接跑旧的 vvp,零重复编译。文件多了以后把 RTL 换成 $(wildcard rtl/*.v) 即可自动收集,模板的演化路径是平滑的。
可以亲手验证这个增量行为:跑完一次 make run 后立刻再跑一次,会看到 make 跳过编译直接执行 vvp(vvp 是 .PHONY 链上的命令,每次都跑,但编译步骤因为产物比源码新而被跳过);然后用 touch rtl/counter16.v 只改时间戳再跑,编译重新触发。工程大到一次全量编译要几分钟时,这个「没改不重编」就是每天省下的最实在的时间。
lint 只查 RTL 不查 TB:测试平台允许不可综合写法(#delay、$random、initial 块),过 lint 没意义还会制造噪音。lint 目标只对 rtl/ 开刀——告警怎么读、怎么修,见 Verilog lint 高频告警矩阵实测。
clean 只删 sim/:因为第一节立下规矩「产物只进 sim/」,clean 才敢一条 rm -rf 到底。目录组织的红利在这里兑现。
整个 Makefile 从头读下来只有约 20 行,但它把「谁来编译、编译谁、产物放哪、怎么检查、怎么清理」五个问题全部回答了,且每个答案只有一个出处。衡量一份 Makefile 写得好不好,就看这五个问题你能不能各用一行指出来。
四、实测实录:三个目标完整跑一遍
在干净目录里复制模板、连续执行三个目标的真实实录:
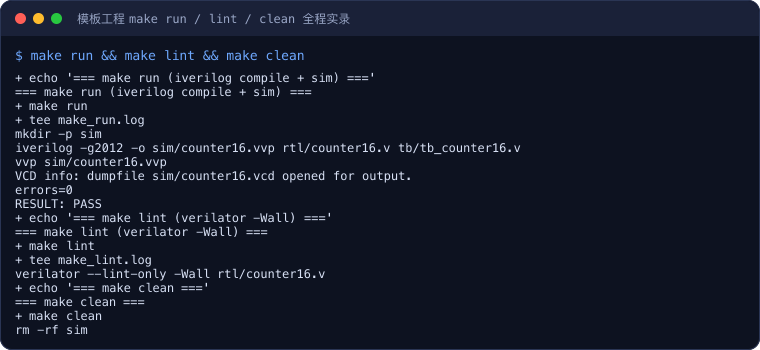
读这份实录抓三个位置:第 13-15 行是 make run 展开的实际命令——先 mkdir -p sim(首次运行产物目录不存在),再 iverilog -g2012 编译,最后 vvp 运行,测试平台自检打出 errors=0 与 RESULT: PASS;第 22-23 行是 make lint 对 rtl/ 跑 verilator --lint-only -Wall,本模板 RTL 干净、一条告警都没有(lint 通过时 verilator 静默退出,只回显命令本身);第 26-27 行 make clean 一条 rm -rf sim 收尾。整个工程从编译到清场,用户只敲了三个单词。
make run 到判定的关键输出段原样摘录:
+ make run
+ tee make_run.log
mkdir -p sim
iverilog -g2012 -o sim/counter16.vvp rtl/counter16.v tb/tb_counter16.v
vvp sim/counter16.vvp
VCD info: dumpfile sim/counter16.vcd opened for output.
errors=0
RESULT: PASS
+ echo '=== make lint (verilator -Wall) ==='
=== make lint (verilator -Wall) ===
+ make lint
+ tee make_lint.log
verilator --lint-only -Wall rtl/counter16.v
这段摘录里有个值得注意的细节:波形文件 sim/counter16.vcd 是 testbench 里 $dumpfile 指定的产物,也老老实实落在 sim/ 里——连波形都遵守「产物归产物目录」的规矩,make clean 之后磁盘上只剩手写资产。想看波形怎么读,可接 iverilog VCD 波形查看。
另一个不显眼但很重要的设计是 testbench 的自检输出 errors=0。模板里的 tb_counter16.v 不是「跑一遍看波形对不对」,而是内部比对计数器行为、把错误计数打印出来,脚本再用 grep 'RESULT: PASS' 做判定。这让 make run 从「人工看波形」升级为「机器给结论」,是将来接 CI 回归的入场券——CI 里没有眼睛,只有退出码和 grep。自建 testbench 时务必带上这个 errors 计数器,它比任何波形截图都可靠。
五、模板怎么用、什么时候该长大
复用这个模板的动作就三步:复制 rtl/ tb/ Makefile 到新工程目录;把 Makefile 顶部 RTL/TB 两个变量改成自己的文件名;make run。要加第二个设计文件就往 RTL 变量后追加,要加 lint 豁免就在根目录放 .vlt 文件并在 lint 目标里引用——所有演化都是增量修改,不需要推翻结构。建议复制后第一件事是故意改坏一行 RTL 再 make run,亲眼看一次 errors 非零、PASS 消失的失败路径——工具链的「失败时什么样」和「成功时什么样」同样值得提前见过。
什么时候这个模板不够用?出现以下信号再考虑升级,不要提前过度设计:
| 信号 | 升级方向 |
|---|---|
| RTL 文件超过 10 个、有层次依赖 | RTL = $(wildcard rtl/*.v) 自动收集;再往上引入文件列表 .f 文件 |
| 需要多个 testbench 分别回归 | 把 TB 参数化成 make run TB=tb_xxx,或写 regression 目标循环跑 |
| 要同时支持 iverilog 和 verilator 两种仿真 | 参考 verilator 二进制仿真 的构建方式,把 SIMULATOR 做成变量 |
| 波形、日志要按日期归档 | sim/ 下再分 sim/<日期>/,clean 策略不变 |
再补三个新手照抄模板时最常踩的坑,都是真实反复出现的:
- Makefile 配方行必须用 Tab 缩进,不能是空格。这是 make 最臭名昭著的语法陷阱——从网页复制 Makefile 时空格替换 Tab,报错是看不懂的
missing separator。编辑器里把「显示不可见字符」打开,看到^I才对。 - testbench 里
$dumpfile的路径要指向 sim/。写成裸文件名($dumpfile("counter16.vcd"))波形就会落到工程根目录,破坏产物隔离;本模板写$dumpfile("sim/counter16.vcd"),配合 Makefile 里先mkdir -p sim才保证目录一定存在。 - 不要把 vvp 产物文件名写死在多个地方。模板里
VVP = $(SIM_DIR)/counter16.vvp只定义一次,编译目标和运行目标都引用它——改文件名只改一行。路径字符串散落多处是「改了编译没改运行」这类低级错误的温床。
反过来说,如果你的工程还停在「一个计数器加一个 testbench」的阶段,任何比这个模板复杂的结构都是在给自己增加维护负担。工程组织的第一原则和写代码一样:先让结构匹配当前规模,留好演化路径。
这一篇在知识体系里的位置
- 前置:第一个 iverilog 仿真(单文件编译运行,本篇是它的「工程化」续篇);
- 质量门禁:Verilog lint 高频告警矩阵实测(
make lint目标查出的九类告警逐一解剖)、verilator lint 实操(告警分级与豁免); - 同系列实验:同步 FIFO Verilog 实现与回归实测(在真实实验里应用本模板的目录结构)。
一句话总结
最小够用的 EDA 仿真工程就四件:rtl/ 放设计、tb/ 放测试平台、sim/ 专收生成物、Makefile 固化 run/lint/clean 三个目标;核心原则是「源码与产物物理隔离」,做到这点,make clean 才敢一键清场、版本控制才不会混进波形垃圾。
实验环境
- 机器/系统:云主机 S6.4XLARGE32 16C32G / Ubuntu 22.04(eda-golden-v1 镜像)
- 工具版本:GNU Make + iverilog -g2012 + verilator --lint-only(均为 eda-golden-v1 镜像自带)
- 日期:2026-10-25
- 完整命令:
bash run.sh(内部执行:复制模板到工作目录后依次make run、make lint、make clean,并校验RESULT: PASS)
代码获取
模板工程完整文件(Makefile、rtl/counter16.v、tb/tb_counter16.v、run.sh)已同步到公开仓库:geek-doc.cn/experiments/exp-makefile-eda-project-layout,克隆后进入该目录执行 make run 即可复现本文全部结果。