verilator --binary:一条命令编译出仿真可执行文件,实测比 iverilog 快 3 倍
在 iverilog 仿真入门里我们用 iverilog + vvp 跑通了第一个计数器仿真;在 Verilator 高速仿真与 lint里讲过 Verilator「把 Verilog 翻译成 C++ 再编译」的原理。这一篇把两条路放到同一个实验里:verilator --binary 一条命令直接把测试平台(testbench)编成原生可执行文件,和 iverilog 跑同一份 TB、同样的 1000 万拍,用秒表说话,回答「到底快多少、代价是什么」。
本文要回答的问题
verilator --binary和传统--cc --exe写 C++ 激励的用法差在哪?为什么它可以直接跑带#延迟的 Verilog TB?- 同一份计数器 TB 跑 1000 万拍,iverilog 和 verilator 各要多少秒?加速比是多少?
- verilator 编译期要花多少时间?什么仿真规模下「编译慢、跑得快」才划算?
- 把 iverilog 风格的 TB 直接喂给 verilator 会踩哪些坑(报错长什么样、怎么改)?
一、环境与实验设计
实验统一跑在 Docker 容器 geek-eda:0.1(ubuntu:24.04)里,计时数据来自 Mac 生产机上的容器实测:
- Icarus Verilog 12.0 (stable)
- Verilator 5.020 2024-01-01 rev (Debian 5.020-1)
docker run --rm --user $(id -u):$(id -g) -e HOME=/tmp \
  -v ~/Project/geek-doc.cn/experiments:/work \
-w /work/eda-lab-verilator-binary-sim geek-eda:0.1 make run代码获取:本实验完整可编译代码(
counter.v、counter_tb.v)、Makefile、计时脚本与实测日志见公开仓库 derekzhuo/geek-doc.cn 的experiments/eda-lab-verilator-binary-sim/。克隆后make run即可复现。
被测设计(DUT)是一个 32 位同步复位计数器 counter.v;TB counter_tb.v 用 always #5 clk = ~clk 产生时钟,撤复位后 repeat (CYCLES) @(posedge clk) 跑 1000 万拍,末尾校验 count == 10000000 并打印 PASS。关键设计决定有两条:
- 同一份 TB 喂两个仿真器,不针对任何一方做特化,保证对比公平;
- 不在每个时钟沿
$display——打印 I/O 会把两边都拖成「测终端写入速度」,淹没仿真器本身的差异,所以全程只在结尾打 3 行。
二、verilator --binary 做了什么
先看两条工具链的形态差异。iverilog 是事件驱动仿真器:iverilog 把 Verilog 编译成中间码 counter_sim.vvp,运行时由 vvp 解释执行,每个信号变化都是一个事件,进事件队列排队调度。Verilator 走的是编译型路线:把设计翻译成 C++,再用 g++ 编成原生机器码,仿真就是跑一段普通程序。
iverilog 路线: {
  counter.v + counter_tb.v -> iverilog 编译: -g2012 -o
  iverilog 编译 -> counter_sim.vvp: 中间码
  counter_sim.vvp -> vvp 解释执行: 事件队列逐事件调度
}
verilator --binary 路线: {
  同一份 counter.v + counter_tb.v -> verilator: --binary --timing
  verilator -> obj_dir 里的 C++: 翻译为周期级 C++
  obj_dir 里的 C++ -> g++ 编译: 自动调用 make
  g++ 编译 -> obj_dir/Vcounter_tb: 原生可执行文件,直接运行
}上图的两个分支就是本实验的全部流程。--binary 是 Verilator 5.x 的「一步到位」模式:老用法要 --cc 生成 C++、自己写 main.cpp 激励、--exe --build 编译三步走;--binary 把「生成 C++ → 自动生成 main → 调 make 编译」串成一条命令,产出 obj_dir/Vcounter_tb,直接执行就是仿真。
一个很多人没注意到的细节:Verilator 5.020 里 --binary 自动打开 --timing,所以带 #5、@(posedge clk) 的行为级 TB 不需要额外 flag 就能编译。但如果用 --lint-only 或 --cc 而不显式给 --timing,就会立刻报错——这是本文第五节的第一坑。
三、真实运行
make run 先编两套仿真器。iverilog 一行出结果:
iverilog -g2012 -DCYCLES=10000000 -o out/counter_sim.vvp counter.v counter_tb.vverilator 这边是一条命令完成翻译加编译(输出节选自 out/verilator_build.log):
verilator --binary --timing -j 0 -DCYCLES=10000000 -o Vcounter_tb counter.v counter_tb.v
g++ -Os ... -DVL_TIME_CONTEXT -fcoroutines -c -o verilated_timing.o ...
g++     verilated.o verilated_timing.o verilated_threads.o Vcounter_tb__ALL.a -pthread ... -o Vcounter_tb
注意编译参数里的 -fcoroutines:timing 模式下 Verilator 用 C++20 协程实现 # 延迟和事件等待,这是它能跑行为级 TB 的机制,也是后面性能解读的关键伏笔。
两边跑完,输出逐字节一致的功能结论(out/run_iverilog_1.log 与 out/run_verilator_1.log):
[100000006000 ns] ran 10000000 clocks, count=10000000
TEST PASS: count == 10000000 as expected
计数值 1000 万、仿真时刻 100000006000 ns,两个仿真器完全一致——功能等价成立,接下来比速度才有意义。
四、速度实测:快 3.0 倍,但代价在编译期
每个仿真器各跑 3 次,取中位数(out/timing.log 原文):
# 环境: Icarus Verilog version 12.0 (stable) / Verilator 5.020 ... (Debian 5.020-1)
# 仿真拍数: 10000000,每个仿真器跑 3 次取中位数
iverilog run1: 13.707s (PASS)
iverilog run2: 13.769s (PASS)
iverilog run3: 13.296s (PASS)
iverilog median: 13.707s
verilator run1: 4.685s (PASS)
verilator run2: 4.550s (PASS)
verilator run3: 4.500s (PASS)
verilator median: 4.550s
speedup (iverilog_median / verilator_median): 3.0x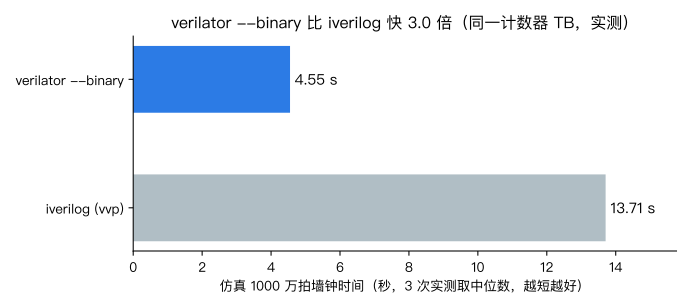
上图是这张表的直方图呈现:iverilog 中位 13.707 秒,verilator 中位 4.550 秒,加速比 3.0 倍。
说实话,3.0 倍比很多人预期的「Verilator 快几十倍」要低,这里必须如实解读原因,而不是夸大数字:
- 这份 TB 是行为级写法,verilator 只能靠 timing 协程逐拍等待时钟沿,每拍都有协程切换开销;它的主场是可综合 RTL 的两态化周期级仿真,那里才是几十倍加速的来源(原理见编译型仿真器内核)。
- DUT 只有一个计数器,设计极小,仿真时间大头在 TB 的时钟驱动上,两边都在做「等 1000 万个时钟沿」这一件事。
- 即便如此 verilator 仍然稳赢 3 倍,且三次运行波动(4.500~4.685s)比 iverilog(13.296~13.769s)更小。
但 verilator 不是白赚的,成本在编译期(out/build_timing.log 实测):
| 阶段 | iverilog | verilator --binary |
|---|---|---|
| 编译/构建 | 0.011 s | 4.010 s(翻译 C++ + g++) |
| 运行 1000 万拍 | 13.707 s | 4.550 s |
| 本次实验合计 | 13.7 s | 8.6 s |
| 只跑 10 万拍(估算) | 约 0.15 s | 4.0 + 0.05 ≈ 4.1 s |
这张表说明「编译慢、跑得快」的权衡:短仿真别用 verilator——10 万拍的冒烟测试,iverilog 编译 11 毫秒直接开跑,verilator 光构建就要 4 秒;长仿真、反复回归用 verilator——拍数越多、回归次数越多,4 秒构建成本被摊得越薄。经验分界大致在「单次仿真运行时间超过构建时间」的规模。
五、三个真实踩坑(附报错原文)
把 iverilog 风格的 TB 直接喂给 verilator,本实验真实踩了三个坑,全部用 make lint-err 可复现。
坑 1:--lint-only 不带 --timing → NEEDTIMINGOPT。 前面说过 --binary 自带 timing,但一旦换成 --lint-only 或 --cc,同样的 TB 立刻四处报错(out/err-needtiming.log):
%Error-NEEDTIMINGOPT: counter_tb.v:30:12: Use --timing or --no-timing to specify how delays should be handled
   30 |     always #5 clk = ~clk;
处置:显式加 --timing(TB 有延迟/事件等待时),或 --no-timing(纯 RTL lint 时明确不要)。
坑 2:模块间 timescale 不一致 → TIMESCALEMOD,且 warning 直接当 error 退出。 最初 counter.v 没写 `timescale 而 TB 写了,verilator 报(out/err-timescale.log):
%Warning-TIMESCALEMOD: counter.v:3:8: Timescale missing on this module as other modules have it
%Error: Exiting due to 1 warning(s)
两个细节值得记住:一是 warning 默认即 fatal,想放行得 -Wno-TIMESCALEMOD 或 lint_off;二是实测发现这个 warning 与文件顺序有关——无 timescale 的文件排在带 timescale 的文件之前才触发(复现素材在 pitfall/counter_no_ts.v)。处置:工程内所有模块统一写 `timescale,或统一不写。
坑 3:注释以「verilator 」开头被当成 lint pragma。 我们在代码里写了一句「// verilator 要求:……」的中文注释,verilator 直接把 // verilator ... 当元注释解析,报 Unknown verilator comment(out/err-metacomment.log):
%Error: pitfall/metacomment.v:3:1: Unknown verilator comment: '/*verilator 要求:这句话会被当成 Unknown verilator comment*/'处置:注释里提到这个工具时,别让「verilator 」出现在注释开头,写成「本工具」「Verilator 的」之外的任何起头都行。
六、什么时候选谁
| 场景 | 推荐 | 理由(本篇实测支撑) |
|---|---|---|
| 写 RTL 时的快速冒烟(几千~几十万拍) | iverilog | 编译 11 ms,改一行立刻重跑 |
| 长仿真(千万拍以上) | verilator --binary | 实测快 3.0 倍,拍数越多越赚 |
| CI nightly 回归(同一设计反复跑) | verilator --binary | 构建一次,二进制反复用,摊薄 4 s 构建 |
行为级 TB(# 延迟、复杂 initial) | 两者都可 | verilator 需 timing 模式,加速比会打折扣 |
| 可综合大设计的性能回归 | verilator | 两态化主场,加速比远大于本篇的行为级场景 |
这一篇在知识体系里的位置
本篇是 eda-lab 仿真段的速度对比篇:上游是 iverilog 编译与 vvp 仿真(事件驱动路线的基本用法)和 Verilator 高速仿真与 lint(编译型路线的用法总览);想弄明白「为什么编译型比事件驱动快」的内核原理,接着读 编译型仿真器内核:VCS/Xcelium/Verilator。同池相邻篇:el-iverilog-first-sim(iverilog 入门实验)、el-verilator-lint(--lint-only 静态检查实验)。
总结
verilator --binary 一条命令把带延迟的行为级 TB 编成原生可执行文件:同一份计数器 TB 跑 1000 万拍,实测比 iverilog 快 3.0 倍(4.55 s 对 13.71 s),代价是 4 秒的构建期——所以短冒烟用 iverilog、长仿真和回归用 verilator,而把 iverilog 风格 TB 搬过来时记住三件事:lint 要显式 --timing、全工程统一 timescale、注释别以「verilator 」开头。