IC项目版本控制Git有哪些坑:大文件、分支纪律与忽略清单
刚把软件行业的 Git 习惯带进 IC 项目的人,往往在第一年就踩齐三个坑:仓库半年涨到几十 GB 克隆不动;号称「流片版本」的代码谁也说不清是哪次提交;git status 永远一片红,真正改动的 RTL 被淹没在几百个工具生成文件里。这篇问答把这三类坑讲清楚,并给出可以直接落地的规避做法。关于目录怎么摆,配套阅读 RTL 项目目录结构怎么组织;关于工具链本身,见 EDA 工具链全景。
本文要回答的问题
- 为什么波形、网表这类文件不能让 Git 直接管?
- 「流片基线」应该用分支还是 tag,为什么不能改?
- EDA 工程的 .gitignore 该写哪些条目?
- 已经入库的大文件还有救吗?
简短结论
Git 为「文本、可 diff、频繁改动」的源码而生,IC 项目里大量产物是「二进制、巨大、由工具再生成」的,两者天生不合。正确的分工是:人写的进 Git(RTL、约束、脚本、testbench、文档),工具生成的一律不进(仿真波形、综合网表、日志、中间数据库),必须留存的大二进制走 Git LFS 或版本化制品库,流片基线用不可变 tag 冻结。下面逐条展开。
三条理由(也是三类坑)
坑一:大二进制直接入库,仓库被撑爆
一次门级仿真产生的 VCD/FSDB 波形动辄几 GB,综合后的网表、布局布线的数据库也是百 MB 起步。这类文件有三个共同点:二进制(Git 无法 diff,只能整份存)、体量大、每次运行都会重新生成——意味着每次提交都在仓库历史里永久多一份完整拷贝。一个迭代活跃的项目,半年就能把仓库推到几十 GB,git clone 变成新成员入职的第一道酷刑。
更隐蔽的是:Git 的历史是只增不减的,事后把文件删掉也不能让仓库瘦下来,必须用 git filter-repo 之类的工具重写历史才能清除,代价是所有人的本地仓库都要重新克隆。
下面这张对比卡把「该进 Git」和「不该进 Git」的两类文件放在一起看,判据是三个问题:是不是人写的?能不能被工具再生成?是不是文本可 diff?
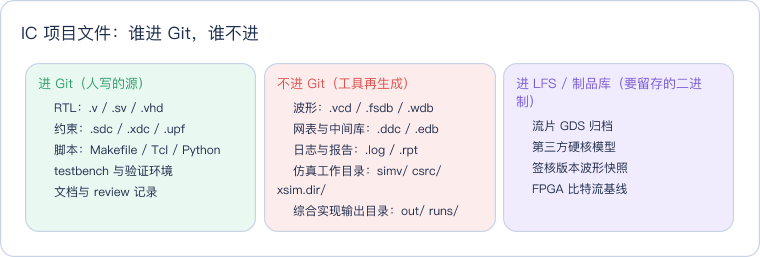
读这张卡抓住一个分界线:左边一栏丢了就没了,必须版本化;中间一栏丢了随时可以重跑工具再生成,入库纯属浪费;右边一栏不能丢但又不适合 Git 管,走 LFS 或制品库。项目里九成争论都能用这三个问题当场裁决。
坑二:分支纪律缺失,「流片版本」无法回溯
IC 项目和软件最大的差别是试错成本:软件发错了可以热修,芯片流片错了是几百万和半年周期。所以「哪份代码去流片了」必须是可精确回溯、不可篡改的事实。
常见错误做法是用一个叫 tapeout 的分支来标记基线——分支本质是可移动的指针,任何人一次误 push --force 就能让历史永远失去这个锚点。正确做法是用 annotated tag 冻结基线,tag 打上就不动,名字里带日期与版本,例如:
# 流片基线:带说明的 annotated tag,打完不再动
git tag -a tapeout-2026-03-v1.0 -m "sky130 第一次流片基线,含 pad frame v3"
git push origin tapeout-2026-03-v1.0
围绕这个基线,日常开发的分层关系可以用一张图看明白——日常改在 feature 分支,合入 develop,到达基线时打 tag 冻结,hotfix 从 tag 拉出而不是从 develop 拉回:
读这张图注意两点:箭头全部向下,代表代码只能「流向」基线而不能反向修改基线;两个 tag 之间的 hotfix 路径是从旧 tag 拉出新分支修复、修完打新 tag——旧 tag 始终原样躺在那里,任何时候都能精确取出流片那份代码。这与 RTL 仿真通过不等于可以流片 讲的是同一套敬畏:基线管理是流片质量的最后一道护栏。
坑三:没有 .gitignore 清单,工作区永远脏
EDA 工具几乎每个命令都会在工作目录里拉一坨生成物:Vivado 的 .cache/、.runs/、.jou 日志,iverilog 的 a.out,Verilator 的 obj_dir/,Yosys 的 *.dot,各家仿真器的 csrc/、simv.daidir/、xrun.d/。不进 .gitignore 的后果是 git status 常年几十上百个未跟踪文件,真正的改动漏看、误 git add -A 把生成物一起提交——于是又回到坑一。
下面这份清单覆盖开源与主流商用工具链的常见生成物,可以直接作为项目模板起步,再按自己用的工具增删:
# 仿真生成物
*.vcd
*.fsdb
*.wdb
*.shm/
csrc/
simv
simv.daidir/
xsim.dir/
*.jou
*.log

# Verilator / iverilog
obj_dir/
a.out

# 综合与实现
*.ddc
*.netlist.v
out/
runs/
*.dot

# Vivado 工程生成物
*.cache/
*.runs/
*.sim/
*.hw/
*.ip_user_files/

# 报告与临时
*.rpt
*.rep
*.bak
*~
.DS_Store
两份对照着看:清单里每一行都能在上面「不进 Git」一栏里找到对应类目。团队约定新工具接入前先补 .gitignore 再跑第一次仿真,能省掉后面无数次清理。综合流程会产生哪些文件,可参考 Yosys 综合流程与报告解读 里跑出来的实际目录。
一个真实的演化例子
一个开源 PDK 学习项目的仓库演化史很典型:起初什么都在一个目录、什么都提交,三个月后仓库 4 GB,新成员克隆要等二十分钟;第一次整理后把波形与网表请出仓库、补上 .gitignore,体积不再增长但历史里的旧账还在;最后一步是用 git filter-repo 重写历史清掉旧大文件,全组重新克隆,并把「流片 tag + LFS + .gitignore 模板」三件事写进项目 README 作为铁律。这个项目后来送出去两次流片,两次都能用 git checkout tapeout-2026-xx 精确还原送出去的代码——这就是纪律换来的确定性。
下面这张思维导图把全篇的坑与对策收拢成一页,适合贴在项目仓库的 README 里当检查单:
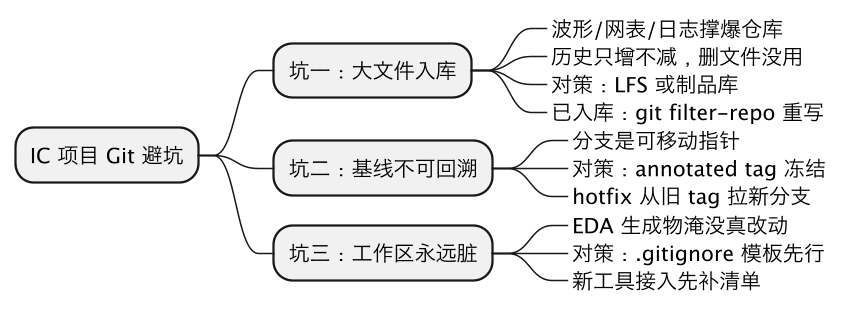
读这张图从上往下:三个坑各自的「症状 → 根因 → 对策」是一条线;团队落地时按右叶的三条对策各设一条仓库规矩,基本就堵死了最常见的翻车路径。
常见误区
- 「把大文件删掉再提交一次就行了」:不行。删除只是新增一个「删除」提交,历史里的二进制 blob 还在,仓库体积不变。必须重写历史。
- 「Git LFS 是银弹,什么大文件都往里放」:LFS 适合「需要留存但很少改动」的二进制(GDS 归档、硬核模型)。每次仿真都再生成的波形放 LFS 一样会撑爆 LFS 存储配额——再生成就别入库。
- 「tag 打错了删掉重打就好」:tag 一旦推送到远端并被他人拉取,删改就会制造「两个同名不同内容」的混乱。打错了打一个新版本号,旧的留着并在说明里标注作废。
- 「.gitignore 能补救已入库的文件」:不能。.gitignore 只对未跟踪文件生效,已入库的生成物要先
git rm -r --cached移出索引,清单才开始生效。
延伸阅读
- RTL 项目目录结构怎么组织——目录分层与本文的入库分工是同一件事的两面。
- EDA 工具链全景——看清每类工具会产生什么文件,才知道 .gitignore 要写什么。
- Makefile 还是 Shell:EDA 任务管理怎么选——生成物用脚本一键清理,是 .gitignore 之外的第二道保险。
- RTL 仿真通过不等于可以流片——为什么流片基线值得用不可变 tag 来守。
一句话总结
IC 项目用 Git 的坑集中在三处:工具再生成的二进制大文件入库把仓库历史永久撑爆(该走 LFS 或不入库)、用可变分支当流片基线导致无法回溯(该用不可变 annotated tag)、缺 .gitignore 让 EDA 生成物淹没真实改动(该模板先行、新工具先补清单);一句话原则——人写的进 Git,工具生成的进忽略清单,要留存的二进制进 LFS,流片基线进 tag。