FPGA 入门 15:阻塞与非阻塞——时序逻辑为什么必须用 <=
更新时间:2026-09-12。本文是
fpga/入门层第 17 篇。always 两种用法见 always 块与 case,锁存器问题见 意外锁存器。
本文要回答的问题
- 阻塞
=和非阻塞<=在仿真的同一个时间步里,到底谁先更新、谁后更新? - 为什么移位寄存器用
=会「三根寄存器串成一根线」,而<=能正确移一拍? - 非阻塞的「右值先采样、左值块末统一更新」是怎么精确对应真实触发器「时钟沿同时翻转」的?
- 为什么组合逻辑反而必须用
=,用<=会出现什么怪现象? - 什么是仿真竞争(race condition)?为什么简单设计「碰巧对」、复杂设计必错?
- Clifford Cummings 的四条经典赋值准则具体是什么,背后理由是什么?
- 为什么同一个 always 里不能混用
=和<=,也不能在多个 always 里驱动同一变量? - SystemVerilog 的
always_ff/always_comb如何在编译期帮你拦住赋值错误?
读完本文,你应当能对着任何一段时序/组合代码判断该用哪种赋值,能从仿真调度和硬件结构两个角度解释原因,而不是靠「老师说时序用小于等于」死记。
一、执行时机对比
阻塞 = | 非阻塞 <= | |
|---|---|---|
| 更新时机 | 立即,后面语句见新值 | 块末所有左值同时更新 |
| 模拟的硬件 | 组合传播(输入变立即算) | 寄存器沿上同时跳变 |
| 用在哪 | always @(*) 组合 | always @(posedge clk) 时序 |
二、移位寄存器对照
// ✅ 非阻塞: 沿后 a=旧b, b=旧c, c=旧d —— 正确移位
always @(posedge clk) begin
    a <= b; b <= c; c <= d;
end
// ❌ 阻塞: 顺序执行, a 最终=旧d —— 串成一根线
always @(posedge clk) begin
    a = b; b = c; c = d;
end非阻塞保证:所有右值用沿前旧值采样 → 块末同时更新,与真实 FF 一致。
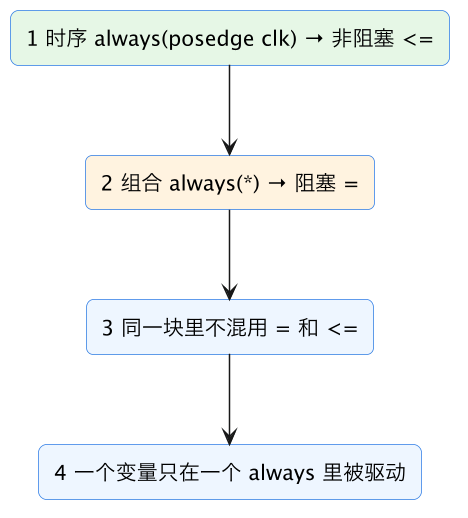
三、四条铁律(Cliff Cummings)
新代码推荐 SystemVerilog:always_ff(时序)/ always_comb(组合,写错或推断锁存器时工具报警)。
四、仿真调度:理解赋值差异的底层模型
Verilog 仿真器把一个仿真时刻(time step)内发生的事件分到不同「调度区(scheduling region)」,这是 = 与 <= 行为差异的根源。不必记住全部区域,理解下面这条主线即可:
- 活跃区(active):执行阻塞赋值、计算
always块等。阻塞=立即更新左值,同一块里后续语句马上读到新值,像顺序执行的程序。 - 非阻塞赋值更新区(NBA,Non-Blocking Assign update):执行
<=时,先在活跃区用当前旧值把右值算好、把更新事件排进 NBA 队列,等这一时刻所有活跃事件结束,再在 NBA 区统一更新所有左值。 - 时钟块用
<=,于是「读右值」发生在更新前(全是旧值),「写左值」统一发生在块末(全变新值),无论这些赋值在代码里什么顺序,结果都与书写顺序无关。
这恰好就是硬件:时钟沿到来前一瞬间,所有触发器 D 端是旧值,沿上它们同时把 D 打进 Q,彼此本次采样互不影响。非阻塞赋值不是语法糖,而是仿真器为了准确模拟「沿上并行更新」提供的机制。
一步步推演移位寄存器
设初始 a=1、b=2、c=3、d=4,看同一个时钟沿:
非阻塞写法(正确):进入块时先采样——a 的新值取旧 b=2,b 取旧 c=3,c 取旧 d=4,全部算完,块末一起更新成 a=2、b=3、c=4。三个寄存器各把数据往后移一级,正是移位寄存器。
阻塞写法(错误):a=b 立即执行,a 当场变 2;接着 b=c,但这与 a 无关,b 变 3;c=d,c 变 4。看上去这组也对?关键在于存在「后写的信号被同块前面读到」的链式情形,例如 a=b; b=c; 之后若还有语句读 a 做判断,读到的是刚被覆盖的新 b 而非沿前旧值;更典型的是反馈结构 b=a; a=a_in; 顺序不同结果就不同。综合器面对这种过程依赖,可能把本应独立的多级寄存器优化/串接成更少的寄存器或一根线,仿真结果随书写顺序变化,硬件里根本不存在这种「同一沿先后翻转」。结论:只要时序逻辑里有寄存器间的数据传递(移位、累加、状态、流水线),阻塞写法就是不可靠的,必须用 <=。
五、为什么组合逻辑反过来要用 =
组合逻辑没有时钟沿、没有「同时更新」的事件,它描述的是输入到输出的连续传播:输入一变,信号应像电流通过门电路一样立刻逐级算出新结果。
在 always @(*) 里,常常先用阻塞赋值算中间变量、再用它算输出。若用 <=,中间变量要到块末才更新,输出这次重算读到的还是旧中间值,需要等输入再变化、再触发一次才收敛,仿真出现「输出慢一拍/多轮才稳定」的怪现象,甚至产生本不该有的毛刺或仿综不一致。阻塞 = 的「立即生效、顺序传播」正好对应组合电路的传播过程。
记法与硬件对应:
| 组合逻辑 | 时序逻辑 | |
|---|---|---|
| 触发 | 任意输入变化 @(*) | 时钟沿 @(posedge clk) |
| 赋值 | 阻塞 = | 非阻塞 <= |
| 像什么 | 信号沿门电路立即传播 | 沿上所有 FF 同时翻转 |
| 综合结果 | LUT/连线 | 触发器 FF |
六、竞争:「碰巧对」为什么危险
竞争(race condition)指同一仿真时刻,结果依赖于没有定义先后顺序的事件顺序。两类典型:
- 时序块误用阻塞:多个寄存器互相喂数据时,更新顺序影响结果;换个仿真器、换种书写顺序、加一级优化,结果就变。
- 多 always 驱动同一变量:两个 always 在同一时钟沿都给一个 reg 赋值,谁后执行不定,仿真结果随机,综合则是非法的多驱动。
为什么简单代码「看起来对」?如果一个时序块里被赋值的寄存器之间没有数据依赖(各算各的),阻塞和非阻塞在功能上可能恰好相同;一旦出现移位、累加、q 依赖上一拍 q、状态转移这类「沿上要用旧值」的结构,错误立刻暴露。因为你无法保证设计永远简单,行业把它定为无条件遵守的规则,而不是「看情况」。
七、四条铁律逐条讲透
业界普遍引用 Clifford Cummings 在时序仿真论文中总结的准则,它不是风格偏好,而是为了让仿真调度与硬件行为严格一致:
- 时序逻辑一律非阻塞
<=:时序 always 描述沿上寄存器更新,NBA 调度保证「先全采样、后全更新」,与真实 FF 并行翻转一致。 - 组合逻辑一律阻塞
=:组合 always 描述连续传播,阻塞赋值让中间变量立即生效,一次输入变化即可收敛。 - 同一个 always 内不混用
=与<=:混用会让部分信号立即更新、部分延后更新,制造难以理解的半时序半组合行为,仿真和综合都可能分叉。 - 一个变量只在一个 always(或一个 assign)里被驱动:多驱动在硬件上是冲突,在仿真是竞争。需要多个来源改变一个寄存器时,在同一个时序块里用 if/case 选择来源。
两条补充实践:⑤要在一个沿上「同时交换」两个寄存器(如 {a,b} 交换、移位、冒泡),只能靠 <= 表达——所有右值取旧值、块末同时变;⑥新代码用 always_ff/always_comb,用错赋值符号时多数 lint/综合工具直接报错。
八、三个经典例子的正确写法
累加器(反馈依赖旧值)
always_ff @(posedge clk or negedge rst_n)
    if (!rst_n) acc <= '0;
    else if (en) acc <= acc + x;   // 右侧 acc 是沿前旧值, 块末才更新
若误用 =,在更复杂的多语句块里读到的 acc 可能是本块刚写的新值,破坏「每拍累加一次」的语义。
数据流水线(每级都取前级旧值)
always_ff @(posedge clk) begin
    s1 <= in;
    s2 <= s1;   // 取本沿之前的 s1
    s3 <= s2;
end
<= 保证一拍一级:s1 收 in、s2 收旧 s1、s3 收旧 s2。用 = 会在同一轮顺序覆盖,仿真里可能看到 s3 直接等于 in,三级流水线「塌缩」。
交换寄存器(同时更新)
a<=b; b<=a; 用非阻塞,块末 a、b 同时取到对方旧值,完成无损交换;阻塞写法第一句就覆盖,第二句读到新值,结果两个都变成同一个值。
这三个例子覆盖了 90% 的时序逻辑:反馈、级联、交换。只要看到「沿上要用旧值」,就确定无疑用 <=。
九、SystemVerilog 的兜底与常见误区
always_ff块里工具期望全是非阻塞、且是单时钟时序行为,出现=或组合推断会告警;always_comb里出现<=或推断锁存器会报错。让规则由工具强制,比靠人眼可靠。- 常见误区一:以为「
<=比较慢/有延迟」。它不插入任何延迟,只是调度时机不同,综合出的就是普通 FF。 - 误区二:在 testbench 里也到处用
<=。时钟块用<=驱动 DUT 是好习惯(避免与 DUT 在同一沿竞争),但初始化、打印等顺序过程用=更自然。 - 误区三:跨 always 传值想「立刻」看到。不同 always 块本就通过寄存器/连线在沿间通信,不要为了省一拍而在多块间用阻塞耦合。
- 跨时钟域的两级寄存器同步、握手是另一专题,本文的非阻塞纪律是其基础(见进阶 CDC 与亚稳态)。
十、自测要点与学习地图
自测:① 画出一个时间步内 active 与 NBA 的先后,说明 <= 为何与顺序无关;② 用 a=1、b=2、c=3 手推 a<=b;b<=c;c<=... 的沿后结果,再换成 = 说明风险;③ 解释累加器、三级流水线、交换三个例子为何必须非阻塞;④ 说明组合块用 <= 为什么会「慢一拍收敛」;⑤ 背出并解释四条铁律;⑥ 指出「一个 reg 两个 always 驱动」在仿真和硬件分别意味着什么;⑦ 说明 always_ff/always_comb 的编译期保护。
学习地图:先把两种 always 看熟 always 与 case;赋值错误常和锁存器、敏感列表一起出现,系统看 意外锁存器;用波形亲眼确认调度,见 看波形基本功;流水线与跨域深入见进阶 流水线与资源优化、CDC 与亚稳态。
十一、组合块里阻塞赋值的正确姿势:临时变量
组合逻辑复杂时,常先算若干中间结果再汇聚为输出,全部用阻塞 =、在同一个 always_comb 内按依赖顺序书写,读起来像顺序程序,但综合出来仍是纯组合电路:
always_comb begin
    p = a & b;        // 中间节点
    q = c | d;
    y = p ^ q;        // 汇聚输出,立即看到上面算出的 p、q
end
这里 = 的「立即生效」保证 y 用到的是本次输入变化后新算出的 p、q;若用 <=,y 这次会拿到旧 p、旧 q,输出滞后一次变化,仿真与综合可能不一致。要点:①这些临时变量若是局部于块的计算,可声明在块内或作为组合 reg;②仍要保证每个输出在所有路径都赋值(开头默认值),否则照样推断锁存器;③不要把这种「顺序写法」误当成时序——没有时钟沿、没有非阻塞,它就是一片 LUT。
assign 连续赋值与组合 always 怎么选
- 简单门级/单表达式(与或非、mux、位拼接)直接
assign y = sel ? a : b;,最清晰; - 带多分支、多输出、需要中间变量的组合逻辑用
always_comb+ 阻塞; - 两者等价时优先写更易读的那个;不要对同一信号既 assign 又 always 驱动(多驱动)。
- 时序逻辑只能在
always_ff里,不能用 assign 表达寄存器。
十二、testbench 里的赋值约定
理解调度后,testbench 的写法也有讲究(testbench 基础见 Testbench 与仿真):
- 时钟产生:
always #5 clk = ~clk;(阻塞即可,它是独立的周期性过程); - 驱动 DUT 的激励信号,尤其在时钟沿附近变化的,用非阻塞
<=,可避免激励与 DUT 在同一时刻的竞争(避免「DUT 采到旧值还是新值」取决于调度顺序); - 初始化块用
initial begin ... end,配合#10、@(posedge clk)控制时序,用阻塞顺序书写更直观; - 响应检查最好在时钟沿之后稍错开一点(如下降沿或
#2)采样,避免与更新区竞争读到中间态。
这些约定不会改变综合结果(testbench 不综合),但能让仿真稳定、可重复,避免出现「加一行打印结果就变」的灵异现象。
十三、动手实验:亲眼看到串线与交换
建议用一个 10 分钟的小实验固化理解:
- 写三级移位寄存器,先用
<=,仿真观察 a、b、c 逐拍后移; - 改成
=,重跑,观察波形如何「塌缩」、寄存器间依赖如何随书写顺序改变; - 写交换逻辑
a<=b; b<=a;验证沿后两值互换,再换=看到两值相同; - 写
always_comb用<=的错误组合块,观察输出滞后/警告,再改回=; - 对同一设计分别用不同仿真器/优化级别跑,体会错误写法的结果不稳定。
配合 看波形基本功,把「沿前旧值采样、沿末统一更新」在波形上对应清楚,比读十遍规则更有效。
十四、综合视角:赋值符号不改变你想要的电路,但改变工具能否做对
需要澄清一个常见误解:综合器通常足够聪明,很多情况下即使你在时序块误用 =,它仍可能按寄存器实现。那为什么还要严格遵守?因为:
- 综合与仿真可能用不同方式解释你的过程代码,一旦出现依赖,仿真对、硬件错(或反之)极难排查;
- 换工具、换优化等级、代码增长后,「碰巧对」会失效;
- 规范的写法让代码意图自解释:看到
@(posedge clk)+<=,读者立刻知道这是寄存器;看到@(*)+=,知道是组合逻辑,无需猜测。
因此把四条铁律当作「让仿真、综合、读者三方理解一致」的契约,而不是应付编译器的技巧。代码评审、lint 规则(见进阶 RTL lint)都会检查它。真正的硬件事实只有一句:寄存器在时钟沿同时把各自 D 端的旧值打进 Q 端;非阻塞赋值就是这件事在仿真语言里的精确表达。
十五、复位、使能与多寄存器:时序壳再巩固
把非阻塞放进真实工程里最常见的「时序壳」,一次看清几种要素如何共存:
always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) begin
        cnt <= '0;      // 异步复位:所有需要初值的寄存器都覆盖
        en1 <= 1'b0;
    end else if (clr) begin
        cnt <= '0;      // 同步清零:只在时钟沿生效
    end else begin
        en1 <= en;      // 使能信号打一拍
        if (en) cnt <= cnt + 1'b1;  // 带使能的计数
    end
end
要点:①同一个时钟沿,左值们各自用右值的旧值计算、块末一起更新,互不串扰;②复位分支务必给每个寄存器确定初值,遗漏的那个在仿真里是 x;③en1 比 en 晚一拍,正是非阻塞「级联即延迟一拍」的体现;④想让若干信号在同一事件下同时变化(如计数器到顶时同时清零、拉高 tick、更新状态),放心写在同一个块里用 <=,它们会在沿上一致更新,没有先后竞争。这与 always 与 case 里的时序壳完全同源。
为什么 testbench/RTL 里常见「#1 输出」
在一些代码中会看到组合输出写成 assign #1 y = ... 或 testbench 用 #1 错开赋值。RTL 里的 #1 仅用于仿真建模(如单元库延时模型),不可综合,普通设计不要写;testbench 里用微小延时是为了把激励/检查从时钟沿的竞争点挪开,属于仿真技巧而非硬件行为。初学者只要记住:真实时序靠时钟与寄存器表达,不靠人工延时。
十六、初学者高频追问
问:那我干脆所有赋值都用 <= 不就不会错了? 不行。组合逻辑用 <= 会导致同一块内中间结果不能立即被后续语句使用,输出需多轮触发才收敛,仿真出现滞后甚至毛刺,也违背「组合即连续传播」的语义。正确规则不是「全用一种」,而是「时序用非阻塞、组合用阻塞」。
问:为什么我在一个 always 里用 = 写计数器也能跑? 简单自反馈(cnt=cnt+1 单条语句)下阻塞和非阻塞的最终值可能相同,属于「碰巧对」。但只要同块里还有别的寄存器与 cnt 交互、或后续语句读 cnt,阻塞的立即更新就可能出错。规范做法不依赖「这里恰好简单」。
问:<= 既是非阻塞赋值又是「小于等于」,会冲突吗? 不冲突。编译器按上下文区分:在赋值语境(左值后)是非阻塞赋值,在表达式里是比较运算符。阅读代码时注意位置即可;书写条件比较时它表达小于等于,书写寄存器更新时它是非阻塞。
问:initial 里给 reg 赋初值算不算复位? 仿真里算初始条件;上板是否生效取决于器件是否支持上电初值。可靠控制逻辑仍用显式复位,initial 主要服务仿真(见 时钟与复位)。
问:一个寄存器要被「使能更新」和「外部清零」两种来源控制,怎么写不违反单驱动? 在同一个 always_ff 里用 if 优先级选择:先判复位/清零,再判使能,最后保持。不要分两个 always 块各写一半(那是多驱动)。
把这些追问想透,再配合 意外锁存器 里的组合陷阱,Verilog 过程赋值部分最核心的坑就基本扫清了。
十七、一条决策口诀与历史背景
实际工程里不必每次都推演调度区,记住下面这条决策顺序即可覆盖几乎所有场景:
- 这段逻辑有没有时钟沿、要不要记住历史?要记忆→写
always_ff @(posedge clk ...),赋值全用<=;纯当前输入决定输出→写always_comb或 assign,赋值全用=。 - 一个信号是否需要由多个条件改变?需要→在同一个时序块内用 if/case 选来源,绝不开第二个 always 驱动它。
- 多个寄存器是否要在同一沿「一起变」(移位、交换、流水线、状态+数据同拍)?是→放在同一时序块、全用
<=,右值天然都是旧值。 - 不确定时→优先时序 + 非阻塞 + always_ff,让 lint/综合工具报错来兜底。
理解这套规则为何存在也有价值:Verilog 诞生于上世纪 80 年代,最初是为门级/行为级仿真设计的语言,= 来自软件式顺序赋值,<= 是后来为描述「并发时钟事件」引入的非阻塞赋值。综合工具随后才把 RTL 子集映射到硬件。正因为语言本身早于「可综合 RTL 规范」,才需要 Cummings 这类论文把「怎么写才能让仿真与综合一致」整理成纪律。今天 SystemVerilog 用 always_ff/always_comb 把这些约定部分固化进了语法,但底层的调度模型没有变——读懂这条脉络,你就不会把赋值规则当成无意义的教条,而是理解为:**用一种为并发硬件设计的调度机制,去精确描述「沿上同时发生」这一物理事实。**这也是从「会写 Verilog」到「理解自己写的电路」之间,最关键的一道坎。后续写状态机、FIFO、流水线时,你会反复回到这个沿上并发模型;每次看到非阻塞赋值,都应在脑中浮现一排触发器在时钟沿同时翻转、各自采样旧值的画面。当这幅画面成为直觉,时序逻辑的写法、仿真的波形、综合出的寄存器三者就完全对齐了,很多原本要靠 debug 半天才能定位的问题,会在敲下代码的那一刻就被避免,写起时序逻辑来也会越来越笃定、不必反复猜测仿真结果。
十八、非阻塞赋值背后的仿真调度模型
为什么"时序逻辑里一律用 <="这条规则如此强硬?答案藏在 Verilog 的仿真调度机制里,理解了它,就不必再把规则当口诀死记。一个时钟沿到来时,仿真器并不是"立刻"把新值写进寄存器,而是把一次时间片切成若干调度区域。所有 always @(posedge clk) 块在活动区域里被求值,块内右侧读到的是这一时刻开始时各信号的旧值;遇到非阻塞赋值 b <= a,仿真器并不当场更新 b,而是把"右侧当前值"记下来,把对 b 的实际更新安排到本时间片稍后的非阻塞赋值更新区域。等所有时钟块都求值完毕,这些更新才一起生效。于是结果是:同一时钟沿上,无论这些块的求值顺序如何,所有寄存器采样的都是沿前的旧值、并在沿后统一变成新值,恰好对应真实硅片上一排触发器同时翻转的物理事实。
阻塞赋值 b = a 则完全不同,它在当前语句执行的当场就更新 b,后面的语句立刻读到新值。如果在时钟块里混用阻塞,结果就依赖于这些块在活动区域里的随机执行顺序:先执行的块改了值,后执行的块可能读到"本周期还不该有的新值",造成仿真顺序依赖、竞争,甚至综合与仿真不一致。值得澄清的是,综合器其实并不关心你用 = 还是 <=——它根据"时钟沿 + 非阻塞"这套 RTL 建模习惯推断触发器,真正的差别主要体现在仿真语义上。但正因为你既需要仿真行为可信、又需要综合结果与之一致,才必须用非阻塞去精确描述"沿上并发采样"这一事实。入门阶段能把"活动区域读旧值、更新区域统一写新值"这幅画面建立起来,对竞争、顺序依赖、为什么 testbench 里常用 #1 错开时间等现象就都能自洽解释,而不必再靠试错。
十九、阻塞赋值的合法舞台与混用边界
"时序逻辑用非阻塞"并不意味着阻塞赋值一无是处;恰恰相反,在它该出现的地方用对,能让代码更简洁、仿真更高效。阻塞赋值最典型的合法舞台有两个。第一是纯组合逻辑:在 always @(*) 或 always_comb 里,用阻塞赋值描述"输入一变、输出立刻按顺序重算"的组合关系是正确且自然的,块内甚至可以用多条阻塞语句表达"先算中间量、再算结果"的顺序求值,这与组合电路里信号沿导线即时传播相吻合;这里若改用非阻塞,反而会引入一个周期的行为偏差。第二是testbench 与行为模型:在激励生成、时钟产生、顺序激励序列里大量使用阻塞赋值和 #delay,因为这里描述的是"按时间顺序发生的测试动作",本质是顺序程序,用阻塞语义最直观。
真正危险的不是阻塞本身,而是"在同一个 always 块、对同一个信号"混用时序与组合两种语义,或在时钟块里用阻塞驱动稍后还要被别的时钟块读取的信号。可以把边界记成一句话:时钟动作(要进触发器、跨周期保持的信号)用 <=;即时计算(组合中间量)和 testbench 动作用 =。 同一个时序 always 块里,若需要临时变量参与本周期的组合运算再赋给寄存器,常见且可接受的做法是用阻塞算中间变量、最后对寄存器用非阻塞落盘,但这种写法要求中间变量不被其他块引用,团队风格统一时才可使用;更稳妥、对新手更友好的纪律仍是时序块内全部用非阻塞、把组合中间量拆到独立的 always_comb 里。把握"谁要进触发器、谁只是即时连线"这个判断标准,阻塞与非阻塞就不再是需要背诵的两条死规则,而是描述不同硬件行为的两件趁手工具。
常见坑对照
| 坑 | 后果 | 正确做法 |
|---|---|---|
| 时序块用 = | 移位/累加串线、顺序依赖 | 一律 <= |
| 组合块用 <= | 输出用旧值、仿真怪 | 一律 = |
| 同块混用 | 行为不可预期 | 块内统一一种 |
| 多块驱动同 reg | 多驱动冲突 | 单一驱动源 |
| 简单设计"碰巧对" | 换写法/工具就错 | 无条件遵守规则 |
相关与延伸
前置:always 块与 case、组合与时序逻辑。 跨时钟的寄存器行为:进阶 CDC 与亚稳态。
一句话总结
=(阻塞)立即更新、后面语句立刻看到新值,模拟组合逻辑的输入即变;<=(非阻塞)先用沿前旧值算出所有右值、块末同时更新,模拟真实寄存器在时钟沿上一起跳变——所以时序逻辑必须用 <=:移位寄存器若用 =,三条赋值顺序执行会把三个寄存器"串成一根线"(a 最终等于旧 d),而 <= 保证沿后 a=旧b、b=旧c、c=旧d,与硬件一致。记住业界四条铁律(Cliff Cummings):时序 always 用非阻塞、组合 always 用阻塞、同一块不混用、一个变量只由一个 always 驱动;写新代码直接用 SystemVerilog 的 always_ff/always_comb,写错赋值符号或组合块推断出锁存器时工具会直接报错。