track 高度库选型:7.5T/9T/12T 标准单元行高如何决定密度、性能与功耗的取舍
在 标准单元库与 PDK 多视图 里我们讲过同一个单元有 LEF/Liberty/GDS 等多张视图,本篇往物理实现方向再走一步:同一个工艺节点下,foundry 和库厂商通常会交付多套行高(track height)不同的标准单元库——常见的有 7.5T、9T、12T 等规格。选哪一套库作为设计主力,是综合与布局布线(P&R)开工前最重要的架构级决策之一,它直接锁定了芯片面积、频率上限和功耗预算的基本盘。后端的 时钟树综合 与 floorplan 与电源规划 都建立在这个选择之上。
本文要回答的问题
- 标准单元的「T」(track)到底是什么单位,7.5T、9T、12T 分别意味着什么物理结构?
- 行高变小为什么能省面积,代价又是什么?
- 行高如何影响时序(频率上限)、布线资源和 IR drop(电源压降)?
- 一个项目应该如何在 7.5T/9T/12T 之间做选型,混 track 设计有哪些坑?
一、track 是金属布线的「车道」,行高用「几条车道」计量
在先进工艺(16nm 及以下)里,标准单元的摆放是以「行」(row)为单位的:所有单元的电源轨(VDD/VSS)对齐,像书架上一排排等高的书。这个高度不用微米而用 track 计量——track 指的是该工艺最低层金属(通常是 M1 或 M2)的布线轨道间距(pitch,即中心线到中心线的距离)。说一个单元是 9T,意思是它的高度恰好容纳 9 条 M2 布线轨道从上方穿过。
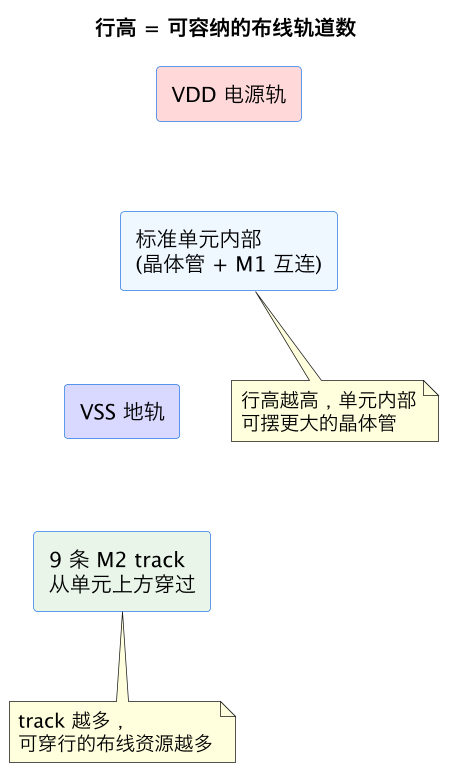
为什么用 track 而不是纳米?因为布线工具和布线资源都是按轨道离散布满的:一条 track 走一根线。行高用 track 计量后,「一行能容纳多少穿行走线」这件事可以直接用整数加减来算,P&R 工具的拥塞(congestion)评估也基于此。同一个节点下,N3E 工艺常见的组合是 6T(超高密度)、7.5T(高密度)、9T(平衡)、12T(高性能);N16FF 时代则是 9T/12T 的组合更常见。
需要澄清一个常见误解:track 高度不同,晶体管本身的沟道长度是一样的(同一工艺节点栅长固定)。变高的是单元内部留给晶体管「长胖」(更宽 fins / 更多 fins 并联)的空间,以及 pin 的可接触性。
二、密度、性能、功耗:行高改变的三件事
行高从 12T 降到 7.5T,面积收益是线性的:行高降 17%(12T→9T)意味着标准单元区面积大约等比例缩小。但代价是同时落在三个维度上。
| 维度 | 12T(高性能库) | 9T(平衡库) | 7.5T(高密度库) |
|---|---|---|---|
| 相对面积 | 1.33x | 1.0x | 约 0.83x |
| 单元驱动强度(fins 数) | 最多,大驱动 cell 齐全 | 中等 | 受限,大驱动 cell 少或没有 |
| 单元延迟(同负载) | 最快 | 中 | 慢 10%–20% |
| 漏功耗 | 最高(宽管多) | 中 | 最低 |
| pin 密度/可布线性 | 宽松 | 中 | 紧张,易拥塞 |
| 适用场景 | CPU 关键路径、SerDes 逻辑 | 通用数字 | 存储控制、低速外设、loT |
第一件事是驱动强度。 行高越高,单元内部能并排放更多鳍片(fin),晶体管有效宽度大,同样一个 buffer 的驱动电流就强,驱动大扇出(fanout)和长连线时延迟更低。高密度库常常干脆不提供 X16/X24 这类超大驱动单元——因为内部放不下。
第二件事是布线资源的两面性。 直觉上矮行挤出了更多硅面积,似乎布线更容易,实际恰恰相反:单元矮了,pin(引脚)在水平方向挤得更密,可接触的接入点(access point)变少,工具在做详细布线时更容易出现局部拥塞。同时行高变矮意味着每行上方能穿行的 track 数变少。所以高密度库往往需要降低单元利用率目标(比如从 75% 降到 65%)来给布线留裕量,会吃掉一部分面积收益。
第三件事是 IR drop。 行高变矮,VDD/VSS 电源轨的高度(宽度)通常也随之变窄,轨道电阻上升。在大电流瞬态下,矮行单元看到的电源压降更大,这会直接恶化时序,严重时触发功能失效。所以 7.5T 设计对 电源网络规划 的 power strap 密度要求更高。
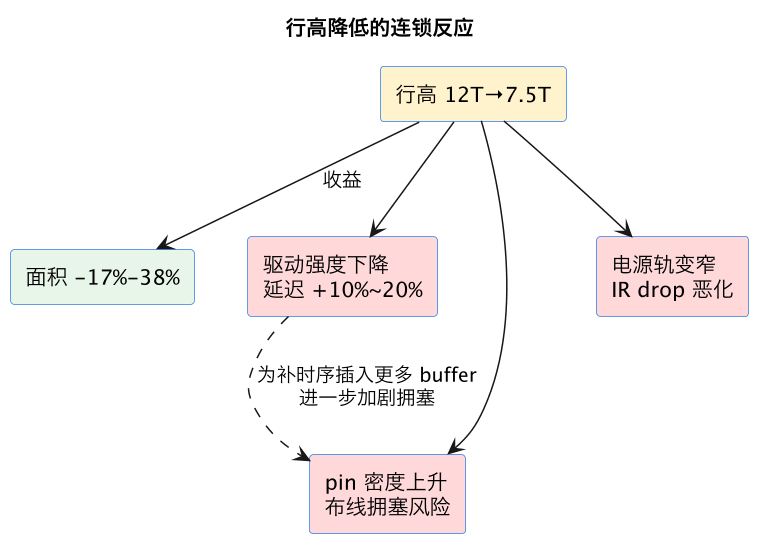
注意图中最容易被忽略的一条虚线:为了在高密度库里把关键路径的时序补回来,综合和 P&R 工具会插入更多 buffer、做更多 sizing(换大驱动单元),这反过来消耗面积和布线资源——高密度库的「名义面积收益」在时序紧张的设计里会打折。业界经验值:当设计频率压力较大时,7.5T 相对 9T 的实际面积收益可能从 17% 缩水到 8%–10%。
三、选型决策:先看频率目标,再看面积预算
track 高度库选型不是后端工程师关起门来拍的,而是架构、前端、后端一起定的 PPA(Performance/Power/Area)目标拆解结果。一个可照做的决策流程是:
- 拿频率目标反推行高。 用目标 corner(通常是 SS 低电压角)做一个快速试验:拿 RTL 走一遍综合 + 简单布局,分别用 9T 和 7.5T 库,看最差路径(WNS)差多少。如果 7.5T 需要大量透支时序裕量(比如多吃掉 15% 周期),频率目标又卡死,就直接排除高密度库。
- 拿面积预算反推下限。 如果 die size(芯片面积)被封装或成本卡死,估算标准单元区面积,确认 9T 是否放得下;放不下才考虑为部分模块换 7.5T。
- 检查大驱动单元需求。 时钟树、复位树、高扇出控制网络需要大驱动 buffer。7.5T 库如果缺大驱动规格,时钟树综合 的插入延迟和 skew 都会变差,这一条要单独跟库厂商确认 cell list。
- 确认 signoff 资源。 多 track 混用意味着 MMMC(多模式多角)分析和物理验证的 corner 组合变多,signoff 收敛 周期会拉长。
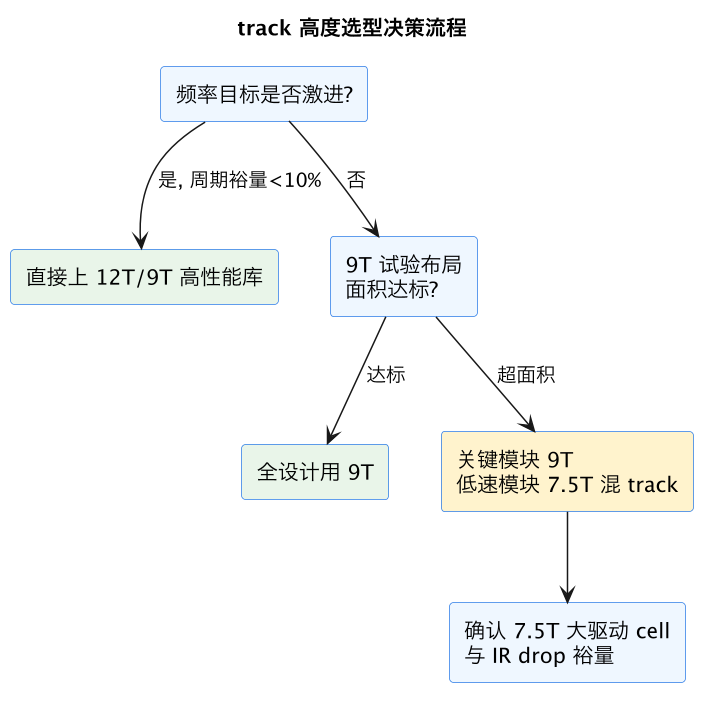
图中决策树的关键判据是「周期裕量」:如果目标频率已经吃到库延迟的极限(裕量小于 10% 周期),行高降档带来的延迟增加没有任何缓冲手段,只能选高行高库。反之,对于频率宽松但面积敏感的设计(如成本敏感的消费电子、IoT 芯片),高密度库几乎是默认选择。
四、混 track 设计:收益真实,坑也真实
主流 SoC 最常见的做法不是全设计一种行高,而是按模块混用:CPU/GPU 关键簇用 12T 或 9T,外设、总线 fabric、存储控制用 7.5T。混 track 在物理实现上有几个必须满足的硬约束:
- 行高对齐只在模块边界内部要求。 一个物理模块(block)内部所有 row 必须同一行高,否则电源轨对不齐、无法合法摆放。不同行高的模块在顶层拼接时,边界处的电源轨需要通过 filler cell 和顶层 strap 过渡。
- 接口时序预算要重切。 高低行高模块之间,低行高一侧的内部路径天然更慢,时序预算(timing budget)分配时不能按面积比例均分,要给低密度模块多留接口裕量。
- EM/IR signoff 要按最差库做。 混 track 芯片的 IR drop 分析不能用统一假设,7.5T 区域的电源轨电阻更高,要单独建模。
- 库版本基线必须一致。 不同行高库来自同一 PDK 同一版本基线(见 PDK 版本基线),不能混用不同批次表征的库,否则视图一致性风险会放大。
实践中的一个经验数字:合理的混 track 方案通常能拿到全高密度方案 70%–80% 的面积收益,同时保留关键路径 90% 以上的时序能力——这是它成为主流选择的原因。
这一篇在知识体系里的位置
本篇是标准单元库纵深的一篇横向专题:库的多视图与 PVT 角见 标准单元库与 PDK,库的 Liberty 字段语法见 Liberty 时序视图格式,行高选定之后的落地动作见 floorplan 与电源规划 和 时钟树综合,混 track 带来的多角分析负担见 signoff 收敛。track 高度库选型处在「架构 PPA 目标」与「后端物理实现」的交界,是少数几个一旦定错、中后期无法挽回的决策。
总结
track 高度库选型的本质是用行高换 PPA:7.5T 用约 17% 的面积收益换 10%–20% 的延迟惩罚、更紧的布线拥塞和更差的 IR drop,12T 反之,9T 居中——选型时先用频率目标反推行高下限、用面积预算反推行高上限,再优先采用「关键模块高行高 + 低速模块高密度」的混 track 方案,并提前确认大驱动单元规格与电源网络裕量。