UVM monitor analysis port:采样广播、analysis_imp 订阅与一 port 多 imp 扇出全解
更新时间:2026-09-28。在 SystemVerilog TLM 通信 里我们已经把 port/export/imp 的连接体系讲了一遍,其中 analysis_port 只占了「一对多广播」一节。这一篇把镜头对准验证环境里使用频率最高的那条通路:UVM monitor analysis port——monitor 采到事务之后,怎样一次
write同时喂给 scoreboard、coverage collector 和日志模块,订阅侧又该怎样实现才不踩共享句柄、慢订阅者这些坑。
本文要回答的问题
- monitor 的采样逻辑应该采到什么粒度,什么时候触发一次
write? - uvm_analysis_port 和普通 blocking_put_port 在语义上差在哪,为什么观测通路一律用前者?
- uvm_analysis_imp 的参数化和 write 实现有什么硬性要求?
- 一个 analysis_port 扇出给多个订阅者时,连接顺序、对象共享、慢订阅者各有什么讲究?
- scoreboard 要反压、coverage 要轻收,两类订阅者混挂时怎么接才稳?
一、monitor 的职责边界:采样、组装、广播
monitor 是 passive 组件:它只看不摸,绝不能驱动总线信号。它在 run_phase 里通过 virtual interface 盯着 DUT 引脚,把 valid/ready 逐拍握手还原成一笔完整事务,然后广播出去。职责就三件事:采样、组装、广播。至于这笔事务是给 scoreboard 比对、给 coverage 统计还是给日志打印,monitor 一概不管——这正是 UVM monitor analysis port 存在的理由。
采样的粒度决定 write 的时机。总线协议里一笔事务往往跨多拍:地址相位、数据相位、响应相位。monitor 内部要维护一个小状态机,凑齐一整笔才广播,不能采到半截就发,否则下游拿到的 addr 是对的、data 还是上一笔的残留。常见做法是采完响应相位(或协议定义的完成点)后,把字段填进一个新 transaction 对象,调 ap.write(tx)。
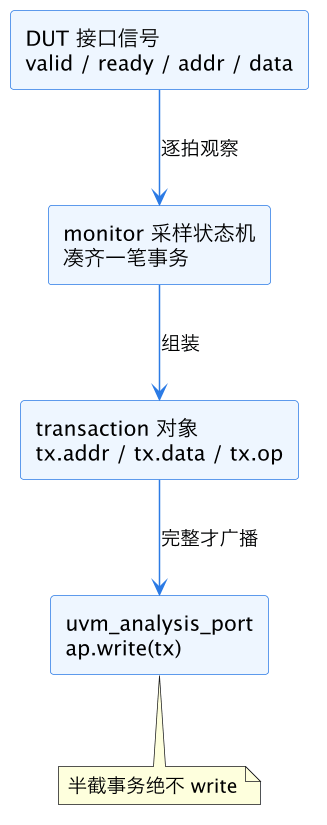
上图的核心判断是:write 的触发点是「事务语义完整」,不是「某个信号跳变」。协议里有 outstanding、乱序响应的总线(如 AXI),monitor 还要按 ID 维护多条在途事务的暂存队列,响应回来时才把对应事务收口广播。采错粒度的后果非常隐蔽——scoreboard 报 mismatch 时你会怀疑 DUT,实际上错的是 monitor 的组装逻辑。
工程上把这段采样逻辑写成「两段式」最稳:第一段是等待事件,一个 forever 循环只做一件事——等到事务起点出现(比如 valid && ready 同时为高的那一拍),这中间不调任何对象创建、不碰字段;第二段是打包事务,起点确认后才 create 一个新 transaction,逐拍把后续相位字段填进去,直到协议定义的完成点,最后一行 ap.write(tx)。两段式的好处是把「等」和「填」分开:等待段可以被复位打断而安全重入(用 disable fork 或 reset 标志丢弃半成品即可),打包段一旦开始就承诺要么完整广播、要么整体作废,绝不会出现广播了半笔的状态。很多团队把两段揉在一个循环里用 if 串起来,功能等价,但 reset 打断后的恢复路径往往漏写,第一段激励还没跑热就先在这一处翻车。
另一个边界问题是 monitor 要不要做协议检查。轻度的检查(如 X 态检测、握手违例)可以放在 monitor 里直接 uvm_error,但复杂的时序断言更适合独立的 protocol checker,参考 SystemVerilog monitor 与 protocol checker 分工。monitor 本体保持「采集器」的单一职责,出问题才好定位。
二、为什么观测通路必须用 analysis_port
同样是把事务送出去,monitor 面前有两个选项:uvm_blocking_put_port 点对点推,或者 uvm_analysis_port 广播。工程上观测通路一律选后者,原因在语义差异。
blocking_put 是 task,会挂起:目标没 ready,monitor 的采样线程就被堵住。观测通路的对端是 scoreboard 这类「事后处理」组件,它慢是它的自由,但绝不允许反过来拖住 monitor——monitor 被堵一拍,总线上背靠背的下一笔事务就采丢了。analysis_port 的 write 是 function,零时间消耗、立即返回,monitor 广播完立刻回到采样循环,语义上天然安全。
其次是订阅者数量。put 端口一一对应:一个 port 最终连一个 imp。而 monitor 的事务通常至少有两个去向(scoreboard + coverage),有的项目还有第三个(trace logger、性能统计)。analysis_port 内部维护订阅者列表,connect 几个就广播几家,monitor 代码对订阅者数量完全免疫。
class tx_monitor extends uvm_monitor;
  `uvm_component_utils(tx_monitor)
  uvm_analysis_port #(txn_t) ap;
  virtual tx_if vif;

  function void build_phase(uvm_phase phase);
    super.build_phase(phase);
    ap = new("ap", this);
    if (!uvm_config_db#(virtual tx_if)::get(this, "", "vif", vif))
      `uvm_fatal("NOVIF", "virtual interface not set")
  endfunction

  task run_phase(uvm_phase phase);
    txn_t tx;
    forever begin
      tx = txn_t::type_id::create("tx");
      collect_one(tx);          // 状态机凑齐一笔
      ap.write(tx);             // 广播后立即继续采样
    end
  endtask
endclass
注意两点:analysis_port 是普通对象,必须在 build_phase 里 new 出来,漏了 connect_phase 会报空句柄;write 之后 tx 句柄就交给了所有订阅者共享,monitor 下一拍应该 create 新对象而不是复用旧的——复用同一个对象反复改字段再 write,是典型的「订阅者读到脏数据」事故源。
write 的非阻塞语义值得单独说透。uvm_analysis_port::write 的实现是遍历内部订阅者数组、逐个回调各 imp 的 write,全程在同一个 delta cycle 里跑完,自身不消耗仿真时间;但「非阻塞」指的不是各家订阅者执行很快,而是 port 不等待任何返回状态——write 没有返回值,订阅者处理没处理、处理得对不对,port 一概不知。这是和 put 最本质的区别:put 挂起期间 initiator 被冻结,时间还在走;write 是同步函数调用链,谁慢就拖长这一个调用。订阅者数量为零时,数组遍历空转,write 静默返回,不报错不告警——这让 monitor 可以独立编译、独立单元测试,但也意味着「忘接 scoreboard」这种事故仿真不会替你发现,只能靠收尾的比对计数(scoreboard 收到 0 笔而 monitor 采到 N 笔)来兜底。所以带 scoreboard 的环境,check_phase 里核对「monitor 广播笔数 == scoreboard 收到笔数」是花一分钟写、能救一整轮回归的检查。
| 对比维度 | uvm_analysis_port | uvm_blocking_put_port |
|---|---|---|
| 方法类型 | function write,零时间 | task put,可挂起 |
| 订阅者数量 | 0 到 N,广播 | 恰好 1,点对点 |
| 反压能力 | 无,发了就走 | 有,目标不 ready 就堵 |
| 订阅者缺失 | 合法,空转 | elaboration 报错 |
| 典型定位 | 观测与分发 | 可靠交付与流量控制 |
三、analysis_imp:订阅侧的最小实现
订阅侧的标准元件是 uvm_analysis_imp #(T, IMP)。第一个参数是事务类型,第二个是宿主组件类型——因为 imp 收到 write 后要回头调用宿主的 write 方法,所以宿主必须真的实现签名匹配的 function void write(txn_t t),漏了就是编译错误,这点和 blocking_put_imp 要求宿主实现 put 完全对称。
class tx_scoreboard extends uvm_scoreboard;
  `uvm_component_utils(tx_scoreboard)
  uvm_analysis_imp #(txn_t, tx_scoreboard) analysis_imp;

  function void build_phase(uvm_phase phase);
    super.build_phase(phase);
    analysis_imp = new("analysis_imp", this);
  endfunction

  function void write(txn_t t);
    txn_t local_t;
    if (!$cast(local_t, t.clone())) `uvm_fatal("CLONE", "clone failed")
    exp_q.push_back(local_t);    // 只入队,重活留给 run_phase
  endfunction

  task run_phase(uvm_phase phase);
    txn_t t;
    forever begin
      wait (exp_q.size() > 0);
      t = exp_q.pop_front();
      compare(t);
    end
  endtask
endclass这段代码藏着三条经验。第一,write 实现必须轻量:它运行在所有订阅者共享的那次广播调用里,某一家 write 里做了查参考模型这种重活,整次广播被拖长,monitor 虽然不会被阻塞(write 是 function),但同次广播里排在这家之后的订阅者会被延后,仿真事件顺序变得难看。重活的正确姿势是 write 里只 clone 入队,run_phase 里再起线程慢慢消化。第二,入队前先 clone,原因下一节细说。第三,队列溢出要有兜底,要么在 write 里检查深度告警,要么收尾用 used() 式的余量检查,避免 scoreboard 线程死锁后事务静默堆积。
不想自己写这套壳子时,直接继承 uvm_subscriber #(T):它已经内建一个 analysis_imp 和一个待覆盖的 write,coverage collector 几乎清一色用这个基类,因为 coverage 的 write 通常真的只是 cov.sample(),足够轻。
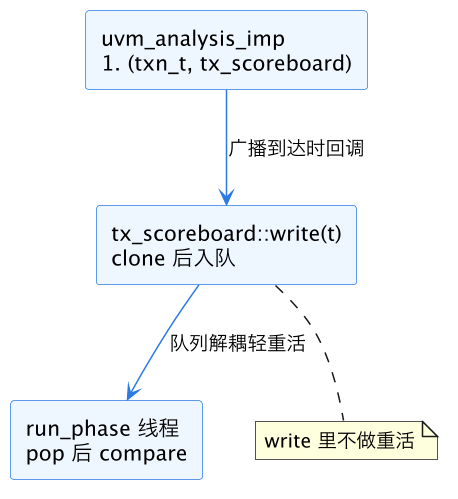
这张图表达的是订阅侧内部的「两段式」结构:imp 回调的 write 只做捕获,耗时的比对交给另一个线程。imp 与宿主之间靠类型参数绑定,write 与 run 之间靠内部队列解耦。
四、一 port 多 imp:扇出拓扑与共享句柄红线
一个 analysis_port 连多个 analysis_imp 是 UVM monitor analysis port 最典型的落地形态。连接全部在 env 的 connect_phase 里完成,每个订阅者一行 connect,monitor 零改动。
class tx_env extends uvm_env;
  tx_agent      agt;
  tx_scoreboard sb;
  tx_coverage   cov;
  tx_logger     log;

  function void connect_phase(uvm_phase phase);
    agt.mon.ap.connect(sb.analysis_imp);
    agt.mon.ap.connect(cov.analysis_export);  // uvm_subscriber 内建 imp 的暴露口
    agt.mon.ap.connect(log.analysis_imp);
  endfunction
endclass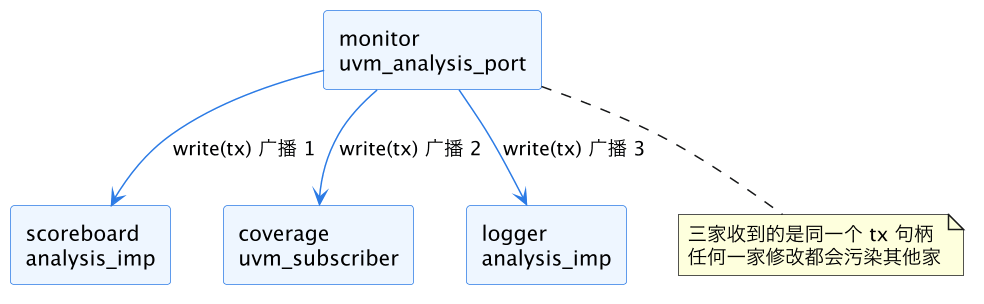
这张扇出拓扑图旁边的那行 note 是本篇最重要的一条红线:所有订阅者拿到的是同一个对象句柄,不是各自的拷贝。 广播的实现就是把列表里每个 imp 的 write 依次调一遍,参数传的都是同一个 tx。这意味着:
- 订阅者绝不允许修改收到的事务对象。scoreboard 里顺手给 tx 打个「已比对」标记、logger 里把字段格式化成字符串时动了原值,都会让排在后面的订阅者读到被污染的数据。广播顺序由 connect 顺序决定,于是 bug 表现成「换一下 env 里 connect 的行序,报错位置就变了」,极难排查。
- 需要留存事务跨时间使用的(如 scoreboard 入队等参考模型),必须在 write 里 clone,拿私有副本。浅拷贝还不够时要用实现了深拷贝语义的
clone(),UVM field automation 宏注册的字段才能被正确复制。 - monitor 侧每次 write 必须是新 create 的对象。复用旧对象等价于「monitor 自己就是那个修改共享句柄的人」,三家订阅者会看着同一个对象的字段在眼皮底下被下一笔事务覆盖。
扇出数量本身没有上限,但每多一个订阅者,广播就多一次方法调用,且调试时多一个怀疑对象。工程经验是把订阅者收敛到「比对、覆盖、记录」三类,更细的统计需求合并进这三家里做,而不是无限加新组件。
五、scoreboard 与 coverage:两类订阅者的不同接法
同样挂在 analysis_port 下,scoreboard 和 coverage 对通路的要求其实不一样。coverage 是「来了就采样,丢了也不致命」,轻收即可;scoreboard 是「一笔都不能漏,漏了就是漏测」,它的处理又慢(查参考模型、做数据比对),需要反压和缓冲。
analysis 通路本身没有反压——write 是 function,monitor 发了就走,不会等任何人。所以严谨环境里的标准接法是:scoreboard 这一支不直接挂 imp,而是先进 uvm_tlm_analysis_fifo,把广播转成可阻塞的 get 流;coverage 继续直挂。uvm_tlm_analysis_fifo 内部实现了 write(入队),对外提供 blocking_get_export,scoreboard 用自己的 get_port 按节奏取。
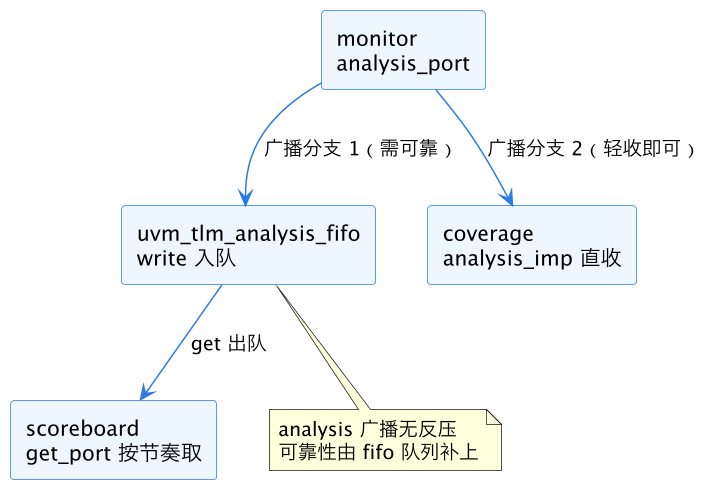
对照这张图记住选型判据:订阅者的 write 能不能保证永远轻量? 能(sample、打印),直挂 imp;不能(比对、建模),中间垫 analysis_fifo。scoreboard 直挂 imp 再把事务推进自己内部队列(如本文第三节的写法),语义上和垫 analysis_fifo 等价,二选一即可——内部队列要自己写 clone 和溢出检查,analysis_fifo 是现成组件,团队新人多时后者更省心。
fifo 满溢要有预案。uvm_tlm_analysis_fifo 默认无界,scoreboard 线程一旦卡死(等参考模型、等一个永远不会来的响应),事务就在队列里静默堆积,内存缓慢上涨,跑长回归才以仿真变慢、最终 OOM 的形式爆发,现场离根因已经很远了。对策有两个:一是构造时给有界深度,写满后 write 侧报 warning 而不是无声吞掉,把「消费方疑似卡死」在第一次发生时就顶到台面上;二是在 scoreboard 内部 watchdog,比如连续 N 拍 used() 单调上涨就告警。深度取值参考最长 burst 加监控裕量,不要拍脑袋给个 1——深度 1 的 fifo 退化成了两个元素的乒乓缓冲,反压效果约等于没有。
收尾检查也按这个拓扑做:用例结束、objection 落下之前,确认 analysis_fifo 的 used() 归零、scoreboard 内部队列排空。队列里躺着没被比对的事务,用例照样 PASS——这是最隐蔽的假性通过。复位场景还要注意 flush(),否则上一段激励的残留事务会在下一段被翻出来比对。
多 monitor 环境还有一个时间序对齐问题。SoC 级 env 里常有多个 agent 各自挂 monitor:请求从 A 口进、从 B 口出,scoreboard 要把两边的广播流合成一条轨迹做端到端比对。两个 monitor 的 write 发生先后由各自线程调度决定,同一时刻发生的事务到达 scoreboard 的顺序可能和真实先后相反。对策是给 transaction 加时间戳字段,monitor 打包时记 $time,scoreboard 侧按时间戳而不是到达序排序;乱序窗口大的话,analysis_fifo 出队后还要再过一道按时间戳归并的小缓冲。不做对齐的结果是两份数据都正确、比对却报时序违例,误报比漏报更消耗排查精力。
六、常见坑清单
- write 里做重活:拖慢整次广播,后续订阅者被延后;write 只做 clone/入队/sample。
- 修改共享事务对象:广播共享句柄,任何写操作都是全局污染;要私有副本就 clone。
- monitor 复用同一个 tx 对象:每笔事务必须新 create,复用等于自己污染自己。
- analysis_port 忘记 new:在 build_phase 里
new("ap", this),connect 阶段才发现就是空句柄 fatal。 - analysis_imp 第二参数写错宿主类型:回调找不到匹配的 write 方法,编译期就该暴露,别拖到 elaboration。
- 关键比对通路裸用 analysis 广播不做余量检查:analysis 无应答,订阅者漏收不会报错;收尾必须查 fifo/队列余量。
- 一个组件堆多个同型 analysis_imp:同名 write 冲突,需要
`uvm_analysis_imp_decl(_suffix)宏生成带后缀的 imp 类,宿主对应实现write_suffix。 - subscriber 顺序依赖:业务逻辑绝不允许依赖 connect 顺序,谁先谁后应该是无所谓的。
- 广播笔数没人核对:analysis 无应答,忘接 scoreboard 仿真照常跑绿;check_phase 里核对 monitor 广播数与 scoreboard 接收数。
- reset 打断采样状态机:两段式打包到一半遇复位,半成品事务要么显式作废要么随状态机整体重启,绝不能带着脏字段继续填。
- 无界 fifo 掩盖消费方卡死:给有界深度 + 满溢告警,或用
used()单调上涨的 watchdog,别让 OOM 替你发现问题。 - 多 monitor 按到达序比对:加时间戳字段按
$time归并,到达序是调度器行为不是真实时序。 - write 里调 sample 传局部句柄后缓存:coverage group 若缓存了句柄引用而非采样值,下一笔事务 create 前的窗口里读到的是旧对象,sample 一律只传值语义。
这一篇在知识体系里的位置
- 机制底座:SystemVerilog TLM 通信 讲 port/export/imp 全体系,本篇把其中 analysis 一支单独展开。
- 对称通路:sequence 与 driver/scoreboard 协作 讲激励侧 seq_item_port 的推拉,与观测侧 analysis 广播互为镜像。
- 下游组件:UVM scoreboard 轨迹比对 展开 scoreboard 拿到事务之后怎么做比对。
- 边界划分:SystemVerilog monitor 与 protocol checker 分工 说明协议检查为什么不堆在 monitor 里。
总结
UVM monitor analysis port 是观测侧的标准出口:monitor 用状态机凑齐完整事务后调一次 write,uvm_analysis_port 把它广播给所有已连接的 analysis_imp——订阅者必须轻收、不改共享句柄、需要留存就 clone,慢处理的 scoreboard 垫 analysis_fifo 补反压,快处理的 coverage 直挂 subscriber,一 port 多 imp 的扇出因此做到 monitor 对订阅者数量零感知。