STA 报告解析自动化:违例分布提取、瓶颈路径聚类与多轮趋势追踪的脚本工程化做法
更新时间:2026-10-05。STA 报告解析自动化是后端收敛后期最值钱的一项脚本工程:一个中等规模 SoC 在 signoff 阶段每轮回归要跑十几到几十个 corner/mode 组合的 STA,每份报告几千到几万条违例路径,靠人眼翻
report_timing输出既看不过来也看不出趋势。这一篇讲怎么把这件事工程化:先定解析的数据模型(一条违例路径要落库哪些字段),再写批量解析器把文本报告变成结构化表,然后在其上做三件事——违例分布统计、瓶颈路径聚类归因、跨轮次趋势追踪,最后接到回归系统里每晚自动出结论。读之前建议先有 Signoff STA 与 PrimeTime 的报告口径基础,回归框架侧的背景见 ASIC CI/CD 回归 和 数据流看板与 QoR。
本文要回答的问题
- 为什么靠人翻 STA 报告在 signoff 阶段必然崩溃,自动化解析的边界在哪里?
- 一条违例路径应该提取成哪些结构化字段,解析器怎么对付报告格式的各种坑?
- 违例分布统计该按哪些维度切,切完能直接回答什么工程问题?
- 瓶颈路径聚类怎么做——为什么修 timing 的单位是「簇」而不是「条」?
- 多轮回归的 WNS/TNS 趋势追踪怎么落库、怎么报警、怎么防止被噪声误导?
一、为什么必须自动化:报告规模先算笔账
先估算一下 signoff 阶段的数据量。一个 16nm 中等规模 SoC,STA 按 MMMC(Multi-Mode Multi-Corner,多模式多角)配置跑:功能、测试、扫描移位等 4-6 个模式,乘以 PVT 角(电压温度组合)6-12 个,再乘 setup/hold 两类检查,一轮全量回归就是几十到一百多份时序报告。每份报告 report_timing -max_paths 1000 -nworst 10 撒出去,输出几十 MB 文本,违例路径数以千计。全项目一轮回归的原始报告量在 GB 级。
人眼在这个规模下只能做两件事:看每份报告开头的 WNS(Worst Negative Slack,最差负裕量)和 TNS(Total Negative Slack,总负裕量)汇总行,然后打开最差的那份报告翻前 50 条路径。这意味着三个系统性盲区:其一,只看得到最差的 corner,次差 corner 里独有的违例形态被漏掉;其二,只看单条路径,看不到「三千条违例其实都穿过同一个模块接口」这种结构性信息;其三,看不到趋势——这轮 WNS 从 -120ps 变成 -95ps,是修好了还是换了个角落冒头,凭记忆对不上账。
自动化的目标不是替代时序工程师的判断,而是把「找问题」这一步压缩掉:脚本把几百份报告碾成几张表和几张图,工程师直接从「哪一簇路径、哪个模块、什么成因」开始干活。边界也要说清楚:解析脚本负责描述现状,修复决策(换 VT、插 buffer、改约束)仍然是人的事,脚本最多给出候选清单。
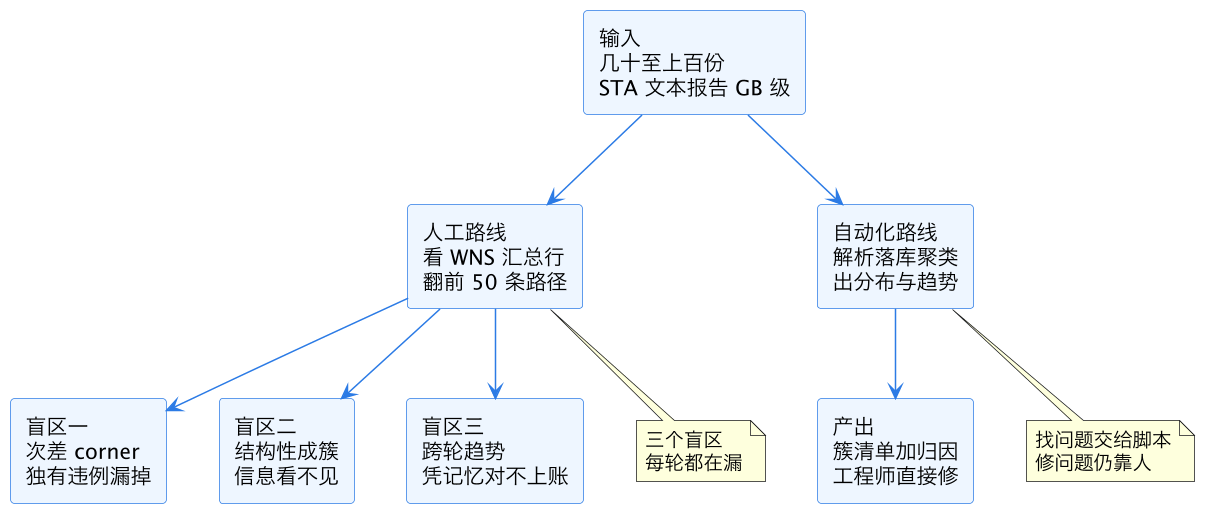
这张图对比两条路线:输入是同一批报告,人工路线在三个地方稳定漏信息,自动化路线把报告碾成可行动的簇清单。下面从数据模型开始讲怎么搭这条路。
二、解析器与数据模型:一条路径落哪些字段
解析器的第一步不是写正则,而是定数据模型——一条违例路径从文本里拆出来,应该变成一行什么样的记录。字段选少了后面统计做不了,选多了徒增解析脆弱性。工程上验证过的最小集分五组。
第一组是标识与归属:run_id(哪一轮回归)、corner、mode、check_type(setup/hold)、startpoint、endpoint、路径所属时钟组对(launch clock / capture clock)。这一组是所有统计的切片键。
第二组是数值:slack、path_delay、required_time、arrival_time、logic_depth(单元级数)、net_length 或 fanout 摘要(报告里有的话)。slack 是主排序键,logic_depth 和 fanout 是归因的重要特征。
第三组是结构特征:路径穿过的层级模块清单(从 startpoint 到 endpoint 的 hierarchical 前缀序列,例如 u_core/u_cpu/u_alu)、穿过的时钟域交叉点、是否包含 I/O 接口。这一组是聚类的原料。
第四组是单元画像:路径上占延迟 Top-N 的单元类型与实例(比如 DLY4_X1 出现 3 次贡献 40% 延迟)、是否有低 VT 与高 VT 混用。这组字段在 setup 修复换 VT 时直接当输入。
第五组是元数据:报告生成时间、工具版本、设计 netlist 的哈希或版本号——跨轮对比时用来确认「两轮跑的是可比的输入」,否则趋势分析会被 netlist 变更污染。
格式上的坑要提前防。PrimeTime 的 report_timing 输出里,换行折叠的长路径名、-path_type full_clock_expanded 带来的时钟网络段、SI 窗口的 delta delay 行,都会让朴素正则错位。稳妥做法是让工具输出时就为解析服务:统一用 -path_type full 或 summary 加 -fields 显式列字段,或者用工具自带的结构化导出(PrimeTime 的 report_timing -format 脚本化输出、Tempus 的 machine-readable timing report),能绕开文本居中对齐这一整类问题。解析器本身建议写成「先切 block 再取字段」的两段式:按 Startpoint: 关键字把报告切成路径块,每块内部逐字段提取,任何一块解析失败只丢这一块、记 warning,不让整份报告报废。
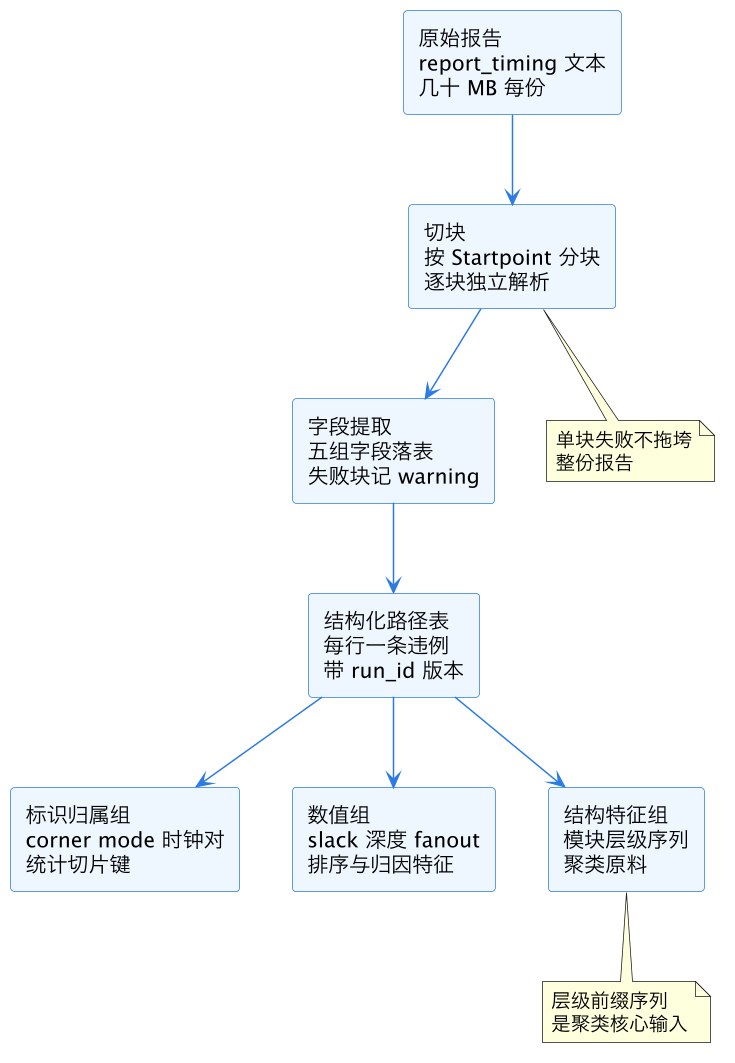
这张图是解析流水线和字段分组:先切块保证健壮性,再按五组字段落表,其中结构特征组(模块层级序列)是后面聚类节的直接输入。落库用 SQLite 或 Parquet 文件都够,别一上来就上数据库服务——单机脚本先跑通,数据量到千万行再升级。
三、违例分布统计:按哪些维度切、各回答什么
有了结构化路径表,分布统计就是切片聚合。关键是切哪些维度——每个维度都应该直接对应一个工程动作,不切无意义的片。四个维度是标配。
按时钟组对切:group by launch/capture 时钟对,看违例集中在哪些时钟关系上。如果 80% 的违例堆在 CLK_CPU → CLK_CPU 的寄存器到寄存器路径,说明是组合逻辑深度问题,走综合/优化路线;如果堆在 CLK_CPU → CLK_PERI 的跨域路径,先查约束是不是写了 multicycle 或者 IO 预算(参照 IO 时序预算约束)——这是修复路线的分叉口。
按模块切:把每条路径映射到它的「最低公共祖先模块」或穿越的顶层接口,group by 之后直方图一画,哪个子系统是瓶颈一目了然。这个动作直接决定下周找哪个模块的 owner 开会,也决定 ECO 的物理落点规划(见 PR 时序收敛 ECO)。
按 slack 区间切:把违例按 [-50ps, 0)、[-100ps, -50ps)、[-200ps, -100ps)、更差分桶。轻违例(-50ps 以内)通常靠 VT swap 和 sizing 批量清(见 setup 修复 VT 交换与 sizing),深违例(-200ps 以下)往往是架构或约束问题,要单独立项。一个健康收敛中的设计,桶分布应该逐轮向浅桶迁移;如果深桶长期不消化,说明有结构性问题被批量修复掩盖着。
按检查类型和 corner 切:setup 违例集中在 SS 低压高温 corner 是常态,hold 违例集中在 FF 低电压 corner 也是常态(hold 修复见 hold 修复 buffer 插入);如果分布违背这个常识——比如 hold 违例出现在 SS corner——八成是时钟树或约束异常,这个切片的异常本身就是 bug 报告。
| 切片维度 | 典型发现 | 直接动作 |
|---|---|---|
| 时钟组对 | 违例集中某跨域路径 | 查 multicycle/IO 预算约束 |
| 模块 | 某子系统占违例 60% | 约 owner 会议、规划 ECO 落点 |
| slack 区间 | 深桶长期不消化 | 立专项查架构或约束 |
| check × corner | hold 违例出现在 SS 角 | 查时钟树与 uncertainty 设置 |
| 单元画像 | 某 buffer 型号被滥用 | 更新 dont_use 或综合策略 |
四、瓶颈路径聚类:修 timing 的单位是簇不是条
单条看违例会得出一个错误的工作量直觉:三千条违例不等于三千个修复动作。STA 报告里的违例高度冗余——同一个坏起点扇出到两百个终点,就是两百条违例,但修好起点那一级逻辑,两百条同时消失。聚类的目的就是把这个冗余折叠掉,输出「真正要动手的地方有几个」。
工程上有三档聚类方法,按实现成本递增。
最简档是端点签名聚类:按 (startpoint, 穿过的一级模块序列) 生成签名,同签名归一簇。实现只需在字段表上 group by,十分钟写出来。对「一个坏起点扇出一堆违例」这类最常见的冗余折叠率极高,实测经常把几千条折成一两百簇。
中档是子路径重叠聚类:把每条路径的单元实例序列取出来,两两算最长公共子序列(或公共前缀),重叠度超阈值的路径并为一簇。实现用并查集加前缀树,几百行代码。它能抓到「不同起点但共享同一段拥堵逻辑」的簇——比如多条路径都穿过同一个 ALU 输出级。这一档的簇更接近物理修复的真实单位。
高档是特征向量加通用聚类:给每条路径构造特征(模块序列的 embedding、slack、深度、fanout),跑 DBSCAN 或层次聚类。表达力最强但可解释性变差,调参成本也高。工程经验是:先跑通前两档,确认簇清单能驱动修复会议,再考虑上不上第三档——多数项目用不上。
聚类输出必须带归因摘要才算成品:每簇给出代表路径(簇内最差那条)、共享的瓶颈单元或网段、涉及的模块与 owner、建议的修复方向(换 VT、重构逻辑、放宽约束)。修复进度也按簇追踪:这轮融资后簇 A 消失、簇 B slack 减半、簇 C 原样——簇 C 就是下轮要重点攻的。
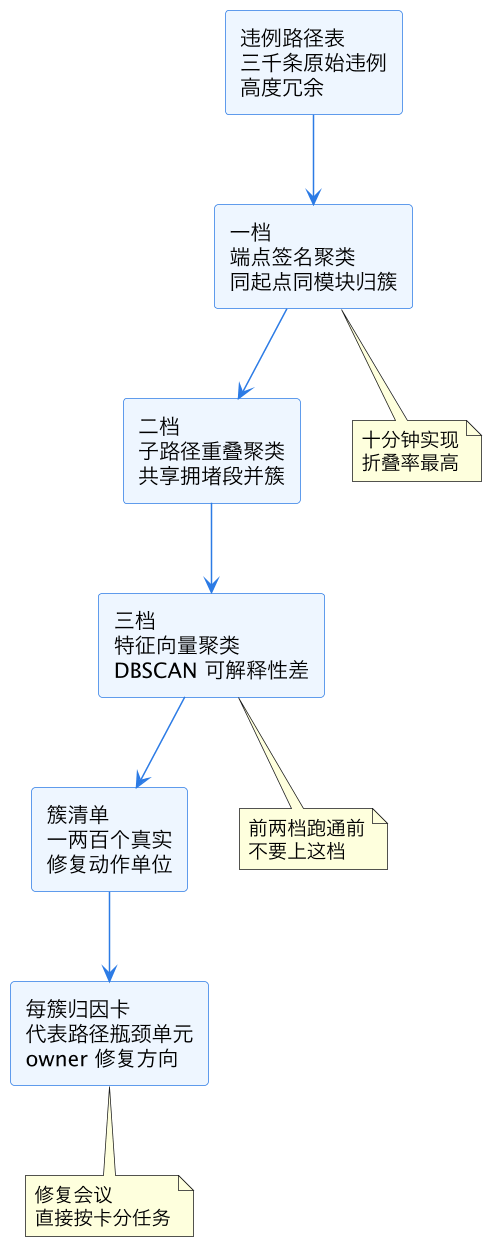
这张图是三档聚类的递进关系:实现成本递增、表达力递增,但工程收益主要集中在前两档。关键认知是簇才是修复的计量单位——「这轮消了 500 条违例」是虚的,「这轮消了 12 个簇」才是实的。
五、趋势追踪:跨轮 WNS/TNS 落库、报警与噪声识别
单轮分析回答「现在差在哪」,趋势分析回答「收敛得动吗」。后者对项目管理比对工程师更重要:tape-out 倒排期下,需要知道按当前收敛斜率还需几轮。
落库模式很简单:每轮回归完成后,解析器顺手把每份报告的头部汇总(WNS、TNS、NVP(违例路径数))按 (run_id, corner, mode, check) 落一张汇总表,簇级结果落另一张簇表(cluster_id 跨轮稳定——用簇签名哈希做主键,新一轮同签名即同簇)。两张表累积几轮,趋势图直接出:每个关键 corner/mode 一条 WNS 曲线、一条 TNS 曲线,叠加簇数量的变化。
报警规则要防两类噪声。第一类是输入变更噪声:两轮之间 netlist 变了(一次正常 ECO 合并),WNS 波动 ±20% 是常态,不能每轮都报警。做法是报警只看「同 netlist 基线的连续两轮」,或者 netlist 变更当轮只做记录不做环比。第二类是指标互换噪声:WNS 改善 30ps 但 TNS 恶化一倍,往往是最差路径被修掉后,次差的一簇浮上来——这不是恶化,是收敛的正常形态。所以报警要两个指标联合看:WNS 改善且 TNS 恶化不超阈值,判定为「健康换角」;两者同时恶化才是真回退,触发通知。
还有一个容易忽略的趋势维度是「簇的生死率」:每轮新增簇数和消亡簇数。收敛后期健康的设计,消亡速率稳定大于新增速率;如果每轮都冒出新簇,说明修复在制造新瓶颈(比如 sizing 把邻居路径推过阈值),需要调整修复策略而不是加速跑回归。
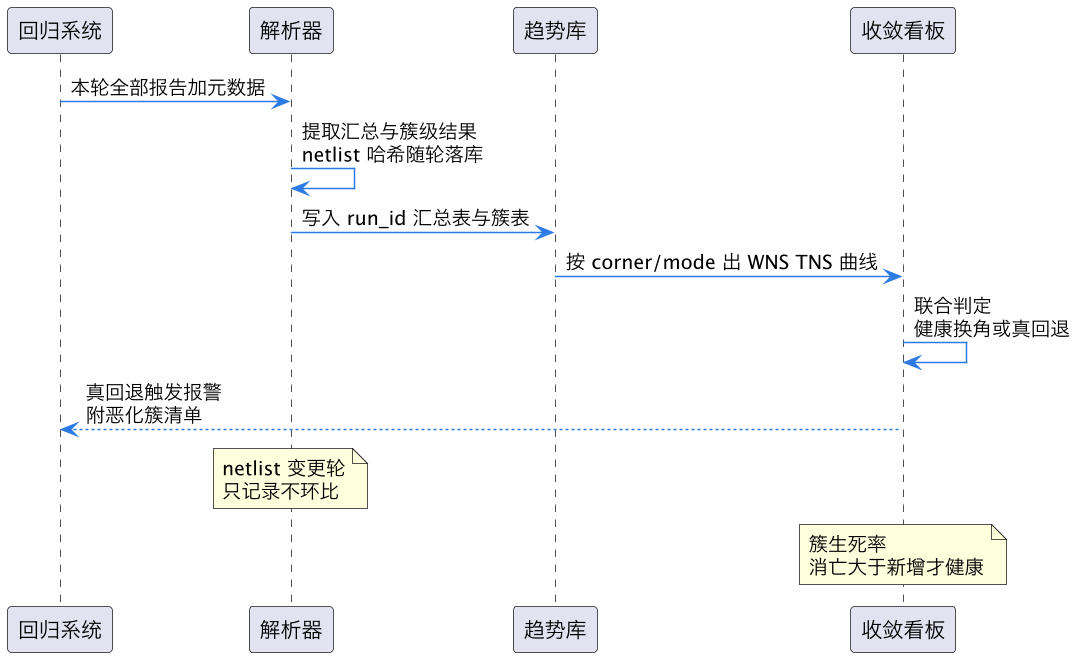
这张图是趋势链路的闭环:回归跑完自动解析落库,看板按 corner/mode 出曲线,联合判定过滤噪声后才报警。整条链路每晚无人值守跑,工程师早上看到的不是一百份报告,而是一条收敛曲线加一份回退簇清单(看板侧的集成见 数据流看板与 QoR)。
六、工程落地:脚本栈选型、性能与流程集成
脚本栈的务实选型:解析层用 Python 标准库加正则就够,别为上古 Perl 脚本续命;存储层 SQLite(千万行内无压力)加 Parquet 导出给数据分析;聚合与画图用 pandas 加 matplotlib,看板要交互再补一个 Streamlit 或接到项目已有的 Grafana。整条链路应该可以一条命令跑完:parse_sta.py --run 2026-10-05-nightly --report-dir ... --db trends.db,回归系统(见 ASIC CI/CD 回归)在 STA 任务完成后作为后置步骤触发它。
性能上的注意点有三个。其一,解析 IO 是瓶颈:几十份几十 MB 的报告,逐份串行解析要十几分钟,用多进程按报告并行能压到一两分钟——报告之间无依赖,天然易并行。其二,聚类计算是 O(N²) 的隐患点:子路径重叠聚类对三万条路径两两比对会爆炸,先用端点签名粗聚、只在簇内做精细重叠计算,把比对量降两个数量级。其三,趋势表要做 corner/mode 的枚举完整性检查:某轮某个 corner 没跑出来(license 不够、机器挂了),趋势图会断点,脚本要主动报「本轮缺 3 个配置」而不是悄悄画一条断线。
流程集成上最后一条纪律:解析脚本本身是签核基础设施的一部分,要和约束一样纳入版本管理与评审(约束侧的生命周期管理见 SDC 数据格式生命周期)。报告格式随工具版本升级会变(PrimeTime 大版本升级后字段顺序微调是真实事故),解析器要有针对样例报告的回归测试:仓库里存几份历史报告,CI 里跑解析、比对关键字段的期望值,格式漂移第一时间炸在测试里,而不是炸在某晚的趋势断点上。
这一篇在知识体系里的位置
本篇是 eda/ 目录里「签核数据工程」线上专讲 STA 报告自动化的一篇,处于 STA 知识与脚本流程之间:上游接 Signoff STA 与 PrimeTime 的报告口径和 STA GBA 与 PBA 分析模式 的违例语义,同层与 综合 QoR 报告解读(综合阶段的同类报告工程)、批量 ECO 脚本流程(聚类输出的下游消费者)并列,下游落地到 PR 时序收敛 ECO 的修复执行、ASIC CI/CD 回归 的 nightly 集成,以及 数据流看板与 QoR 的收敛可视化。握住了这套解析-聚类-趋势的三件套,STA 收敛就从「翻报告」升级为「看曲线」。
总结
STA 报告解析自动化的核心是把几十上百份时序报告从文本变成结构化数据,在其上做三件事:解析层按「切块再取字段」的两段式提取五组字段(标识归属、数值、结构特征、单元画像、元数据),单块失败不拖垮整份报告;分析层先做四维违例分布切片(时钟组对、模块、slack 区间、check×corner),每维直接对应一个工程动作,再做三档路径聚类(端点签名、子路径重叠、特征向量)把几千条冗余违例折成一两百个真实修复簇,簇才是计量收敛的单位;趋势层把每轮 WNS/TNS 与簇表按稳定签名落库,WNS 与 TNS 联合判定区分「健康换角」与真回退,netlist 变更轮只记录不环比,簇生死率消亡大于新增才是健康收敛。整条链路一条命令接入 nightly 回归,解析器本身要带样例报告的回归测试防工具版本格式漂移——工程师早上看的是收敛曲线和回退簇清单,而不是一百份报告文本。