良率模型:缺陷密度、芯片面积与泊松公式怎样联系起来
同一座晶圆厂里,小芯片和大芯片的制造条件可能相近,良品比例却往往不同。良率模型试图把这种差别写成可计算的关系:一片 die 上平均会出现多少致命缺陷,一个缺陷都没有的概率又是多少。最常见的随机缺陷模型是 Y=exp(-AD0),但它不是半导体制造的普遍定律,更不能替某一颗芯片宣判好坏。理解公式,必须同时理解独立随机缺陷、有效面积、参数拟合与模型边界;制造环节的物理背景可对照芯片制造基础。
本文要回答的问题
- 缺陷密度
D0、芯片面积A与良率Y分别表示什么,单位怎样保持一致? - 为什么“没有致命缺陷”的概率会写成指数函数,泊松模型依赖哪些假设?
- 缺陷在晶圆上成片聚集时,为什么负二项模型通常比简单泊松更合适?
- 模型参数为什么不能照抄别人,拟合时怎样避免把不同失效机制混在一起?
- 系统性缺陷、参数良率、晶圆边缘与测试覆盖为什么超出简单随机模型的解释范围?
一、良率先是统计比例,不是单颗芯片的确定答案
制造良率通常指进入某个统计口径的 die 中,通过相应判据者所占的比例。口径必须写清:是晶圆上的功能 die 比例,还是封装后的成品比例;测试条件、筛选步骤和分母是否一致,也会影响数字。本文讨论的随机缺陷良率更窄,主要估计“随机点缺陷没有造成致命功能故障”的概率,并不自动包含全部制造与测试损失。
把一枚 die 想成一块需要保持完整的区域。颗粒、残留或局部图形异常若落在不敏感的位置,未必影响功能;若切断关键互连、造成桥接或破坏器件,则可能成为致命缺陷。因此模型里的面积有时需要理解为与特定缺陷机制相关的有效面积或关键面积,不应不加说明地把所有缺陷和所有版图区域视为等价。
图中蓝色是观察与假设,橙色提醒面积口径,绿色才是模型给出的随机良率,紫色表示不能省略的边界检查。它强调一个常见误区:模型不是从“面积越大”直接跳到“良率越低”,中间还隔着缺陷类型、致命性和统计假设。
| 符号 | 含义 | 常用单位或范围 | 使用时要注明 |
|---|---|---|---|
A | die 面积或模型采用的有效面积 | mm² 或 cm² | 是否为全 die 面积 |
D0 | 单位面积上的平均致命缺陷数 | mm^-2 或 cm^-2 | 缺陷类型与统计条件 |
Y | 随机缺陷意义下的良品概率 | 0 到 1 | 测试与统计口径 |
λ | 单 die 的平均致命缺陷数 | 无量纲 | 在基础模型中等于 AD0 |
若 A=50 mm²,而 D0 以 cm^-2 给出,应先把 50 mm² 换成 0.5 cm²,再计算 AD0。把 50 直接乘到以平方厘米归一的缺陷密度上,会把面积放大一百倍,所得良率自然没有物理意义。
二、泊松模型:从平均缺陷数到“零缺陷”概率
泊松模型的关键不是记住指数,而是接受一组明确假设:在选定面积与缺陷类型下,缺陷计数可用泊松分布描述;不同小区域中的缺陷近似独立,缺陷出现率不随位置系统性改变;一个致命缺陷就足以使 die 在该统计口径下失败。此时,面积为 A 的 die 上缺陷数 K 的平均值为 λ=AD0,分布写作 P(K=k)=exp(-λ)λ^k/k!。
令 k=0,阶乘项为 1,就得到 Y=P(K=0)=exp(-AD0)。这里把“零致命缺陷”直接当成“良品”,所以公式只覆盖模型所承认的致命随机缺陷。若良率按百分比表示,再乘 100%;若某些缺陷不致命,或存在冗余修复,则平均缺陷数与实际失效概率之间还要增加相应机制。
假设演算,不代表任何真实产线:仅取 D0=0.2 cm^-2,比较 A=1、4、9 cm² 三种假想面积。泊松结果依次约为 81.9%、44.9%、16.5%。它只展示同一参数下指数曲线的趋势,不能据此预测任何 fab 的实际水平,更不能反推某工艺节点的缺陷密度。
假设面积 A | 平均致命缺陷数 AD0 | 泊松随机良率 |
|---|---|---|
1 cm² | 0.2 | 约 81.9% |
4 cm² | 0.8 | 约 44.9% |
9 cm² | 1.8 | 约 16.5% |
面积增大时,模型中的平均缺陷数线性增大,而零缺陷概率指数下降。这就是“大 die 对缺陷更敏感”的数学来源。反过来,不能看到某批大 die 良率偏低,就认定唯一原因是面积;设计可制造性、缺陷聚集或系统性失效也可能改变结果。
三、缺陷聚集与负二项模型:泊松为何可能过于悲观
真实晶圆上的缺陷不一定均匀独立。颗粒或工艺扰动可能在局部形成簇,一片晶圆、一个区域与另一个区域的缺陷水平也可能不同。结果是缺陷计数的离散程度常高于泊松分布所允许的程度:一些 die 缺陷很多,另一些则几乎没有。只用全批平均值 D0,会丢掉这种空间差异。
负二项模型常用 Y=(1+AD0/α)^(-α) 表示,其中 α 是缺陷聚集参数。α 越小,通常表示聚集越强;当 α 趋向无穷大时,该式趋近 exp(-AD0),回到泊松模型。这里的 D0 仍须与 A 采用一致面积单位,α 无量纲,并应通过数据拟合,而不是按“工艺越先进就取几”来指定。
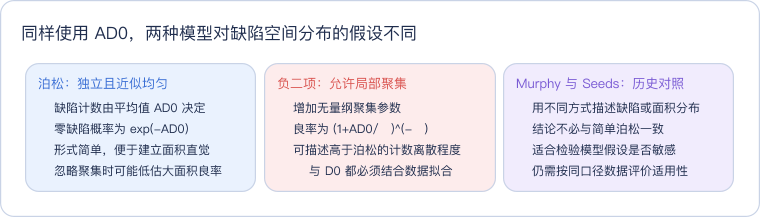
比较的重点不是“公式越多越准确”,而是额外参数是否对应真实观察。继续采用上一节纯假设的 D0=0.2 cm^-2,再假设 α=2:面积 1、4、9 cm² 时,负二项结果约为 82.6%、51.0%、27.7%,均高于相应泊松值,且大面积处差异更明显。这解释了聚集条件下简单泊松可能过于悲观,但并不证明所有产线都如此,也不代表这些数值有实测来源。
Murphy、Seeds 等历史模型也可作为对照,它们用不同方式描述缺陷密度或有效面积分布,结论不必与泊松完全一致。选型应看拟合残差、跨面积与跨批次表现以及机制合理性,而不是把某个名字当作行业标准答案。
四、参数必须拟合:模型是测量关系的压缩,不是通用常数表
D0 不是脱离工艺、产品、缺陷类型和时间仍保持不变的材料常数。即使同一产线,层次、设计密度、关键面积、工艺窗口和筛选口径变化,也可能让统一参数失去意义。α 同样需要从缺陷空间分布或不同面积产品的良率信息中估计。拟合的目标是让模型在一组明确数据上工作,而不是用公式替代数据。
一种直观做法是观察多种面积的随机缺陷良率。对泊松模型,ln(Y)=-D0A,在假设成立时,ln(Y) 对 A 近似为过原点直线,斜率给出 -D0。若不同面积明显偏离直线,可能提示聚集、面积口径不当或混入了其他失效机制;不能为了得到漂亮参数而随意删掉不合意的点。
| 拟合检查 | 要问的问题 | 可能暴露的问题 |
|---|---|---|
| 数据口径 | 产品、工艺、测试与时间是否可比 | 把不同总体强行合成一条曲线 |
| 面积定义 | 全 die 还是关键面积,单位是否统一 | 把版图敏感性误当缺陷密度变化 |
| 残差形态 | 偏差是否随面积或位置系统变化 | 聚集或系统性失效未被表达 |
| 参数稳定性 | 换一批数据后参数是否仍适用 | 过拟合单批样本或工艺漂移 |
| 外部验证 | 能否预测未参与拟合的面积与批次 | 只在拟合区间内部看起来准确 |
模型还应保留不确定性与适用范围。样本少时,观察比例本身就有统计波动;把系统性失效算进分母,再拿随机缺陷公式硬拟合,得到的 D0 可能只是吸收其他误差的“等效参数”,不宜继续解释成真实物理缺陷密度。
五、模型边界:系统性缺陷、参数良率与测试覆盖
系统性缺陷与版图图形、工艺步骤或特定结构的重复弱点有关,未必能用单位面积上的独立点事件表达。例如某类接触结构在特定版图环境下集中失效,其空间关系由设计和工艺共同决定。把 die 面积翻倍,并不意味着这种风险按同一方式翻倍。制造缺陷的物理机制多种多样,可参照天线效应与刻蚀工艺基础,但不要反过来把所有工艺问题都塞进随机点缺陷模型。
参数良率关心频率、功耗、漏电、模拟精度等指标是否落在规格内。一颗 die 可以逻辑功能完全正确,却因速度或功耗越界而失败;连续参数的分布、相关性和测试限不能由“零缺陷概率”自然推出。封装、键合、老化和最终筛选带来的损失,也需要在各自良率层次处理。
晶圆边缘则可能同时打破均匀性假设:边缘 die 的工艺条件、缺陷环境和完整 die 排布与中心区域不同。是否纳入边缘 die、如何处理不完整 die,都应写进口径。测试覆盖又是一层观察边界:测试通过表示“被现有测试判为合格”,不等于证明芯片不存在任何潜在缺陷;测试未覆盖的故障可能逃逸,过度严苛或误判也可能损失良品。
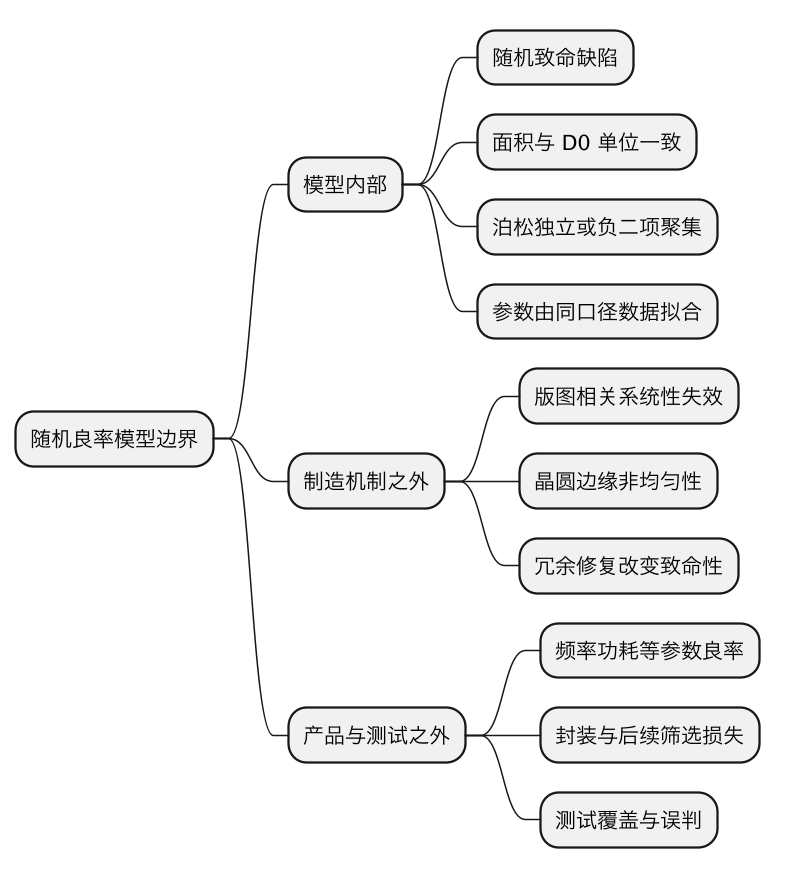
这张图的三个分支应分开阅读:中间模型内部是公式真正讨论的对象;制造机制之外提醒我们检查独立性与均匀性;产品与测试之外则说明“随机缺陷良率”只是成品分析的一层。把所有分支压成一个 Y,会掩盖可行动的根因。
实际使用时可先按失效机制分层,再对适合随机近似的部分选泊松或负二项模型,最后把参数分布、系统性问题和测试观察分别补齐。良率分解得清楚,才能判断应缩小面积、改版图、改善工艺,还是调整测试,而不是只对一条曲线做数学修饰。
这一篇在知识体系里的位置
本篇位于芯片制造统计与设计可制造性之间:向上需要理解缺陷来自具体工艺与结构,可回看芯片制造基础,并通过天线效应认识一种不能简单等同于均匀随机点的机制;向下做产品分析时,应把随机功能良率与参数、封装、测试分层。它也不同于芯片投入使用后的辐射错误统计,后者可参见软错误与 SER,两者的时间尺度、失效原因与数据口径不能混用。
总结
良率模型把缺陷密度、有效面积和随机致命缺陷联系起来:泊松假设下平均缺陷数为 AD0,零缺陷概率给出 Y=exp(-AD0);负二项模型用 α 表达缺陷聚集,并在 α 趋向无穷大时退回泊松。面积与缺陷密度必须使用一致单位,参数必须由同口径数据拟合和外部验证,假设演算不能冒充产线数据。缺陷聚集时简单泊松可能过于悲观,而系统性缺陷、参数良率、晶圆边缘、冗余修复及测试覆盖又超出基础随机模型。良率是一批 die 的条件化统计关系,不是对单个 die 好坏的确定预测。