hold 修复 buffer 选型:普通 buffer 和 delay cell 差在哪
hold 违例的修复手段一句话就能说完:往数据路径里塞延迟,让数据别跑太快。但「塞什么」有两派——直接插标准库里的普通 buffer,或者用库里专用的 delay cell(延迟单元)。两者都能加延迟,代价结构却完全不同:选错了,要么修复量估不准反复迭代,要么白搭面积漏电。hold 修复 buffer 选型就是这道二选一的速查。hold 修复的整体流程见 hold 修复与 buffer 插入,本篇只解决选型问题。
本文要回答的问题
- delay cell 和普通 buffer 在库单元层面有什么本质区别?
- 延迟精度、漏电、面积三项代价各差多少?
- 按修复量大小和场景,选型决策表长什么样?
- ECO 阶段选型还有哪些额外约束?
一、库单元层面的本质区别
普通 buffer 是为「驱动」设计的:两个反相器级联,目标是带载能力强、转换干净,延迟只是副产品——典型 X1 buffer 延迟在十几到几十皮秒量级,且随负载、输入 slew 变化明显。delay cell 是为「延迟」设计的:内部通常用弱驱动器件加长沟道、甚至加内嵌电容负载,把单位面积的延迟做到普通 buffer 的 3-10 倍,而且刻意让延迟对 slew 和负载不敏感——你不希望修 hold 的延迟量跟着周边环境漂移。
这个区别在库视图里能直接看到(库结构见 标准单元库与 PDK 视图):delay cell 的 timing arc 表格里,延迟对 output load 索引的斜率很平;普通 buffer 的斜率陡得多。选型第一条原则因此是:要的是延迟量就买延迟单元,要的是驱动顺带一点延迟才用 buffer。
二、三项代价对比
| 维度 | 普通 buffer | 专用 delay cell |
|---|---|---|
| 单位延迟面积成本 | 高(延迟小,要多级串联) | 低(单级延迟大) |
| 延迟精度 | 差,随 slew/load/角漂移大 | 好,刻意设计成低敏感度 |
| 静态漏电 | 每级都要漏电,多级累积 | 单级搞定同样延迟,漏电省 |
| 对前级的影响 | 输入电容小、驱动需求小 | 有的 delay cell 输入电容偏大 |
| 修复后复用性 | setup 变紧时可换成更小档或拆除 | 延迟是「死」的,调整粒度粗 |
| PVT 角间一致性 | 各角延迟比例与数据路径一致 | 慢角延迟增量大,利于 hold 但吃 setup 余量 |
表里最后一行值得展开。hold 修复要求最坏情况(最快角)的延迟增量也够用,而 delay cell 在快角的延迟缩水比例如果与数据路径其他部分不同步,快角下修复量就不足——所以修 hold 用的 delay cell 要看的是 ff 角、低电压下的延迟值,而不是 tt 标称值。角的选择逻辑见 PVT 角选择与 temp inversion 角选择(先进节点低电压下延迟-温度关系反转,快角未必是高温角)。
三、决策表:按修复量与场景选
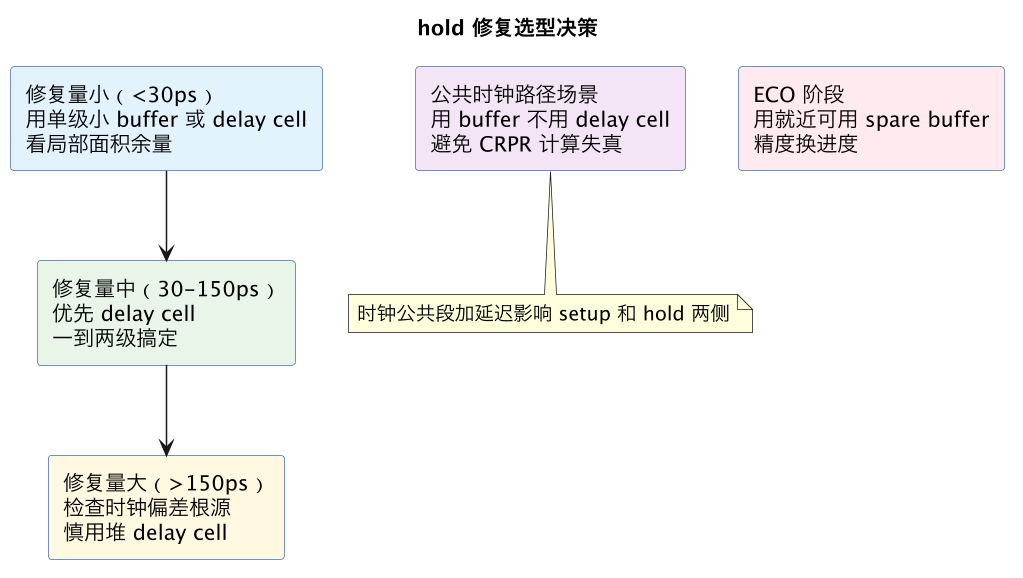
决策逻辑三点展开。第一,修复量超过 150ps 时先停手查根源:单条路径需要这么大延迟增量,八成是时钟偏差(clock skew)异常或例外约束缺失,堆 delay cell 是在给结构问题打补丁——先去查时钟树(CTS)和约束。第二,公共时钟路径上禁用 delay cell:时钟公共段加的延迟会同时影响 setup 和 hold 两侧,而且低敏感度 delay cell 会让 CRPR(公共路径悲观度减免,见 CRPR)计算失真,该场景只用普通 buffer。第三,ECO 阶段精度换进度:post-route 修 hold 只有 spare cell 可用,就近的 spare buffer 是什么档就用什么,延迟精度靠多插几级凑——这是 时序 ECO what-if 分析的常规场景。
四、选型后的验证闭环
选定单元插完不是终点,三件事必须闭环。一是回归全角 hold:修复量按 ff 角校核过,但插入改变了局部负载,tt/ss 角也要重跑确认没引入新违例。二是setup 余量复查:同一条路径 setup 和 hold 是零和的,hold 加的每一皮秒都在吃 setup 余量,插在 launch 数据路径上的延迟尤其要看住 setup 最差角(方法见 setup 修复 VT 换档与 sizing的反向视角)。三是功耗入账:大面积 hold 修复可能插入成千上万个单元,漏电增量要进 多 VT 漏电回收的账——能选 HVT 档位小尺寸解决就不要堆大驱动单元,修复单元的 VT 档一律按「最慢可用档」原则选,因为 hold 修复要的是延迟而非速度,慢档单元白送延迟还省漏电。
四是修复量分布复盘:每轮 hold 修复后统计插入单元的延迟分布直方图。如果大量路径集中在「刚好修过」的边际(增量小于 10ps),说明修复策略太贴线,任何 PVT 抖动都可能让违例复发,应该给修复目标加 5-10% 的余量系数;反过来如果大量路径修出远超需求的延迟,说明工具的贪心策略在浪费面积,值得调约束重跑一轮。
五、库选型与高级场景:把单元选对的一半功夫在库阶段
选型决策其实前移到库规划阶段就开始了。建库清单评审时要确认三件事:delay cell 的延迟档位是否成系列(比如 20ps/40ps/80ps 三档,覆盖常见修复量)、delay cell 是否有多 VT 版本(修复单元通常锁 HVT 省漏电,但低电压角延迟特性要先表征)、库文档里 delay cell 的「推荐用途」标注是否禁用了数据路径以外的误用。库缺 delay cell 系列时,PL(物理库)团队应向库供应商提需求,而不是让后端工程师拿 buffer 硬凑——硬凑的代价在前文的对比表里已经算清楚了。
两个高级场景单独说。一是低电压设计:近阈值/低电压下 delay cell 的延迟分布变差,单元间失配让「标称 40ps」的延迟实际可能落在 25-60ps 区间,修复量要按分布下限规划,统计分析手段见 SOCV/LVF 矩与波动。二是时钟占空比敏感场景:用两级反相器结构的 buffer 修 hold 对占空比几乎无影响,而某些 delay cell 内部上升/下降延迟不对称,串在脉冲敏感路径(如 latch 路径、脉冲时钟)上会扭曲占空比——这类路径修复后要专门查 rise/fall 延迟差。最后一个容易忽略的点:hold 修复插的每个单元都在改变局部密度,大面积修复后要过一遍 filler 与密度规则检查,别让时序修复引入物理验证新违例。
把这些场景汇总成一句选型口诀:数据路径修 hold 默认 delay cell,时钟公共段只用 buffer,低电压看延迟分布下限,脉冲路径查升降对称,ECO 就近取材。口诀之外的所有情况——尤其是修复量异常大的——先怀疑结构问题再谈单元选型,选对单元只是修好一条路径,修对结构才能少修一千条路径。
这一篇在知识体系里的位置
- 主线流程:hold 修复完整流程见 hold 修复与 buffer 插入,时序收敛大局见 时序收敛迭代方法学。
- 库与角基础:单元特性查 标准单元库与 PDK 视图,角选择见 PVT 角选择。
- 相邻修复手段:setup 侧见 setup 修复 VT 换档与 sizing,时钟侧根源见 CTS 与 useful skew。
总结
hold 修复 buffer 选型的核心是「买延迟还是买驱动」:修复量在 30-150ps 区间优先专用 delay cell(延迟大、精度高、漏电省),小修复量用单级 buffer 即可,大修复量先查时钟偏差根源;公共时钟路径只用普通 buffer,ECO 阶段就近用 spare buffer 精度换进度;插完全角回归 hold、复查 setup 余量、漏电入账,三步闭环才算修完。