自顶向下时序预算:top 层给 block 分配接口时序的方法论、收敛迭代与 ILM/ETM 衔接
更新时间:2026-10-03。层次化物理实现把一个几千万门的芯片拆成十几个 block 并行推进,拆开的代价是:每个 block 的工程师只能看到自己边界内的逻辑,边界上那根线的「另一半」在隔壁 block 或者 top 层。那么 block 的输入端口该按多少输入延迟约束、输出端口该留多少输出延迟?这就是自顶向下时序预算(top-down timing budgeting)要回答的问题。本站 层次化 STA 之 block 接口约束 讲的是 block 边界上接口模型怎么建、层次化流程 ILM 与 ETM 讲的是 block 抽象成什么模型给 top 用、IO 时序预算与约束 讲的是芯片对外引脚那一圈怎么分;这一篇聚焦它们中间的那一层——top 层给内部 block 分配接口时序的完整方法论:预算怎么生成、过松和过紧各是什么症状、迭代怎么收敛、生成完的预算怎么和 ILM/ETM 流程扣起来。
本文要回答的问题
- 为什么层次化设计必须做时序预算,不做预算让 block 自己约束自己会出什么事?
- 一份 block 接口时序预算从 top 层的什么数据生成,切分比例怎么定?
- 预算过松和过紧各自有什么症状,谁负责发现、怎么修正?
- 预算迭代几轮能收敛,收敛判据是什么,什么情况说明预算本身分错了?
- 预算和 ILM/ETM 抽象模型怎么衔接,top 用 ETM 签核和用全网表签核差在哪?
一、为什么必须有预算:block 自治的三种死法
先看没有预算会发生什么。最天真的做法是「接口五五分」:每条穿越 block 边界的路径,默认一半时间给源 block、一半给目标 block,写进各自的 set_input_delay / set_output_delay 就开工。这种做法在小设计上能糊弄,在真实 SoC 上会按三种方式死掉。
第一种死法是路径实际分布严重不均。一条从 block A 寄存器出来、穿过 top 层走 3 毫米、进 block B 只过两级逻辑就到寄存器的路径,五五分让 A 和 B 各背一半周期,可实际上时间大头在 top 的互连线上,B 拿到的是一份根本用不完的宽松预算,A 拿到的是一份怎么优化都不够的紧预算。第二种死法是连锁失衡:A 的预算太紧,A 的 owner 只能上大驱动、低阈值、插 buffer 硬扛,面积功耗全涨;B 的预算太松,B 的工具不做任何努力,结果 B 的输出路径懒懒散散,等到 top 层把 A、B 和真实互连拼起来一跑签核,整链还是不过。第三种死法更隐蔽——多个 block 共享的 top 段路径被重复消费:A→B 和 A→C 两条路径在 top 层共用一段走线,各自预算时都假设自己独占这段时间,合并起来就超支。
自顶向下预算的核心思想一句话:由 top 层掌握全局视角,先以全芯片扁平时序(或尽可能接近扁平的估计)为基准,把每条跨 block 路径的时间在「源 block 内部 / top 互连 / 目标 block 内部」三段之间显式切开,再把切出来的边界条件翻译成 block 级 SDC 发下去。预算是 top 对 block 的合同,合同的依据是全局时序事实,不是拍脑袋的比例。
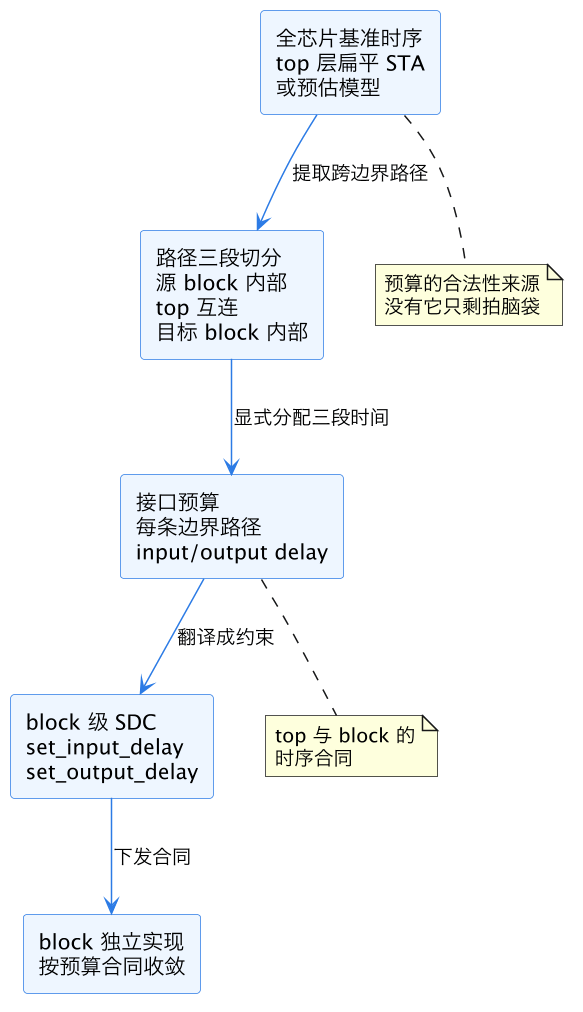
上图是预算生成的总链路。读图的重点是箭头的方向:信息从全局流向局部,合同从 top 发往 block。后面第二节展开的切分细节、第四节的迭代,本质都是在维护这条链路两端的一致性——block 实现出来的边界时序,要和当初切分时的假设对得上。
二、预算怎么生成:从一条路径到一份 SDC
预算生成的输入有三样:top 层的全芯片时序视图(早期可以是带预估线延迟的虚拟扁平网表,后期是带真实 ILM/ETM 的层次化网表)、block 边界定义(层次端口和 partition 划分)、以及全局的切分策略参数。
对一条穿越边界的时序路径,生成器做的是这样一笔账。设路径总预算为一个时钟周期(多周期路径按其约束),工具先算出路径在三个区段各自的「实际消耗」:源 block 内从寄存器到出端口的延迟 d1、top 互连 d2、目标 block 内从入端口到寄存器需要的余量 d3。三种区段的地位不一样:top 互连 d2 是 top 层的自有资产,由 top 的实现质量决定;d1 和 d3 是要分给两个 block 去「认领」的。切分策略管的就是当实际消耗和周期对不上时,差额往哪边记。
主流切分策略有三档。第一档是固定比例:比如源侧 40%、top 20%、目标侧 40%,简单可预期,适合项目极早期连网表都不全的时候。第二档是按实际消耗等比缩放:先用估计延迟算出三段实际占比,再按这个占比分配周期时间——路径天然在源侧长的,源侧就多拿,比固定比例公平。第三档是留裕量的非对称切分:在第二档基础上,给 top 互连和接口附近预留一块悲观裕量(常见 10% 到 20% 周期),因为接口逻辑在层次化流程里最尴尬——buffer 归谁插、走线归谁绕,责任边界模糊,预算上先留一手。商用工具的 budgeter(如 Fusion Compiler 的 budget 流程、Innovus 的 deriveTimingBudget)默认是第二档加第三档的混合。
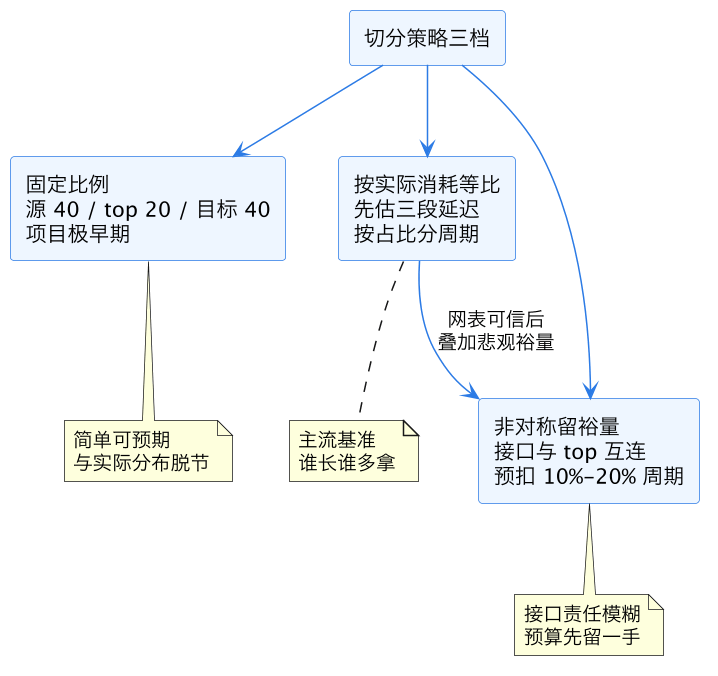
这张图读法是「随项目成熟度升级」:流片倒排期紧的项目,最早用固定比例把 block 队伍发动起来,网表和 floorplan 可信后切到等比,top 互连风险明朗后叠加非对称裕量。三档不是互斥选项而是同一流程的时间轴。
生成完还要做一步翻译:把每条边界路径的分配结果聚合成端口级约束。一个输入端口可能挂着几百条入射路径,预算取其中最严的那条作为 set_input_delay;输出端口同理取最严的 set_output_delay。同时生成时钟相关部分——边界上的时钟到达时间差(latency 差)直接折算进 input/output delay 的数值里,或者单独以时钟延迟约束下发,各家流程习惯不同但语义一致。
| 预算成分 | 数据来源 | 下发形式 | 常见坑 |
|---|---|---|---|
| input delay | top 互连 + 源 block 外部段 | set_input_delay(min/max) | 忘了分 max/min 两套,hold 失约 |
| output delay | top 互连 + 目标 block 外部段 | set_output_delay(min/max) | 负载假设与实际 top 走线不符 |
| 时钟 latency 差 | 各 block CTS 预估 | 折算进 delay 或单独约束 | block CTS 实际 latency 跑偏 |
| 例外路径 | top 扁平 STA 的 exception | 原样透传 false/mcp | 例外跨边界被截断丢失 |
上表是预算下发物的一张清单。其中「例外透传」最容易出事故:一条 set_multicycle_path 2 从 block A 内部指到 block B 内部,预算切开后 A 和 B 各拿到半条路径,如果例外没有正确改写成分段例外,两边的工具都会把它当单周期路径死磕。
三、过松与过紧:预算病的两种症状与处方
预算发下去之后,top 层的工作从「生成」转为「监测」。判断预算健康度的信号来自两侧:block 侧的收敛难易,和 top 侧把 block 模型拼回来之后的接口 slack。
预算过紧的症状很直接:block 的 owner 报告接口路径 WNS 迟迟收不干净,vt swap、 sizing、 buffer 全套打完还差几十皮秒,而且违规集中在端口附近的头几级逻辑。这时要警惕一个陷阱——block 为了够到过紧的 input delay,会在输入端口后立刻插大 buffer、把内部寄存器往端口方向搬,这些动作消耗的是 block 内部的面积和功耗预算,换来的可能只是一个本来就用不上的苛刻合同。处方是 top 复查这条路径的全局实际消耗:如果 top 互连实际比预算时估计的短,或者目标 block 内部有余量,就应该重新切分把宽松还给源侧。
预算过松的症状更隐蔽,因为 block 侧一片祥和——接口路径轻松过关,工具不做任何努力,输出端口慢悠悠地挂着小驱动。代价在 top 层爆炸:当 top 用 ILM/ETM 模型 把各 block 拼起来跑全芯片时序,发现接口链 slack 为负,而负的部分谁也说不清该谁修——每个 block 看自己都达标。这就是预算分配失去了全局最优性:局部全绿、全局不及格。处方是 top 在拼回模型后做接口路径的专项审计,把 slack 明显富余(比如富余超过 15% 周期)的边界挑出来,下一轮预算把这部分时间收回去给紧张的边界用。
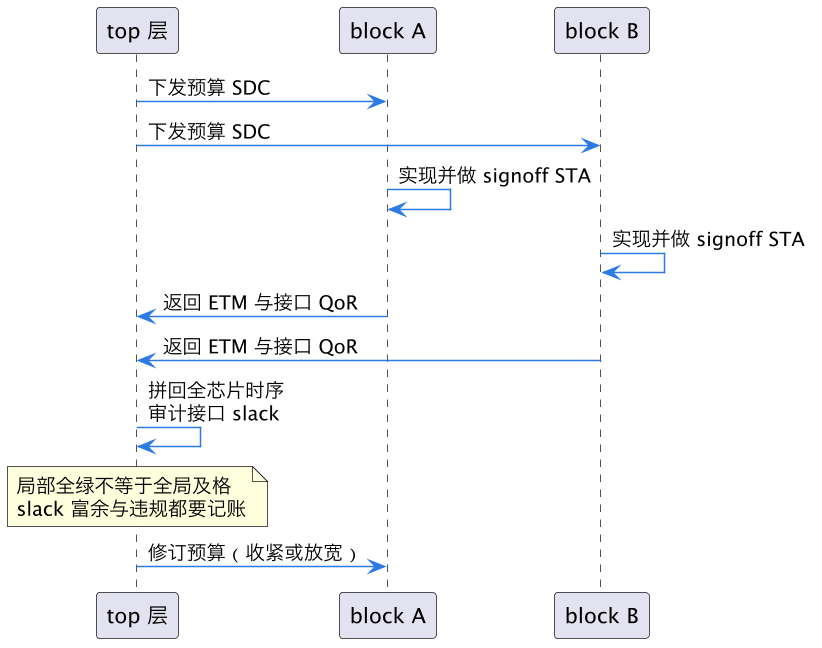
上面这张时序图是预算监测的一个完整回合。关键在最后两步:top 拼回模型后的审计是唯一能发现「过松」的环节,block 自己永远看不见这个问题;而修订动作必须由 top 发起,block 之间私下让渡预算会破坏全局账本。
四、迭代收敛:预算不是一次算完,而是谈出来的
实战中预算通常要迭代 2 到 4 轮。第一轮用估计模型快速发下去让 block 开工;第二轮等 block 有了初版实现、返回真实接口时序后,按实际消耗重切;第三轮处理长尾——那些怎么分都紧的路径,往往说明 floorplan 或层次划分本身有问题,比如两个交互密切的 block 被分在了芯片对角线上,这类问题预算修不了,要升级成 floorplan 与布局数据流 层面的返工。
收敛判据有三条,要同时满足。一是 top 层拼回全芯片后接口路径 WNS 达标且没有集中性违规带;二是每个 block 报告的接口 slack 落在设计窗口内——既不为负,也不普遍富余超过约定阈值(常见 10%-15% 周期);三是两轮之间预算的变动量小于阈值,说明分配已经稳定,再切也只是搬动数字。三条里最容易被忽略的是第三条:有的团队只看 WNS 达标就宣布收敛,结果每次 block 网表更新都触发预算大改,下游约束版本满天飞,SDC 生命周期管理 讲的约束版本地狱就是这么来的。
还要预䇥一类「收敛不了」的情形并准备升级路径:当某条边界在三轮迭代后仍然紧,而两侧 block 都证明内部已尽力,这时候矛盾已经不在预算而在结构——要么改层次划分(把强耦合逻辑并进同一个 block),要么在 top 层为这段互连加 pipeline 寄存器,要么动用 数据流 S5 签核收敛 里的 ECO 手段在 top 侧消化。预算工具的最后一项修养,是知道什么时候该说「这不是预算问题」。
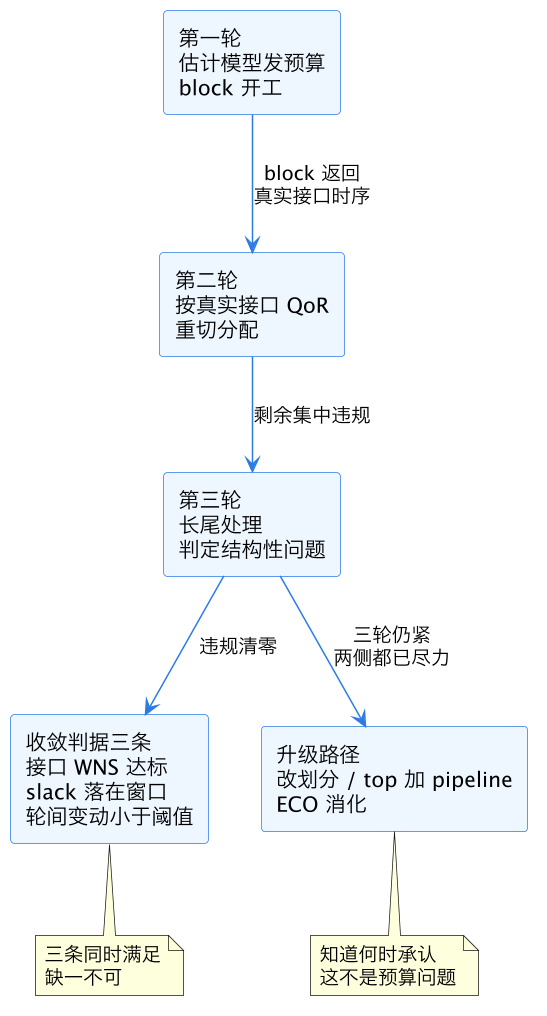
这张图的读法是「预算迭代有出口」:收敛是一个出口,升级是另一个出口。最差的局面是在 r3 和 r2 之间无限打转——每轮都微调预算、每轮都差一点,这通常意味着有人在用预算迭代掩盖 floorplan 缺陷。
五、与 ILM/ETM 的衔接:预算合同怎么变成签核语言
预算和抽象模型是层次化流程的一体两面:预算是 top 发给 block 的合同,ILM/ETM 是 block 还给 top 的履约凭证。衔接上有三个工程要点。
第一,方向一致性。预算生成时 top 用什么视图看待 block,拼回签核时就应该用对应的视图:预算阶段把 block 当灰盒(估计接口延迟),签核阶段换成 ETM(接口模型 里讲的 .lib 形式时序壳),两边的接口延迟语义必须对齐——ETM 里 arcs 的起点终点、时钟定义、以及内部寄存器到端口的 arc,要和预算时假设的切分点一致。对不齐的典型事故是预算把 clock latency 折算进了 input delay,而 ETM 又带了一份自己的时钟网络模型,重复计费导致接口 slack 平白紧张。
第二,反馈通道。block 每次交付新 ETM,top 应该自动跑一轮接口审计:比较 ETM 体现的接口实际延迟与预算假设的差异,差异超过阈值的路径进下一轮换预算队列。成熟流程里这是一段几百行的脚本,把「审计-差异报告-预算修订」串成无人值守的夜间回归,思路与 ASIC CI/CD 回归 一脉相承。
第三,终局视图。ETM 是效率妥协,精度上它有边界——模型里没有内部完整时钟网络,cross-block 的串扰、CRPR(时钟 reconvergence 悲观度削减)在 ETM 拼装的视图里会被高估悲观度。所以流片前的最终签核,关键接口路径要用全扁平网表或 ILM 复验一轮,把 ETM 时代记账的悲观度拿回来。预算迭代的最后一轮,也应该基于这个终局视图做最终确认,而不是基于 ETM 视图。
| 衔接点 | 预算侧 | 模型侧 | 对不齐的代价 |
|---|---|---|---|
| 时钟语义 | latency 折算进 delay | ETM 自带时钟模型 | 重复计费,接口假紧 |
| 切分点 | 端口为界 | ETM arc 起终点 | 边界漂移,slack 不可比 |
| 悲观度 | 预算含接口裕量 | ETM 高估 CRPR/串扰 | 双重悲观,误报违规 |
| 终局确认 | 末轮预算基于扁平视图 | ILM/全网表复验 | 签核口径不一致 |
这一篇在知识体系里的位置
本篇站在层次化方法论的枢纽位置:向上,它消费 数据流 S3 floorplan 与布局 给出的物理事实和 数据流 S2 综合交接 给出的网表视图;向 block 侧,它下发的 SDC 成为 block 接口约束 和 setup 修复、hold 修复 的作用对象;向 top 侧,它通过 ILM/ETM 拼回全芯片视图,最终在 数据流 S5 签核收敛 和 signoff STA 里交卷。芯片对外的引脚预算是另一条线,见 IO 时序预算与约束。
总结
自顶向下时序预算就是 top 层以全芯片时序事实为依据,把每条跨 block 路径的时间在源 block、top 互连、目标 block 三段显式切开并翻译成 block 级 SDC 合同,再靠「block 履约、top 拼回审计、修订重切」的 2-4 轮迭代收敛到局部全绿且全局及格,末轮基于扁平视图确认——它管的是层次化设计里「每个 block 的接口该留多少时间」这一件事,和接口建模、芯片 IO 预算各司其职。