ECO 脚本化:批量插 buffer、换 VT 与 size 调整的 change list 生成、dry-run、验证与回退全流程
更新时间:2026-10-04。ECO(Engineering Change Order,工程变更单)在物理实现后期几乎是日常:setup 违例要换低 VT 或加大尺寸,hold 违例要插延迟 buffer,DRV 要插缓冲器切断长线。单点修一条路径的方法在 setup 修复之 VT swap 与 sizing、hold 修复之 buffer 插入 里已经讲过;这一篇解决的是另一个层面的问题——当违例清单有 3000 条、离 tape-out 只剩两周时,怎么把这些修复脚本化:用程序生成 change list、先 dry-run 预演再真改、分轮批量验证、出问题能整体回退。读这篇之前建议先回顾 时序 ECO 的 what-if 分析 和 PR 时序收敛 ECO 的单点修复视角。
本文要回答的问题
- 为什么手工逐条 ECO 在几百条违例规模下必然崩盘,脚本化到底解决哪几个具体痛点?
- 一份合格的 change list 长什么样——字段、排序、冲突检测各管什么?
- dry-run 预演要在什么环境里跑,它和真实施之间的差异怎么控制?
- 批量实施为什么要分轮,每轮之后批量验证查什么、谁来当裁判?
- 回退机制怎么设计,才能保证任何一轮失败都能干净地回到上一轮的已知好状态?
一、为什么手工 ECO 扛不住批量
先算一笔账。一个中等规模模块在 signoff STA 阶段常见的违例画像:hold 违例 2000 条、setup 违例 400 条、max_transition 与 max_capacitance 各几百条。手工 ECO 的节奏大约是:读路径报告 3 分钟、决定修法 2 分钟、敲命令改网表 1 分钟、局部重算时序确认 2 分钟——一条 8 分钟,2000 条就是 260 个小时,还没算改完之后一次全量 STA 重跑的两小时和发现「修 A 路径弄坏了 B 路径」的返工。这显然不是人力能扛的,于是团队自然会写脚本。但「会写脚本」和「ECO 工程化」之间隔着四个坑:
第一,修单条看对了,批量叠加就错。每条修复都假设环境不变,但插一个 buffer 会占位置、会改变邻近线的负载,200 个 buffer 一起插下去,局部的拥塞和时序假设全部漂移。第二,修复之间有冲突。同一条 net 被两个违例各点名一次,两个脚本生成的命令互相覆盖。第三,错了回不去。直接在数据库上连改三天,发现越修越差时没有干净的还原点。第四,无法审计。review 的人面对一堆散落的 Tcl 片段,说不清「这批改动为什么是这样」。ECO 脚本化的本质,就是用一套固定产线把这四个坑填上:change list 管冲突与审计,dry-run 管叠加效应预判,分轮加批量验证管质量闸门,checkpoint 加回退管可逆性。
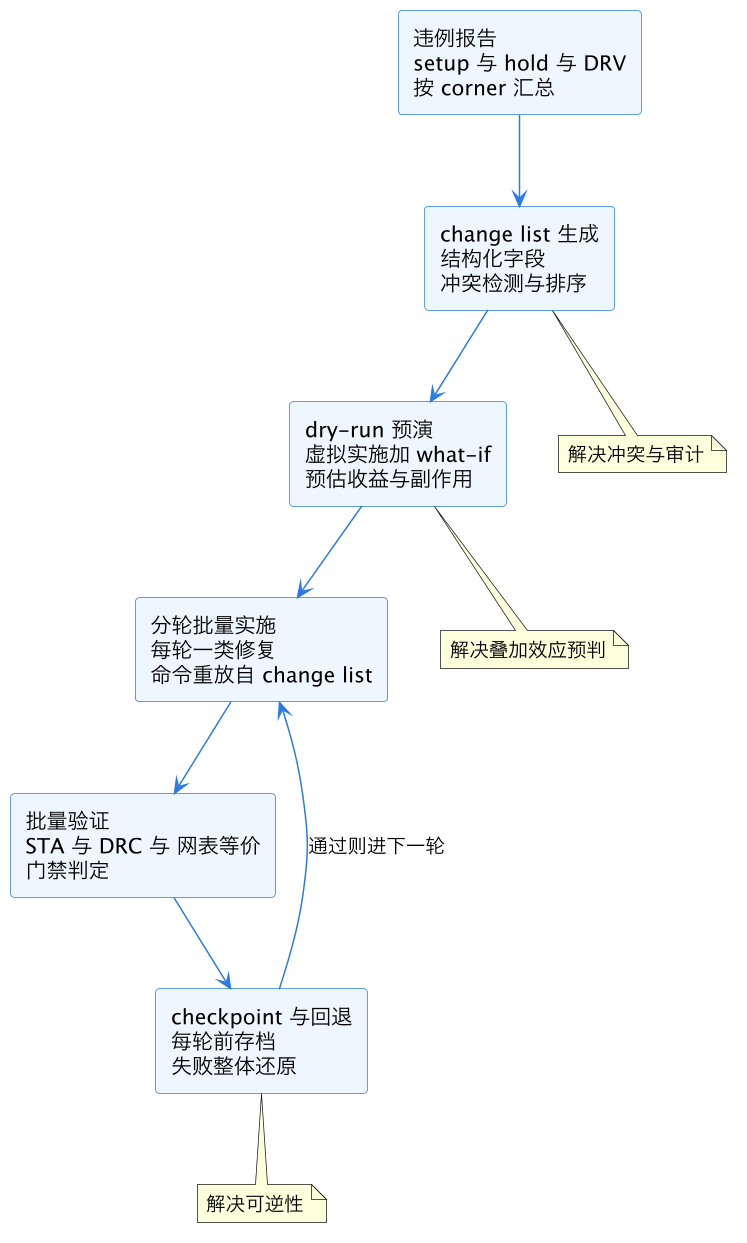
这张图是整条产线的骨架。注意它和「脚本一把梭」的区别:change list 是产线里唯一的事实来源——dry-run 从它读,实施从它重放,验证报告引用它的条目编号,回退之后下一轮从它的剩余子集继续。所有环节围绕一份结构化数据转,而不是围绕一堆一次性命令转,这是工程化和手工作坊的分水岭。
二、change list:产线的事实来源
change list 是从违例报告到实施命令之间的中间表示,常见载体是 CSV、JSON 或工具原生的 ECO 指令文件。一条典型的 change list 条目至少包含这些字段:
| 字段 | 例子 | 作用 |
|---|---|---|
| eco_id | ECO-H-01423 | 全局唯一编号,验证报告与回退都引用它 |
| fix_type | insert_buffer / vt_swap / upsize / insert_delay_cell | 修复类型,决定实施命令模板 |
| target | net n_88412 / inst u_reg_991/Q | 作用对象,用数据库可解析的句柄 |
| params | cell=BUFX4, vt=LVT, size=2X | 修复参数,来自决策规则 |
| violation_ref | hold, corner=SS_0p99_125, slack=-0.042ns | 来源违例,便于回查 |
| priority | P1 | 排序与分轮依据 |
| status | pending / applied / verified / reverted | 生命周期状态机 |
生成逻辑分三步。第一步解析违例报告:按 corner 和违例类型聚合,同一路径在多个 corner 违例时合并成一条(以最差 slack 的 corner 为决策依据,否则会在不同 corner 下互相打架)。第二步决策映射:把违例属性翻译成修复动作——setup 违例且路径单元是 HVT 就换 SVT/LVT(规则见 multi-VT 泄漏功耗回收 的 VT 分级),驱动不足就 upsize,hold 违例在数据路径短点插延迟 buffer(选型参考 hold 修复之 buffer 插入)。第三步冲突检测:扫全表找出作用在同一 net、同一 instance 或物理上互相挤占位置的条目,按优先级裁决——通常 hold 修复优先于 setup 优化(hold 错了芯片直接死,setup 错了还能降频),同优先级按 slack 余量小的优先。
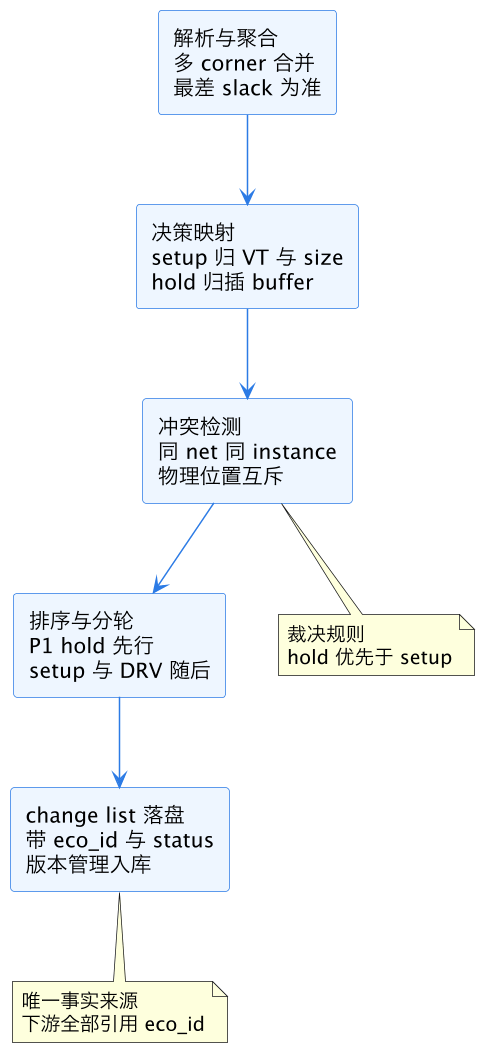
这张图把生成流水线的五步摊开。工程上最值得投入的是冲突检测这一步:漏检一个冲突的代价是两轮返工,而检测只是几张哈希表的 join。change list 落盘后必须进版本管理——它是审计凭证,三个月后有人问「这个 buffer 哪来的」,答案就是 git log 加 eco_id。
还有一个现实问题:change list 的决策规则不可能一开始就完美,所以它本身也要版本化、可灰度。比较稳妥的做法是把决策映射表(什么违例画像映射到什么 fix_type 与 params)从脚本里抽出来单独存成配置文件,每轮实施后拿验证结果反向校准——比如发现某类负载区间下 upsize 的命中率明显偏低,就调那一行的映射规则,而不是改代码。这样产线跑过的每一轮都在为下一轮积累数据,两周冲刺期结束时,这套规则表就是这个项目最值钱的工程资产之一。
三、dry-run:在真改之前先预演
dry-run 的核心思想是「改一份影子副本,用 what-if 引擎预估,不碰真数据库」。具体做法是:把 change list 翻译成的命令在一份内存中的设计副本(或工具的 what-if 会话)里虚拟实施,然后只重算受影响的时序图局部,预估每条修复后的 slack 变化和副作用——新插 buffer 本身引入的延迟、upsize 带来的输入电容增大对前级的影响、VT swap 对泄漏功耗的增量。dry-run 报告回答三个问题:预计修掉多少条违例(命中率)、预计新增多少条违例(副作用)、功耗与面积的代价是多少。
命中率低(比如预估只有 60% 的修复生效)说明决策规则太粗,回去调映射表;副作用大(修 100 条新增 30 条)说明修复密度太高或选型过激,应该降批量、换温和方案。dry-run 的精度永远不如真实施后全量 STA——它用的是局部重算和估计的寄生参数——所以它的定位是「挡掉明显错误的方案」,不是「给出最终承诺」。这个预估与实测的差距本身就是重要数据:连续几轮的差距稳定在 ±10% 以内,说明 dry-run 环境校准良好;突然漂移,多半是寄生估计模式或 corner 配置被人改了。
| dry-run 指标 | 健康区间 | 超区间的动作 |
|---|---|---|
| 预计命中率 | 大于 85% | 回炉决策映射规则 |
| 预计新增违例 | 小于修复数的 10% | 降批量或换温和选型 |
| 功耗增量 | 在功耗预算裕量内 | LVT swap 比例设上限 |
| 预估与实测偏差 | 连续轮次稳定在 ±10% | 检查寄生估计与 corner 配置 |
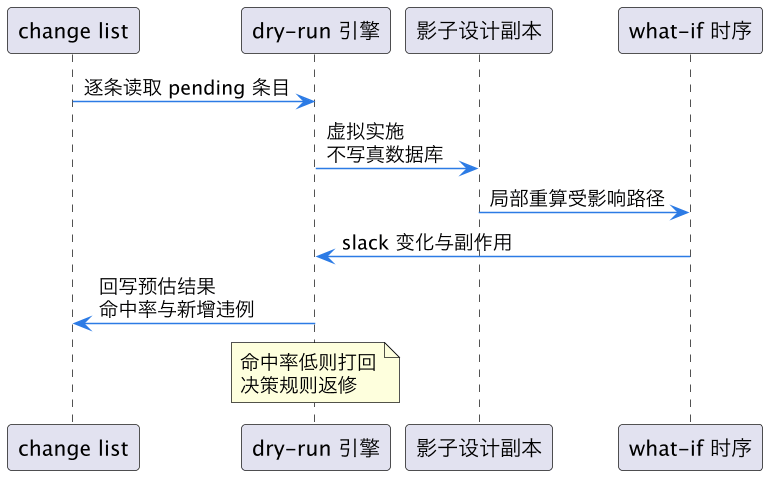
这张时序图强调一个纪律:dry-run 只读 change list、只改影子副本,预估结果回写到 change list 的条目中而不是另起一份报告——这样实施阶段可以直接按「预估值达标」过滤条目,审计链也不断。它和 时序 ECO what-if 分析 的关系是:what-if 是单点工具,dry-run 是把 what-if 批量编排起来再加判定门禁。
四、分轮实施与批量验证
通过 dry-run 的 change list 进入实施。为什么不一把全改?因为修复之间会互相改变环境,一次改 2000 处等于把 dry-run 的预估前提全部推翻。工程惯例是分轮:每轮只改一类、只改一个量级(比如第一轮 P1 hold 修复 300 条),改完立刻做批量验证,绿灯再进下一轮。典型的轮次顺序:先 DRV(不修的话 STA 数字本身不可信),再 hold(功能正确性),再 setup(性能优化),最后泄漏回收(纯收益操作,见 multi-VT 泄漏功耗回收)。
每轮的批量验证是三件套:第一,增量或全量 STA,统计本轮修复命中率(实际修掉多少)和净改善(修掉数减去新增数),命中率显著低于 dry-run 预估就停轮排查;第二,物理检查——插了 buffer 的地方有没有叠线、短路、间距违例,自动布局布线修复后跑增量 DRC(这是和 ECO 金属层修改与 spare 流程 衔接的点:metal-only 阶段插 buffer 必须用 spare cell,change list 的 fix_type 就要带 spare 标记);第三,网表等价性,本轮改动后的网表对上一版做 LEC(逻辑等价检查),确认只有预期的缓冲器插入和单元替换,没有意外的逻辑改动。
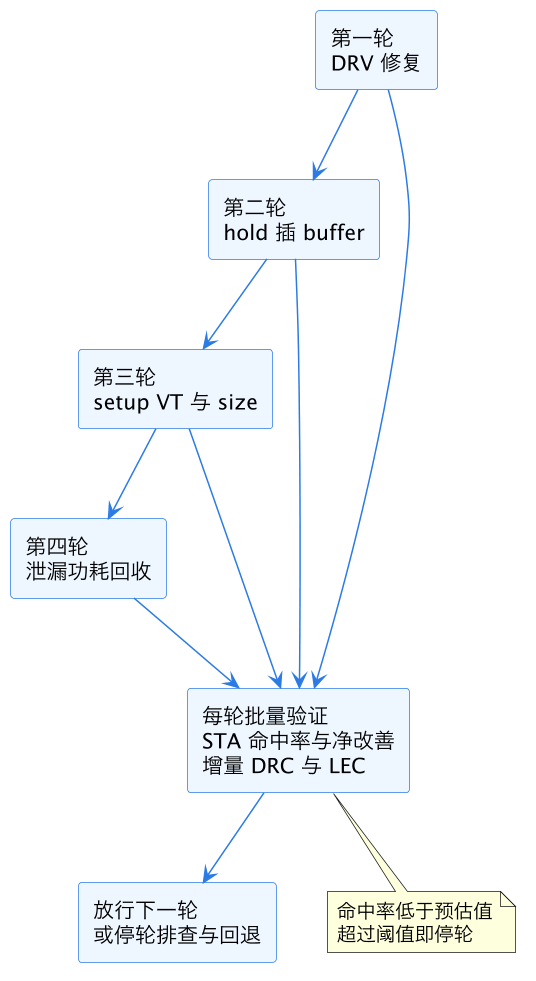
这张图的关键不是顺序本身,而是「每轮都过同一个验证门禁」。顺序的理由值得记一下:DRV 在前是因为转换时间超限会让后续所有 delay 计算失真;hold 在 setup 前是因为 hold 修复(插延迟)会恶化 setup,反过来 setup 修复(换 LVT 换大尺寸)通常不恶化 hold;泄漏放最后是因为它是纯收益项,前面的修复改变了时序裕量后,可回收的单元集合也变了。
五、回退:可逆性设计
回退不是「出问题再说」,而是实施前就设计好的机制。最朴素的做法是每轮实施前对设计数据库打一个 checkpoint(Innovus/ICC2 都有 save 命令,文件级做法是整目录快照),失败后 restore 回到轮首。但整库快照在大型设计上动辄几十 GB、恢复要几十分钟,更经济的做法是以 change list 为轴做逆向回退:因为每条改动都有 eco_id、fix_type 和实施前的原属性快照(换 VT 前的原 cell type、upsize 前的原尺寸、插 buffer 前的原网表拓扑),回退脚本按逆序回放这些条目的逆操作即可——把 LVT 换回 HVT、把 2X 换回 1X、把插入的 buffer 删掉并重接断开的 net。逆向回退只恢复本轮涉及的条目,速度快几个量级,而且可以和 status 字段联动:verified 的条目不回,applied 未验证的回。
实务上两种机制并用:轮内失败用逆向回退(秒级到分钟级),跨轮发现累积性恶化用 checkpoint 整库还原(回到上一个已知好的轮末)。还有一个容易被忽略的配套:物理层改动(新插 buffer 的摆放、连线)的回退依赖实现工具的 eco route 状态,逆向删 cell 后要触发一次增量布线清理,不然会留下悬空的 via 和断线——这也是回退脚本必须和布线工具命令成对设计的原因。整链的可追溯性最终汇入 signoff 收敛 ECO 与 ECO 变更传播数据流:change list 的状态机(pending 到 verified 到 reverted)就是整条 ECO 数据流的审计主线。
| 回退机制 | 适用场景 | 代价 | 前置条件 |
|---|---|---|---|
| 逆向回放条目 | 本轮验证失败 | 分钟级 | 每步实施前存原属性快照 |
| checkpoint 整库还原 | 跨轮累积恶化 | 几十分钟加大存储 | 每轮轮首定时快照 |
| 部分选择性回退 | 个别条目副作用大 | 按条目计 | status 字段精确到条 |
这一篇在知识体系里的位置
本篇是 eda/ 目录 ECO 方法学谱系里的「工程化落地」专文:单点修复技术上游接 setup 修复之 VT swap 与 sizing、hold 修复之 buffer 插入 与 multi-VT 泄漏功耗回收,预演环节复用 时序 ECO what-if 分析 的引擎,物理约束侧对齐 ECO 金属层修改与 spare 流程 和 spare cell 摆放策略,落地汇入 PR 时序收敛 ECO、signoff 收敛 ECO 与 ECO 变更传播数据流。功能类补丁不在本篇范围,那部分见 功能性 ECO 网表补丁。读完本篇,面对几千条违例你应该能搭出一条「生成到预演到分轮实施到验证到回退」的完整产线,而不是抱着路径报告一条条熬夜。
总结
ECO 脚本化是把批量时序修复工程化的一条产线:违例报告经聚合、决策映射、冲突检测生成带唯一 eco_id 与状态机的 change list 作为唯一事实来源;实施前用影子副本加 what-if 做 dry-run,以命中率大于 85%、新增违例小于 10% 为门禁;实施按 DRV、hold、setup、泄漏回收分轮推进,每轮过 STA 命中率、增量 DRC、LEC 三件套的批量验证;可逆性靠每步原属性快照支撑的逆向回退加每轮 checkpoint 双机制保障——让几千处修复可审计、可重放、可回退,把 ECO 从手艺活变成流水线。