线负载模型:逻辑综合统计延时的来源、WLM 表结构与物理综合的差距
更新时间:2026-10-02。逻辑综合是把 RTL 翻译成门级网表的一步,本站 逻辑综合 Design Compiler 讲过整体流程,综合约束 SDC 讲过约束怎么喂进去。这一篇挑流程里一个容易被默认选项糊弄过去的细节:综合器在做时序驱动优化时,根本不知道任何一根线的真实长度——它用的是线负载模型(WLM,Wireload Model),一张按扇出查表的统计替身。看懂线负载模型从哪来、准到什么程度,你才能解释「综合时序过了、布局布线后差了 200ps」这个几乎每个项目都会撞上的现象。
本文要回答的问题
- 为什么逻辑综合阶段需要线负载模型,没有版图的情况下互连延时还能怎么估?
- 线负载模型的表结构长什么样,扇出、模块面积、层次边界各起什么作用?
- 线负载模型的延时和布局布线后真实提取的延时差多少,差距来自哪几个方向?
- 物理综合(physical synthesis)用什么手段替代或收紧 WLM,带来了多少收敛收益?
- 工程上怎么设置线负载模型相关的约束裕量,避免综合结果虚乐观?
一、为什么综合器需要一根「假想的线」
时序优化的前提是会算延时。门级路径的总延时 = 单元延时 + 互连延时,而单元延时本身又依赖输入 transition 和输出负载(见 Liberty NLDM 与 CCS 时序模型),输出负载里就包含互连线的等效电容。换句话说,不算线,连单元延时都查不了表。
问题在于,逻辑综合发生在布局布线之前:综合器不知道这个与非门最终会摆在芯片的哪个角落,更不知道它的输出线要爬多远。精确的 RC 要等 SPEF 寄生参数提取 那一步才有。于是工业界的折中是:给综合器一张统计表,按「这根网线带了几个负载」查出一个平均的电容、电阻、面积,再按估算的线长乘上单位 RC 得到一个近似的互连延时。这张表就是线负载模型。
WLM 回答的是一个概率问题:「在这个工艺下、这么大的模块里,一根扇出为 5 的网线,平均有多长、多重」。它不回答这根具体的线实际多长——那是物理信息,综合阶段不存在。
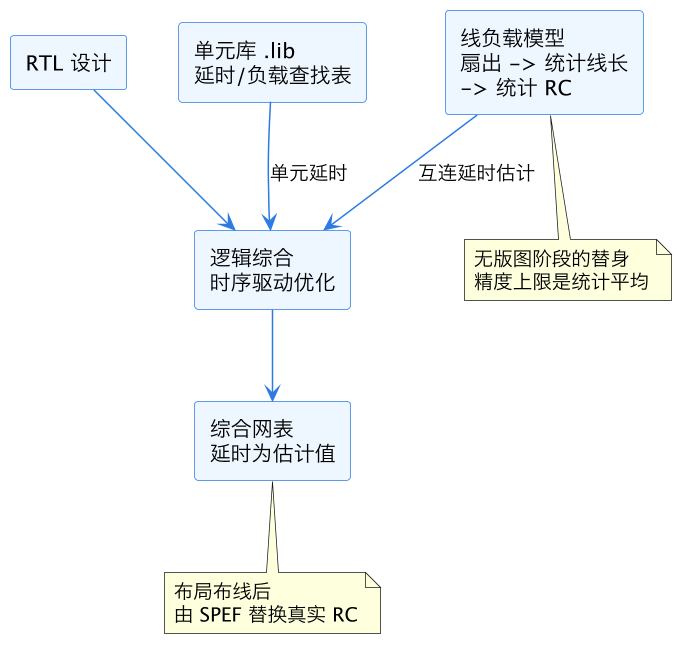
上图里盯住一个事实:线负载模型和单元库是综合器的两个并列输入,单元库管「门」,WLM 管「门之间的线」。综合结束后,WLM 估计的线延时会一直被 SPEF 真实提取替换——这个替换点就是「综合时序」和「物理时序」差值的发源地。
二、线负载模型的表结构与来源
一个典型的线负载模型长这样:库里按扇出列若干行,每行给 slope(斜率)、intercept(截距)或直接给查表点,综合器把扇出映射成一个等效线长,再乘上 resistance / capacitance 单位系数得到 R 和 C,还有一个 area 系数算走线占用的布线资源。模型还区分适用范围:模块级(block-level)的表按模块面积分档——面积越大,同样扇出的线平均越长;顶层(top-level)和穿越层次边界的网线另有模型(enclosed / segmented 模式处理跨层级线长归属)。
这些数据哪来的?答案是 foundry 或库厂商用大量已完成布局布线的参考设计统计出来的:拿一批真实芯片,把每根网线的扇出和提取后的实际线长回归成表。所以线负载模型本质上是「别人家芯片的平均经验」,它的隐含假设是你的设计和参考设计长得差不多——密度、层次规模、布线资源占用都在常规区间。
| 维度 | WLM 的处理 | 物理现实 | 偏差方向 |
|---|---|---|---|
| 扇出到线长 | 统计均值查表 | 具体走线长短不一 | 双向,长尾难估 |
| 模块面积 | 按面积分档 | 同面积内布局差异巨大 | 高密度区偏乐观 |
| 拥塞 | 不建模 | 拥塞处绕线变长 | 系统性偏乐观 |
| 层归属 | 等效单层系数 | 高层金属 RC 低、低层高 | 视走线层分布 |
上表是把差距拆开的四个方向。最值得记住的是后两行:拥塞和绕线是 WLM 完全看不见的世界,而它们恰恰是先进工艺下互连延时超预估的主因。这也是为什么 RC corner 的选择 里要给互连留足够的悲观度档位。
三、WLM 与物理综合的差距:从统计平均到真实提取
把同一根网线在三个阶段各算一次延时,数字大致是这样的走势:综合阶段 WLM 给一个统计值;布局之后(route 之前)用全局布线的虚提取(virtual route / trial route)修正一次;详细布线后用 StarRC 等引擎提取 SPEF 得到最终值。WLM 到 SPEF 的误差,成熟设计里常见在 20% 到 50% 的量级,个别长网线或拥塞区可以翻倍;而且这个误差不是对称噪声——时序关键路径上的网线往往是长距离、跨模块的,恰好落在统计分布的长尾上,WLM 对关键路径的低估倾向比平均值更糟。
物理综合(physical synthesis,如 DC Topographical、Genus Physical 模式)的应对是把「完全无物理信息」升级成「有粗略物理信息」:读入 floorplan,对模块内网线在布图范围内做虚拟布放和虚拟布线,用预估的走线层和曼哈顿长度替代纯统计表。效果上,互连延时估计误差从 WLM 的量级收窄到个位数百分比,综合网表的 QoR(质量结果)和布局布线后的一致性大幅改善,「综合过了、PR 炸了」的返工循环明显变少。代价是需要 floorplan 数据先行,流程上把综合和布图规划的交接(见 数据流之综合交接)绑得更紧。
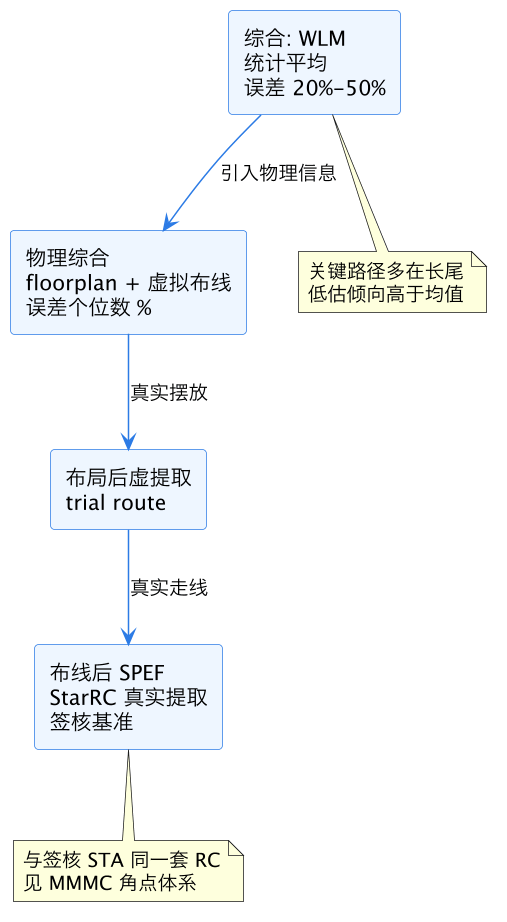
这张图是同一根网线延时估计精度的四段爬升。注意它不是线性的:从 WLM 到物理综合是质变(有没有 floorplan 的区别),后面两步只是精度收敛。工程含义是——如果团队只能做一项改进,把综合切到 topographical 模式的收益远大于调 WLM 表本身。
四、工程实战:怎么和线负载模型和平共处
落到日常流程,四条纪律。其一,别手动编 WLM 表,用库自带的;自建表只在全定制或特殊结构(比如特别扁长的模块)里有意义,而且要拿已完成的同型设计回标定。其二,约束里给互连不确定性留位置:set_clock_uncertainty 和时序裕量(timing margin)里隐含吸收了一部分 WLM 误差,激进削减 uncertainty 来冲频率时,要知道自己在花哪笔存款,约束背景见 综合约束 SDC 与 MMMC 与 OCV 寄生参数。其三,看综合报告时盯住线延时占比:一条路径互连延时占比超过 30% 就要警惕,这种路径对 WLM 误差最敏感,PR 后最容易变脸,值得在综合阶段就插缓冲或调整结构。其四,签收标准对齐到物理模式:新项目评估综合 QoR 时,以 topographical 综合加虚拟布线的报告为基线,纯 WLM 模式的 setup 裕量至少要再打个八折看待。
这一篇在知识体系里的位置
本篇属 eda/ 目录综合线的基础概念文:上承 逻辑综合 Design Compiler 的流程全景与 Liberty NLDM 与 CCS 时序模型 的延时查表机制,横向连接约束侧 综合约束 SDC 与 MMMC 与 OCV 寄生参数,向下接物理实现侧的真实提取——SPEF 寄生参数提取、StarRC techfile 与 TLU+ 与 RC corner 的选择,综合到 PR 的数据交接见 数据流之综合交接。
总结
线负载模型是逻辑综合阶段给互连延时找的统计替身:无版图时按扇出查表拿平均 RC,让时序驱动优化得以运行;它的误差在 20%-50% 量级且对关键路径系统性偏乐观,物理综合用 floorplan 加虚拟布线把误差压到个位数百分比,最终由 SPEF 真实提取接管;工程纪律是用库自带模型、在 uncertainty 里留互连裕量、警惕线延时占比高的路径、以 topographical 模式为 QoR 基线。