FPGA 进阶 23:Zynq 数据交互——HP 口、AXI DMA/VDMA 与数据通路
本文是
fpga/进阶层第 27 篇。Zynq 入门搭起了 PS+PL,但数据密集应用(AD 采集、图像帧、信号处理)要在 DDR 和 PL 数据流之间高速搬大块数据。用 CPU 经 GP 口逐字 MMIO 搬运会占满 ARM 且带宽极低——必须靠 AXI DMA/VDMA 经 HP 口直接搬,CPU 只启动和等中断。这篇讲数据通路方向、软件流程(含 cache 一致性这个大坑)和带宽匹配。
本文要回答的问题
- 为什么寄存器搬运不行,DMA 解决了什么?
- MM2S / S2MM 方向怎么分?采集/发送各用哪个?
- DMA 怎么连(HP 主口到 DDR、GP 配置、Stream 到 PL)?
- 裸机/Linux 怎么做 cache 同步?漏了会怎样?
- VDMA 处理视频帧比普通 DMA 多了什么?
- 带宽怎么估算和匹配?
一、数据面:DMA 直连 DDR,不经过 CPU
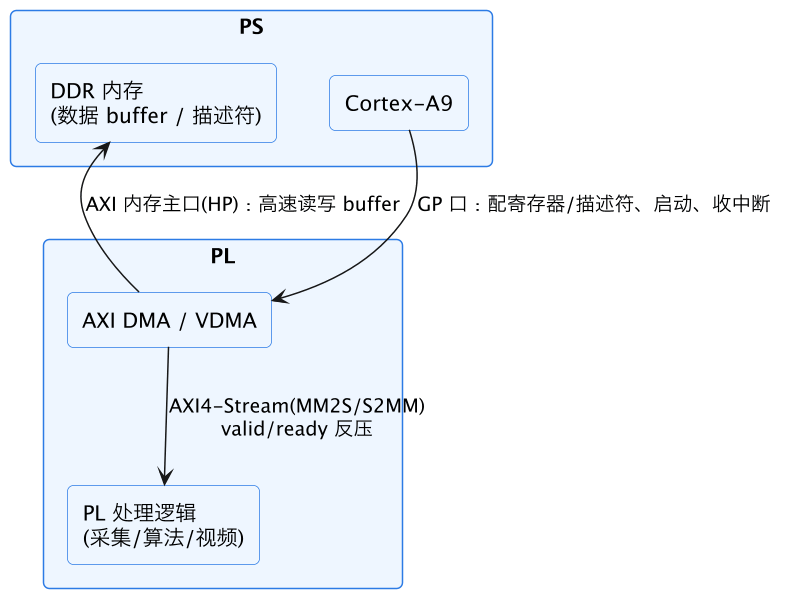
- 控制面:CPU 经 GP 口配置 DMA(源/目的地址、长度、描述符)、启动、等完成中断;
- 数据面:DMA 经 AXI-HP 主口直接读写 DDR,数据以 AXI4-Stream(valid/ready 反压)在 PL 流动,全程不过 CPU。
二、MM2S / S2MM:两个方向
| 通道 | 方向 | 用途 |
|---|---|---|
| MM2S(Memory-Mapped → Stream) | DDR → PL | 下发/发送:把 DDR 数据成流送给 PL 算法、DA 波形输出 |
| S2MM(Stream → Memory-Mapped) | PL → DDR | 采集/上传:AD 采样、PL 结果写回内存供软件读 |
两者独立、可同时用,组成 DDR→PL 处理→DDR 环路。tlast 标记一包/一帧结束;长度不对或缺 tlast 会让 S2MM 等待超时。
Simple vs Scatter-Gather(SG):Simple 模式一次描述一段连续 buffer(给地址+长度);SG 模式用描述符链表一次描述多块(可非连续)buffer,DMA 自动沿链表搬,适合帧队列/零拷贝,描述符本身也放在 DDR。
三、软件流程与 cache 一致性(头号大坑)
DMA 直接访问 DDR、不经过 CPU cache,必须手动同步,否则数据陈旧/损坏:
// 裸机 S2MM(采集 PL 流 → DDR)简化流程
Xil_DCacheInvalidateRange(rx_buf, len);   // 采之前:丢弃 cache 旧行
XAxiDma_SimpleTransfer(&dma, rx_buf, len, XAXIDMA_DEVICE_TO_DMA); // S2MM
// ... 启动 PL 发送流,DMA 经 HP 写 DDR ...
while (XAxiDma_Busy(&dma, XAXIDMA_DEVICE_TO_DMA)) ;  // 等完成(或用中断)
Xil_DCacheInvalidateRange(rx_buf, len);   // 采之后:再 invalidate,CPU 才读到新数据
process(rx_buf);

// MM2S(DDR → PL)前要 Flush,把 CPU 写的 cache 数据刷回 DDR:
Xil_DCacheFlushRange(tx_buf, len);
XAxiDma_SimpleTransfer(&dma, tx_buf, len, XAXIDMA_DMA_TO_DEVICE);| 方向 | 前/后 | cache 操作(裸机) | 原因 |
|---|---|---|---|
| MM2S(内存→设备) | 启动前 | Flush(clean,写回 DDR) | 保证 DDR 里是 CPU 最新写的数据 |
| S2MM(设备→内存) | 启动前+完成后 | Invalidate(丢弃 cache 行) | 强制 CPU 从 DDR 读 DMA 写入的新数据 |
- Linux:用
dma_alloc_coherent()分配一致性内存(框架保证同步),或流式映射dma_map_single()+ 按方向dma_sync_single_for_cpu/device(); - buffer 必须分配在 DMA 可访问的物理内存(且地址宽度够,Zynq-7000 是 32 位),别让编译器把 buffer 优化掉/放到不可缓存区外。
四、VDMA:二维视频帧
普通 AXI DMA 搬一维字节流(给长度连续搬、tlast 定界);VDMA 为视频帧设计:
- 按 hsize(行宽)/vsize(行数)/stride(行步长) 组织内存帧缓冲,自动在帧缓冲与 AXI-Stream 视频流间按行/帧同步;
- 多缓冲(ping-pong/双缓冲、三缓冲):软件处理一帧时硬件采/显另一帧,避免撕裂/丢帧;
- 带帧同步/genlock,直接对接 视频图像流水线(HDMI 收发、图像处理)。
记忆:一维采样/通用流用 AXI DMA,二维视频帧用 VDMA。
五、带宽估算与匹配
链路带宽由最窄环节决定,三个口都要算:
- AXI-Stream 侧:
带宽 = 位宽 × 时钟频率,如 64bit × 150MHz = 1200 MB/s(有效数据); - HP 口/DDR 侧:HP 口理论峰值数百~数千 MB/s,实际受 DDR 带宽和突发效率影响;
- 让 Stream 位宽×时钟 ≥ 需求带宽,DMA burst 长度合理(别太短导致突发效率低),buffer 连续、地址对齐;
- 若 PL 处理速率 < DMA 供给,反压(ready)会让 DMA 等待,属正常;但 S2MM 长时间反压/无时钟可能触发 DMA timeout,要保证下游及时收数。
常见坑对照
| 坑 | 后果 | 正确做法 |
|---|---|---|
| 漏 cache 同步(裸机) | 数据陈旧/偶发错 | MM2S 前 Flush、S2MM 前后 Invalidate |
| Linux 用普通 malloc 做 DMA buffer | cache 不一致/地址不可达 | dma_alloc_coherent / dma_map_single |
| CPU 经 GP 口搬大数据 | 占满 CPU、带宽低 | HP 口 + DMA 搬数据 |
| buffer 非连续/不对齐/不可 DMA 访问 | DMA 报错或效率低 | 连续、对齐、物理可寻址内存 |
| tlast 缺失或长度不对 | S2MM 等不到结束、超时 | 正确给 tlast 和传输长度 |
| Stream 位宽×时钟算小了 | 带宽打不满、反压 | 位宽/时钟匹配需求带宽 |
| 单缓冲做视频 | 撕裂/丢帧 | VDMA 多缓冲 ping-pong |
| DMA 完成与数据处理不同步 | 读到半帧 | 等完成中断/状态再处理,双缓冲交替 |
相关与延伸
前置/配套:Zynq 入门(GP/HP/ACP、块设计、地址)、AXI4 完整与互联(DMA 的 AXI 内存口、burst/outstanding)、AXI4-Stream 握手、异步 FIFO(跨时钟/反压缓冲)。 通用数据搬运架构(DataMover/散聚、带宽匹配)见 #43;视频流水线见 #32;Zynq PS/PL 深水区见专家层。
一句话总结
Zynq 数据密集搬运必须让 DMA 经 HP 口直接在 DDR 和 PL 之间搬、不要用 CPU 经 GP 口逐字拷贝(后者占满 ARM、带宽低一个数量级)。AXI DMA 两通道:MM2S(DDR→流,下发/发送)、S2MM(流→DDR,采集/上传),数据面走 HP 主口、控制面 CPU 经 GP 配寄存器/描述符、等中断,流侧用 AXI4-Stream valid/ready 反压;多块 buffer 用 scatter-gather 描述符链表,视频二维帧用 VDMA(hsize/vsize/stride + 多缓冲防撕裂)。软件最大的坑是 cache 一致性:DMA 不过 CPU cache,裸机 MM2S 前 Flush、S2MM 前后 Invalidate,Linux 用 dma_alloc_coherent/dma_map_single;buffer 要连续、对齐、物理可寻址,tlast 和长度要正确。带宽按「Stream 位宽×时钟」和 HP/DDR 两侧估算、取最窄环节,保证下游及时收数避免反压超时。