Prompt 压缩:LLMLingua 类软压缩与 KV 驱逐的 prefill 降本账
更新时间:2026-10-03。前面 KV cache 推理显存 讲过:长上下文请求的成本有两笔——prefill 阶段对整个 prompt 做一遍 O(N²) 注意力的算力账,和 decode 阶段反复读 KV cache 的带宽账。当 prompt 长到 32K、128K 这一档,prefill 的算力账会盖过一切,一次请求的首 token 延迟(TTFT)直接拖到秒级甚至十秒级。Prompt 压缩的思路很直接:既然大模型的注意力本来就高度稀疏、prompt 里大半 token 是冗余的,那就别全喂进去——要么在进模型前把 prompt 剪短(软压缩),要么在 prefill 过程中把算完也不重要的 KV 提前驱逐(硬驱逐)。两条路线分别对应 LLMLingua 一族和 H2O/SnapKV 一族,与 GQA/MQA 的 KV 节省 改模型结构不同,它们都是不改权重的「外挂」优化。
本文要回答的问题
- prefill 成本到底随 prompt 长度怎么涨,压缩能省的是哪一笔钱?
- LLMLingua / LLMLingua-2 的软压缩怎么给 token 打分、怎么剪,信息损失发生在哪?
- H2O、SnapKV 这类 KV 驱逐和软压缩的区别是什么,为什么它们也叫 prompt 压缩?
- 压缩比开多大精度开始崩?「大海捞针」类任务和摘要类任务的边界一样吗?
- 线上选型:软压缩、KV 驱逐、KV 量化、prefix cache 怎么组合?
一、prefill 的账单:为什么长 prompt 值得被压缩
先把账摆清楚。prefill 阶段对长度为 N 的 prompt 做自注意力,QK^T 这一步的计算量是 O(N²·d)(d 是 head dim),FLOPs 随 N 平方增长;同时每层都要为这 N 个 token 各写一份 K、V 进 cache,显存写入量是 O(N·层数·d)。到了 decode 阶段,每生成一个 token 要把全部 N 个 token 的 KV 从 HBM 读一遍——KV cache 越大,单 token 的解码延迟越高,这就是 PagedAttention 分页 KV 解决碎片、但解决不了总量的问题。
一个直观的数量级:7B 模型(32 层、GQA 8 组 KV head、head dim 128)处理 32K token 的 prompt,KV cache 约 8 GB(FP16);prefill 在 A100 上大约要 4~6 秒。如果业务里这 32K 里有 70% 是检索回来的冗余段落、few-shot 示例和系统模板,那这 6 秒里有一大半是在为废话付算力。压缩的收益公式因此很简单:压缩比 r(保留 token 比例)下,prefill 算力近似按 r² 降,KV 显存与 decode 读带宽按 r 降——0.3 的保留率意味着 prefill 算力降到约 9%,这是任何 kernel 级优化都给不了的杠杆。

上图先把两条路线的分工画清:软压缩发生在模型之外,改的是「喂进去什么」;KV 驱逐发生在 prefill 之中或之后,改的是「算完留什么」。软压缩省的是 prefill 的 FLOPs 和 TTFT,KV 驱逐省的是 decode 阶段的读带宽和显存容量——这也是后面选型表的核心依据。
二、软压缩:LLMLingua 怎么给 token 打分
LLMLingua(微软 2023 年提出)的核心观察是:自回归语言模型本身的困惑度(perplexity)就是一个现成的「信息密度计」。一个 token 如果在给定上文时困惑度低(模型本来就猜得到它),说明它是冗余的——删掉它,模型大概率能自己补回来;困惑度高的 token 才是「不可预测的新信息」,必须留。
但直接用目标大模型(比如 70B)去打分,等于把 prefill 先跑了一遍,省的钱又花出去了。所以 LLMLingua 用一个小模型(GPT-2 small、LLaMA-7B 级别)当「打分器」,整条流水线是:
- 分段预算:把 prompt 按 instruction、demonstrations、question 等段落切开,不同段落给不同的保留预算——instruction 通常近乎全留,demonstrations 使劲剪。
- 小模型打困惑度:用小模型对每个 token 算条件困惑度。
- 迭代式筛选:不是一次性全局打分,而是分若干轮,每轮在上轮保留结果的基础上重算困惑度再剪——因为删掉中间内容后,后文 token 的条件分布会变,一次性打分会把「前文依赖项」误删。
- 对齐到原 prompt:把保留下来的 token 原样拼接(不重写、不生成),交给目标大模型。
第三代 LLMLingua-2 把「打分」从 perplexity 换成了专门训练的 token 分类器(拿 GPT-4 构造「哪些词可以删」的标注数据,微调一个 BERT 级模型做二分类),好处是打分只需一次前向、对领域漂移更稳,压缩速度比 LLMLingua 快 3~6 倍。
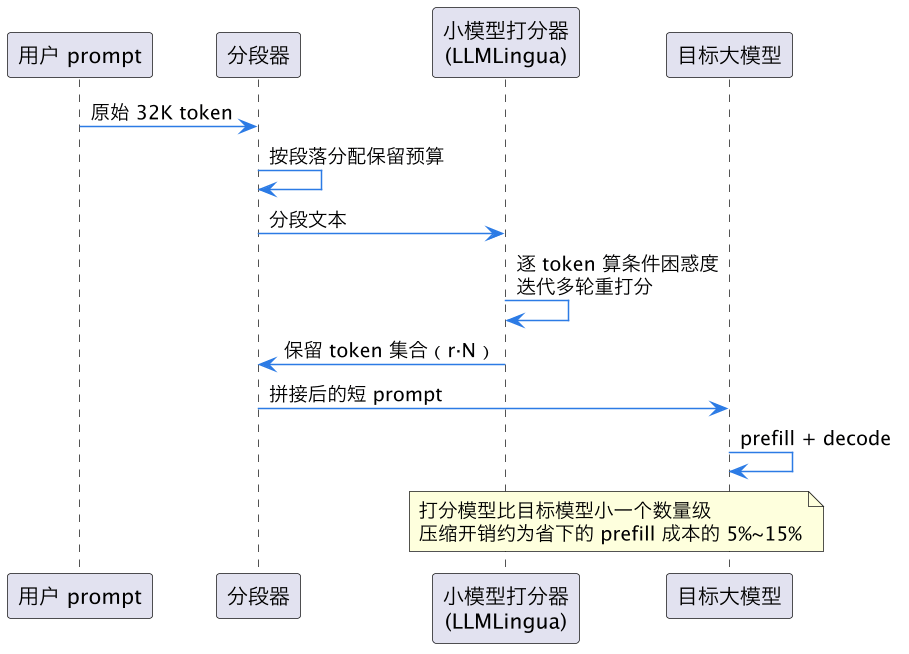
上图里最容易被低估的是「迭代多轮重打分」这一步。假设 prompt 是「北京是中国的首都,中国的人口约 14 亿」,一次性打分可能觉得「中国」第二次出现时困惑度低、可删——但那是在「北京是中国的首都」还在场的前提下。删掉前句后,后句的「中国」反而成了关键信息。迭代式压缩每删一轮重新估计,就是在修这种条件依赖的错位。LongLLMLingua 进一步针对长文档场景加了「问题感知」:用 question 和上下文的互信息重排段落顺序(把最相关的段落放到 prompt 首尾,利用模型对首尾位置更敏感的特性),同样的保留率下精度能再拉几个点。
| 方法 | 打分器 | 压缩粒度 | 典型速度开销 | 代表场景 |
|---|---|---|---|---|
| LLMLingua | 小 LM 困惑度,迭代多轮 | token 级 + 段落预算 | 中(多轮前向) | 通用、demonstrations 多的 prompt |
| LLMLingua-2 | BERT 级分类器(蒸馏自 GPT-4) | token 级 | 低(单次前向) | 线上高 QPS、领域固定 |
| LongLLMLingua | 困惑度 + 问题感知重排 | 段落级重排 + token 级 | 中高 | 长文档 QA、RAG |
三、KV 驱逐:不改 prompt,改「留下哪些 KV」
第二条路线不动输入文本,而是在注意力内部做文章。动机来自一个被反复验证的观察:注意力权重高度集中,少数「重击者」(heavy hitter)token 拿走了绝大部分注意力质量。H2O(Heavy Hitter Oracle)统计每个 token 在 prefill 中被后续 token 关注的累计分数,只把累计分数最高的 r·N 个 token(加上最近的局部窗口)的 KV 留在 cache 里,其余驱逐。这样 prefill 照算(FLOPs 没省),但 cache 从 N 缩到 r·N,decode 每步的读带宽和显存容量都按 r 降。
SnapKV 是 H2O 的改进版,更适合纯 prefill 场景。它不看「被谁关注」,而是看 prompt 末尾的一小段观测窗口(observation window,通常取 prompt 最后 16~64 个 token,也就是问题或指令所在处)对前文各位置的注意力分布,把被窗口「看重」的位置挑出来保留,再用 pooling 把相邻位置合并平滑,防止选中位置过于稀疏破碎。直觉很朴素:用户的问题在末尾,末尾 token 回头看的那些前文位置,就是回答问题真正需要的上下文。
pf: "prefill 全量前向\n算出所有 token 的 KV"
win: "观测窗口:prompt 末尾 16~64 token\n(问题/指令所在处)"
score: 统计窗口对前文各位置的注意力分
top: "pooling 平滑,选出 top r·N 位置"
cache: "KV cache 只保留选中位置\n加最近局部窗口\n注:decode 每步读带宽按 r 降;prefill FLOPs 不变,TTFT 基本不变"
drop: 驱逐位置的 KV 直接丢弃
pf -> win
win -> score
score -> top
top -> cache
top -> drop
cache.style: { fill: "#E9F8F0"; stroke: "#2E9E6B" }
drop.style: { fill: "#FEF3E2"; stroke: "#E08A1E" }
注意上图和第一节图的分工差异:KV 驱逐路线的 prefill 是一分不少地算完的,所以它对 TTFT 几乎没有帮助,省的全在 decode 侧。这也意味着它和软压缩是互补关系而不是替代关系——先软压缩把 prompt 砍到 r1·N 让 prefill 变便宜,再对剩下的内容做 KV 驱逐把 cache 压到 r1·r2·N 让 decode 变便宜,两级杠杆可以叠乘。工程上还要处理一个细节:驱逐后 cache 里的位置不再连续,注意力 kernel 需要支持按索引集合 gather KV,vLLM V1 调度器设计 里讨论的 block 表机制天然能做这件事,这也是这类方法近两年能快速上生产的原因之一。
还有一族更激进的做法值得点名:StreamingLLM(注意力汇聚点 + 滑动窗口)发现注意力分数会异常集中在序列最开头的几个 token(attention sink)上,只保留开头 4 个 token 加最近窗口就能让模型在无限长输入下不崩。它精度损失比 H2O 大,但实现简单到只需改 cache 的写入策略,适合对话流水席这类「只要近处上下文」的场景。
四、精度边界:压缩比开多大会崩
压缩不是免费的,丢的是信息,问题只在「丢多少、什么时候伤任务」。论文和工程实践给出的边界大致是这样:
- 保留率 ≥ 0.5:摘要、续写、开放式问答基本无损,肉眼难分。这类任务本来就不要求逐字利用 prompt,冗余度极高。
- 保留率 0.2~0.5:长文档 QA 开始分化。答案分布在多处、需要跨段推理的任务还能扛;LongLLMLingua 的问题感知重排在这个区间收益最大。
- 保留率 < 0.2:「大海捞针」(needle in a haystack,从长文中精确取回一个特定事实/数字)任务率先崩溃——因为针所在的那几个 token 完全可能被打分器判成冗余。任何要做精确检索引用的场景,压缩比都不该开进这个区间。
- 结构化内容是重灾区:代码、JSON、表格、数学推导的 token 冗余度远低于自然语言,软压缩在代码 prompt 上 0.5 保留率就能明显伤补全质量。KV 驱逐同理:代码里一个远处定义的变量名,注意力打分未必高,但语义上不可或缺。

上图是实践里反复踩出来的三档分区。一个反直觉的点:软压缩和 KV 驱逐的精度曲线形状不同。软压缩的损害在入口处就定了(信息物理消失),但它剪掉的确实是低困惑度冗余,曲线下降平缓;KV 驱逐保留的是「被末尾问题关注的」token,对问答任务曲线更平,但一旦观测窗口选错(比如问题在 prompt 中间、末尾是无关模板),会断崖式失效。线上压测必须用真实流量里的任务分布做分层评估,跑一个平均分是会自欺欺人的。
与 W8A8 SmoothQuant 离群值 处理量化离群通道的思路类似,压缩方法也都在和「分布的长尾」搏斗——量化怕离群激活值,压缩怕离群关键 token,两者都是「大多数好办、长尾要命」。
再补一笔经济账帮助定压缩比。假设业务 prompt 平均 16K token,保留率开到 0.3,软压缩后 prefill 输入约 4.8K:prefill FLOPs 降到原来的 (0.3)²≈9%,即便加上打分小模型 10% 左右的开销,TTFT 仍能从秒级压到亚秒级;KV cache 同步缩到 0.3 倍,单卡并发上限随之上浮约 3 倍。也就是说,压缩比每往下拧一档,两头都在复利式地省——但精度曲线在 0.2 以下非线性恶化,所以工程上常见的做法是把默认保留率定在 0.3~0.4,再对捞针类高敏请求按标签绕行(识别到精确引用、代码补全类意图时跳过压缩),用「默认压缩 + 白名单直通」兜住长尾。
五、线上选型:四条降本路线怎么组合
把 prompt 压缩放回整个长上下文降本工具箱里,选型就清晰了。同场竞技的还有 KV cache 量化 INT4(不删 token,把每个 KV 值压成 4 bit)、prefix cache(相同前缀的 KV 直接复用,系统模板类业务收益巨大)、KV cache offload CPU 混合(把冷 KV 卸到内存)以及 FlashDecoding 的 split-K 切分(不省钱但摊低长 KV 下的 decode 延迟)。
| 路线 | 省 prefill 算力 | 省 decode 带宽/显存 | 改不改权重 | 精度风险 | 适用信号 |
|---|---|---|---|---|---|
| 软压缩(LLMLingua 系) | 是(按 r 平方) | 间接(cache 变小) | 否 | 低保留率下捞针崩 | prompt 冗余高、TTFT 是瓶颈 |
| KV 驱逐(H2O/SnapKV) | 否 | 是(按 r) | 否 | 观测窗口失配 | 显存/吞吐是瓶颈、TTFT 可接受 |
| KV 量化 INT4 | 否 | 是(约 4 倍) | 否 | 极低 | 与驱逐正交,可叠加 |
| prefix cache | 是(命中部分归零) | 否 | 否 | 无 | 系统模板/few-shot 高度重复 |
组合建议按瓶颈对症下药:TTFT 超时先上软压缩和 prefix cache;单卡并发上不去(KV 把显存吃光)上 KV 驱逐加 KV 量化,两者正交可以叠出接近数量级的容量收益;都上了还不够,再考虑 TensorRT-LLM in-flight batching 层面的调度优化,把压缩省下来的单请求成本转化为整卡吞吐。观测侧别忘了把压缩比、保留 token 分布、TTFT 变化接入 LLM 推理可观测性体系,压缩策略的效果是分布级的,不看分位数等于没看。
这一篇在知识体系里的位置
本篇是「LLM 推理降本」线索上长上下文一环:上游基础是 KV cache 推理显存(被压缩的对象本身)和 PagedAttention 分页 KV(cache 的存放机制);同层兄弟技术是 KV cache 量化 INT4(压每个值而非删 token)、KV cache offload CPU 混合(换地方存而非少存)、GQA/MQA 的 KV 节省(从模型结构源头少产生 KV);下游延伸是 vLLM V1 调度器设计 里压缩策略与调度器的协同,以及 RAG 场景下「检索质量与压缩比的联合调优」。
总结
Prompt 压缩利用大模型注意力的天然稀疏性,把长上下文里大半冗余 token 挡在算力账单之外:软压缩路线(LLMLingua 系)用小模型的困惑度或蒸馏分类器给 token 打分、迭代剪枝,让 prefill FLOPs 随保留率平方下降、直击 TTFT;KV 驱逐路线(H2O/SnapKV)保住 prefill 计算但只留「被问题关注的」top token 进 cache,把 decode 带宽和显存按保留率线性压低——两条路线正交可叠加,在 0.3 左右保留率的甜区内对摘要问答近乎无损,但大海捞针、代码与结构化内容会率先崩,选型时必须按任务分布分层压测,并与 KV 量化、prefix cache 组合成完整的降本组合拳。