有用偏差优化:让时钟「不齐」反而更快
CTS 时钟树综合讲过时钟树的第一目标是把所有寄存器的时钟偏差(skew)压到最小;STA 时钟延迟分析讲过 source latency 与 network latency 怎么进 setup/hold 检查。本篇要讲的是一件听起来自相矛盾的事:时钟树压得越平,未必越好——故意让某些寄存器的时钟晚到一点、另一些早到一点,时序反而能收敛。这就是有用偏差优化(useful skew optimization)。它在 CTS 高级主题里常被一句话带过,本篇把它单独讲透:借时的数学原理、CTS 阶段怎么落地、能省多少余量、以及为什么它让 hold 检查和签核角变脆。
本文要回答的问题
- 时钟偏差明明是「敌人」,为什么故意引入偏差反而能优化 setup?借时的边界在哪里?
- useful skew 在物理实现流程的哪个阶段做?CTS 工具用什么手段把目标偏差「种」进时钟树?
- 典型收益有多大?为什么说它本质是「零和博弈」的调度而非凭空造余量?
- 引入非零偏差之后,hold 检查、OCV、多角签核各多出哪些坑?工程上怎么兜底?
一、借时原理:从「同时到达」的执念说起
经典数字时序里,一条寄存器到寄存器路径的 setup 约束是:
T_clk ≥ T_cq + T_logic + T_setup + (launch_latency - capture_latency)注意最后一项:launch 寄存器的时钟延迟减去 capture 寄存器的时钟延迟。传统 CTS 的做法是把这项压到接近零——所有寄存器时钟同时到达,于是周期预算全部留给组合逻辑。这个策略在「各条路径长度差不多」时没问题,但现实设计里路径天然长短不一:有的寄存器对之间只隔两级逻辑,有的隔二十级。压平 skew 等于让最短路径和最长路径用同一份周期预算,长路径缺多少就只能靠插 buffer、换 VT 单元、改逻辑这些有代价的手段去补。
useful skew 的思路反过来:既然 capture 寄存器晚收到时钟,这条路径就多出一段「借来的」时间,那就让长路径的 capture 端时钟晚到、短路径的 capture 端时钟早到,把闲置在短路径上的周期预算挪给长路径。这本质上和流水线里手动调相位是同一思想,只是尺度搬到了时钟树的每条叶子上。
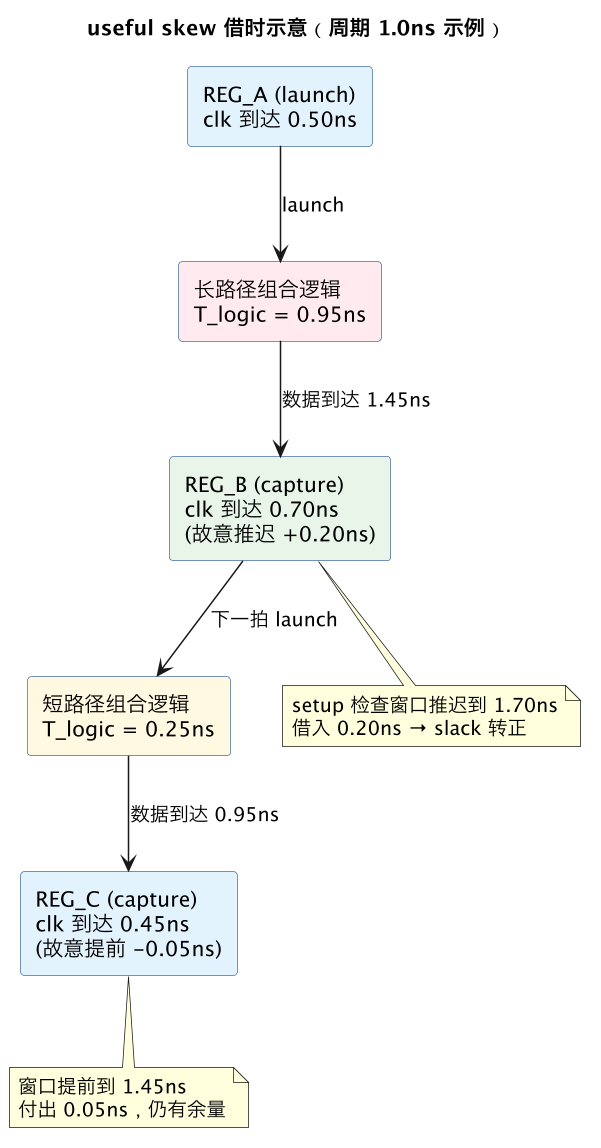
这张图值得逐条看。假设周期 1.0ns、零 setup 时间:压平 skew 时 REG_B 在 1.50ns 采样,数据 1.45ns 到达,slack 只有 0.05ns;把 REG_B 的时钟推迟 0.20ns 后采样窗口挪到 1.70ns,slack 变成 0.25ns。代价是谁付的?看 REG_B 作为 launch 端的下一段路径——它 0.70ns 才发出数据,比原来晚 0.20ns,好在后段逻辑只有 0.25ns,slack 依然为正。所以 useful skew 从来不是「凭空造余量」,而是在一条寄存器链上把余量从富余段搬到紧张段,总预算没变,分布变了。
由此立刻得到借时的两条边界:
- 借入上限:capture 推迟量不能超过下游最短路径的富余 slack,否则按下葫芦浮起瓢,setup 修好、下一段又红了;
- 链条有限:借时只在「还有下一段可以付账」时成立,路径终点是输出端口或硬宏时,无处可借,这也是为什么 useful skew 对寄存器密集的流水线段最有效、对宏边界路径基本无效。
二、偏差的代价面:借时不是免费午餐
既然只是搬运,为什么要把它当成优化手段?因为不搬的话,补 setup 的手段都有真实成本:upsizing 单元加面积和功耗,插 buffer 加延迟级数和功耗,换低 VT 单元加漏电。借时调的是时钟树,时钟树本来就在那,改的只是分支拓扑和 buffer 位置——边际成本极低。但它也有自己的代价清单:
| 维度 | 压平 skew 的传统 CTS | 引入 useful skew 之后 |
|---|---|---|
| setup 余量分布 | 长路径紧张,短路径闲置 | 全局更均衡,WNS 改善 |
| hold 压力 | launch/capture 同时到,天然宽松 | 相邻寄存器 skew 增大,hold 变紧 |
| 时钟树功耗 | 追求最短均衡,buffer 数较少 | 推迟分支要插延迟链,buffer 变多 |
| OCV 敏感度 | skew≈0,共路径补偿充分 | 刻意偏差放大了 OCV 不确定性敞口 |
| 签核复杂度 | 一套偏差目标 | 每叶一个目标,验证矩阵膨胀 |
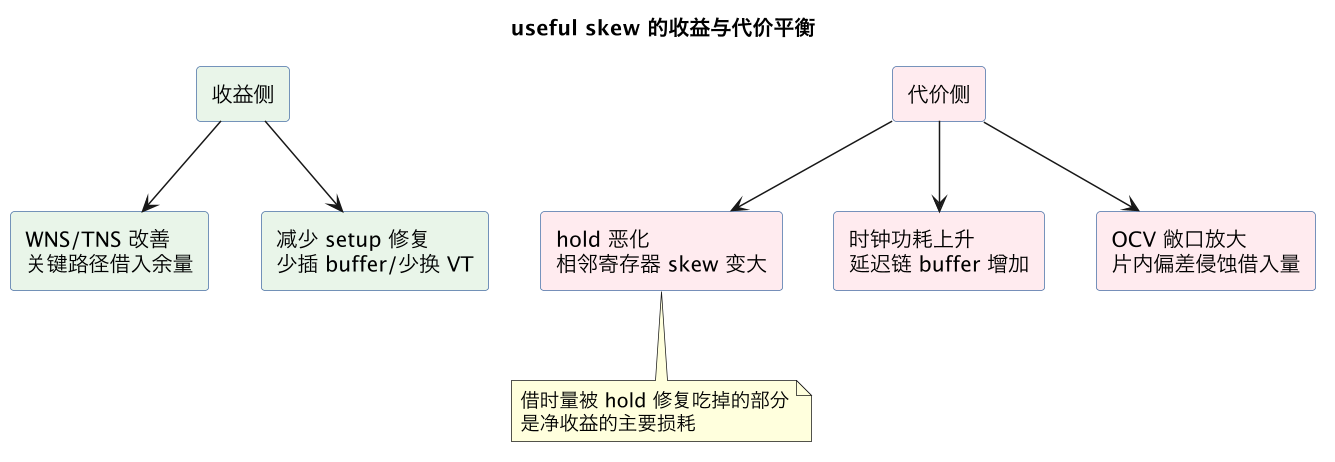
这张平衡图决定了工程姿势:useful skew 是收敛后期的精修工具,不是前期就放开的默认策略。主流团队的节奏是先按近零 skew 把时钟树做到位、用常规手段把 setup 收到一个量级,再对剩余的关键路径施加有限的借时目标——典型上限是周期的 5% 到 10%,超过这个范围 hold 修复成本会反超收益。
三、CTS 阶段怎么把目标偏差「种」进树
有用偏差优化在物理实现流程里的落点是 CTS 及其前后两个窗口:CTS 之前的 preCTS 时序优化阶段,工具可以基于理想时钟模型先试算一遍「哪里值得借」;CTS 阶段把试算出的偏差目标(skew target)变成真实的树结构;CTS 之后的 postCTS 优化在真实时钟下复核并微调。
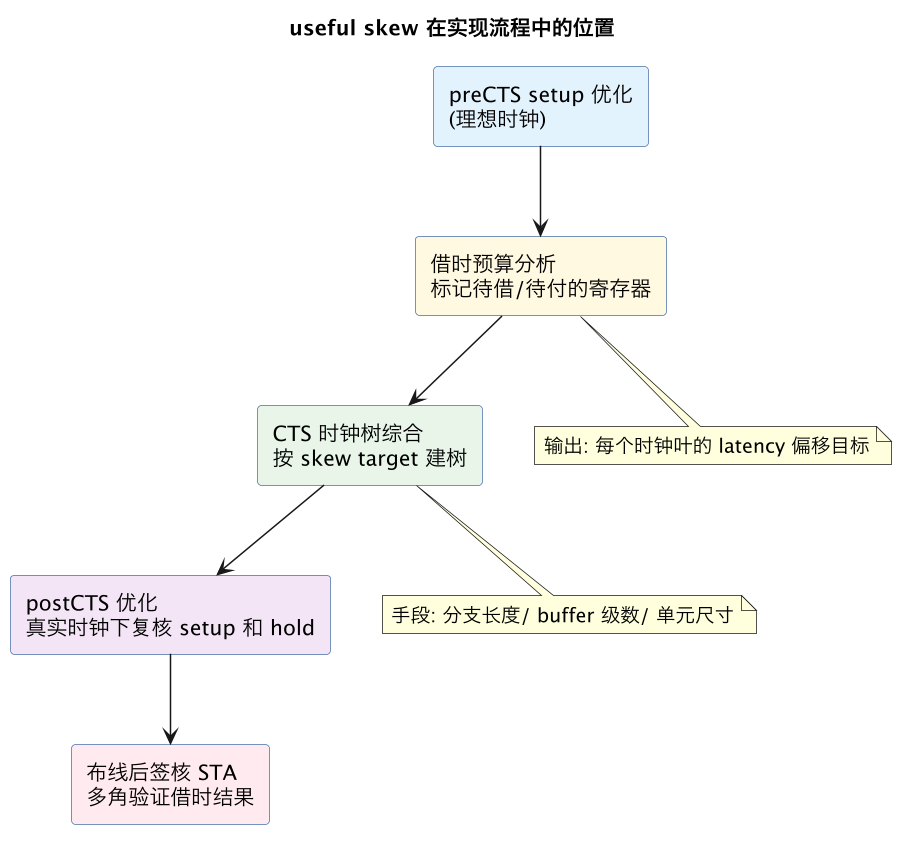
CTS 工具实现目标偏差的物理手段就三种,按代价从低到高排:
- 分支走线长度:让某个子树的互连绕一点路或缩短一点路,改变 network latency,几乎不增加 buffer;
- buffer 级数与尺寸:在需要推迟的分支上多插一级小 buffer,或把已有 buffer 换小一号拖慢边沿——代价是功耗和面积;
- 叶子聚类调整:改变 clock gating 单元下游的分组方式,让「要早到」和「要晚到」的寄存器分进不同子树,从源头错开。
现代工具(Innovus 的 CCOpt、Fusion Compiler 的 clock tree 引擎)都支持直接设置 per-pin 的 skew target 或按 path group 自动推导借时量。一个典型的 CCOpt 侧配置片段是:
# 对关键时钟域设置借时预算
set_ccopt_property useful_skew_maximum_delay 0.08 -clock_tree core_clk
set_ccopt_property useful_skew_minimum_delay -0.03 -clock_tree core_clk
# 让引擎在建立树时以时序为驱动,而非纯平衡
set_ccopt_property balance_mode timing_driven
这里 useful_skew_maximum_delay 就是那根「借时上限」的缰绳——不设它,激进的时序驱动模式可能为追 WNS 把某些叶子推迟出几百皮秒,postCTS 的 hold 修复立刻爆表。流程纪律上建议:借时范围从保守起步(周期的 3%-5%),看 postCTS 的 setup 和 hold 此消彼长再逐步放宽,每一档都全量复核 hold,而不是只看 setup 转绿就收工。
工具之外还有一层人工判断:借时目标的推导结果应当逐条过一眼,凡是落在时钟门控单元内部、跨时钟域边界附近或复用数据通路节点上的目标,优先级要压低甚至删掉——这些位置的偏差改动会牵连多条路径,工具按局部最优给的答案,放到全局常常是负收益。
还有一个容易被忽略的前置条件:借时目标依赖准确的 preCTS 时序画像。如果综合阶段的线负载估计和真实布线偏差很大,试算出的「富余段」可能根本不富余,借时目标种进树里就是错的。所以 useful skew 的效果和 布局布线流程前段的预测质量直接挂钩——这也是它通常只在设计相对成熟、布局已冻结的中后期才放开的原因之一。
四、典型收益量级:真实项目里能看到什么
抛开厂商白皮书,工程社区和项目复盘里反复出现的数字区间大致是:对 setup 已收敛到「WNS 在负几十皮秒、TNS 有几百条违例」的设计,施加 5% 左右的借时预算后,WNS 普遍能改善 30% 到 60%,TNS 违例条数减少一半以上;对于流水线均衡性差(级间逻辑深度悬殊)的设计,改善幅度更大,因为可搬运的余量本来就多。反过来,逻辑深度本来就均匀的设计,借时空间小,收益可能只有零星几条路径转绿。
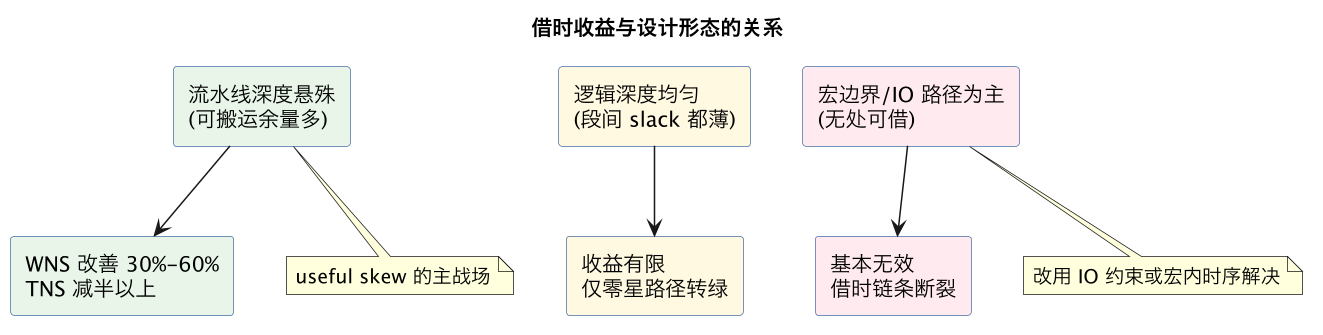
这张图同时是适用范围判据。评审要不要上 useful skew 时,先看违例路径的形态分布:集中在寄存器链内部、前后段 slack 一紧一松的,是借时的理想对象;集中在宏接口和 IO 的,借时帮不上忙,别浪费迭代。
五、签核风险:hold、OCV 与多角的三重考验
useful skew 真正的难点不在「种」,在「守」。刻意的非零偏差会在签核侧放大三类风险。
第一是 hold。 相邻两级寄存器之间,launch 时钟晚到、capture 时钟早到,等于把 hold 检查窗口反向拉伸。压平 skew 时这条检查天然宽松,引入借时后,原来 Setup 侧的「搬运」在 hold 侧是反向搬运——借入的每一段都可能是另一处的 hold 负债。工程上的兜底是 hold 修复预算前移:CTS 阶段就给 hold 留一份 min-delay buffer 的插入余量,postCTS 按最悲观 min 角全量修,而不是等布线后。
第二是 OCV 与 PVT 覆盖。 借时假设「这个叶子确实比那个叶子晚 80ps」,但片内工艺偏差(OCV)让真实偏差围绕目标值抖动。目标偏差越大,OCV 不确定性占借入量的比例越高,先进节点下一份 ±5% 的 derate 就能吃掉借入量的相当一部分。这就是为什么 MMMC 角管理里带借时的设计要按更严的 scenario 覆盖去签——setup 侧借入的余量必须在 cworst 角下仍然为正,hold 侧付出的余量必须在 cbest 角下仍然为正,两个方向都要留出「偏差自身的偏差」。
第三是多角一致性。 时钟树在不同 PVT 角下的延迟漂移不是等比例的:推迟分支上多插的那级 buffer,在高温角和低温角的延迟增量不同,目标偏差在角之间会漂移。签核时常见的事故模式是 typical 角借时效果完美,ff 低温角下偏差漂移导致 hold 成片翻红。对策是 CTS 阶段就启用多角建树(multi-corner CTS,让引擎同时优化多个角的偏差目标),而不是单角建完再祈祷。
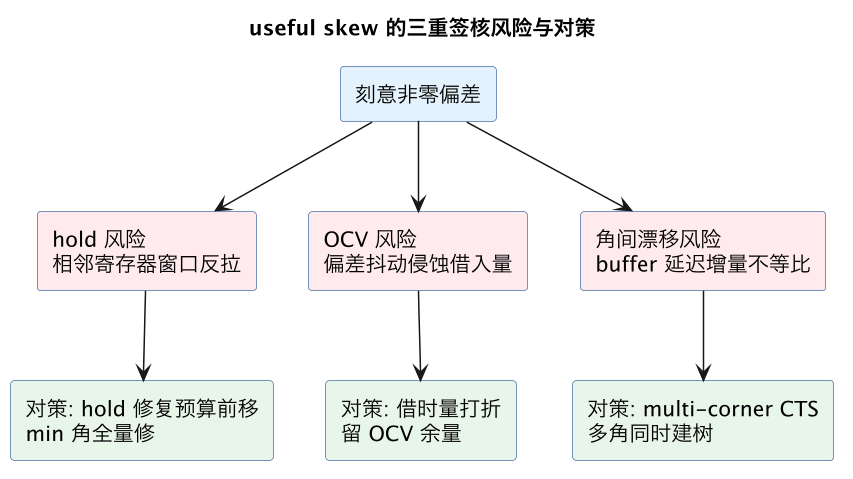
综合这三条,可以给出一个经验性的安全线:借时目标不超过周期的 5%-10%、借入量按 OCV 余量打八折计入预期收益、hold 在全部 min 角下签完才算数。超过这条线的激进借时,历史上换来的多是签核轮的返工而不是收敛提速。
六、典型翻车点
| 事故 | 根因 | 拦截动作 |
|---|---|---|
| setup 转绿 hold 爆红 | 只看 WNS,借时上限没设 | 设 useful_skew_maximum_delay,postCTS 全角复核 hold |
| typical 绿、ff 低温红 | 单角建树,偏差角间漂移 | multi-corner CTS,签核覆盖全部 min 角 |
| 借时无收益 | 违例集中在宏/IO 边界 | 先做违例形态分布评审,链内路径才借 |
| 时钟功耗超标 | 推迟分支 buffer 链过长 | 借时量设上限,优先用走线长度而非 buffer 调偏差 |
| 签核 STA 与实现口径打架 | 实现侧借时目标未随网表交接 | skew 目标进 X1 交接契约核对项 |
| OCV 吃掉全部借入 | 目标偏差相对 derate 余量不足 | 借入量按八折折算,超线即放弃借时改用常规修复 |
这一篇在知识体系里的位置
- 上游基础:CTS 时钟树综合讲压平 skew 的标准目标与建树流程,本篇是它的「进阶叛逆篇」;时钟延迟怎么进时序检查见 STA 时钟延迟。
- 进阶读物:CTS 高级主题覆盖时钟门控结构、多域协同等更广议题,本篇是其中借时专题的展开。
- 横向关联:借时收益的多角验证依赖 MMMC 角管理;实现流程上下文见 Innovus P&R 流程;借时目标属于 X1 交接契约里要点名的非默认设置。
总结
有用偏差优化是在 CTS 阶段故意让关键路径的 capture 时钟晚到、富余路径的 capture 时钟早到,把寄存器链上的闲置周期预算搬给紧张段的借时技术——它不创造余量只搬运余量,所以收益受限于设计形态(链内路径多才有效),代价集中在 hold 变紧、OCV 敞口放大和角间漂移三方面;工程纪律是借时上限压在周期的 5%-10%、multi-corner 建树、hold 全 min 角签完才算数,把它当中后期精修工具而非默认策略。