层次化 ECO:block 级改动与 top 层接口约束同步的工程纪律
更新时间:2026-10-04。层次化设计把一颗 SoC 拆成若干 block 并行实现,top 层只拿着每个 block 的抽象视图(ILM/ETM)做集成与签核——这套方法学的基础模型在 层次化流程 ILM 与 ETM 里讲过,block 侧接口时序的建模细节在 层次化 STA 与 block 接口 里展开。本篇解决的是这套体系里最脆弱的一环:ECO。平坦(flat)设计里一次 ECO 只动一个数据库;层次化设计里一次 block 级 ECO 可能同时改写 block 网表、block 的 boundary 时序、以及 top 层赖以签核的抽象视图——三者只要有一个没同步,top 级签核就在用过期的假设做判断。大改动怎么传播、小改动怎么豁免、版本怎么对齐,是本篇的主线。变更传播的总框架还可对照 ECO 变更传播数据流。
本文要回答的问题
- block 级 ECO 按什么标准分成「接口无关」和「接口相关」,两类各走什么流程?
- boundary 改动(端口方向、负载、时序弧)从 block 传到 top 的具体步骤是什么?
- ILM/ETM 抽象视图什么时候必须重生成,什么时候可以豁免,判据怎么量化?
- top 层给 block 的时序预算和 SDC 约束,ECO 后怎么重新对齐并验证一致性?
- 多 block 并行 ECO 时,版本管理上要守哪些纪律才能避免「签核用了混搭视图」?
一、两类 ECO:接口无关与接口相关
层次化 ECO 的第一道分类闸门是看改动会不会越过 block 边界。接口无关的 ECO 只动 block 内部:修一条内部路径的 setup 违例、换几个内部的 VT 单元、插一根内部的 hold buffer——boundary 端口的到达时间、所需时间、驱动能力和外部负载全都不变。这类 ECO top 层完全无感,block 自己修完、自己重签核、自己的交付物(网表、SPEF、SDF)内部版本号升一档就行,top 层的抽象视图纹丝不动。
接口相关的 ECO 则完全不同:任何导致 boundary 行为变化的改动都算。典型场景包括:ECO 插的 buffer 落在了输入端口后的第一级或输出端口前的最后一级,端口的 transition 或延迟变了;功能 ECO 改了端口逻辑(见 功能 ECO 网表补丁),端口时序弧变了;时钟树 ECO 动了 boundary 寄存器的时钟延迟,接口路径的 slack 分布整体平移。这类改动一旦发生,top 层手里那份 ILM/ETM 描述的就是「旧世界的 block」,用它算出来的 top 级接口路径 slack 全是错的。
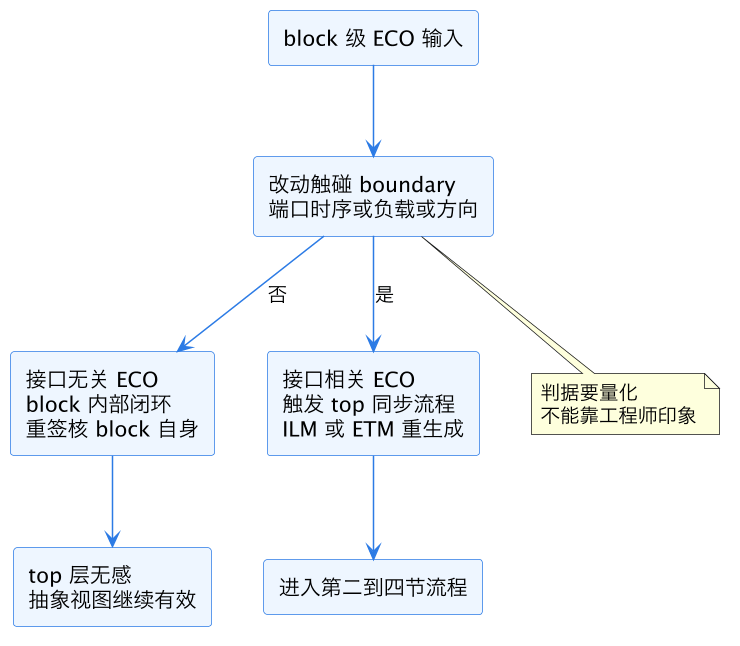
这张图是每次 block ECO 开工前必过的分岔口。工程上最忌的是「看着像内部改动就按内部处理」——buffer 插的位置离 boundary 寄存器只有两级,延迟变化经接口路径放大后照样超标。靠谱的做法是把判据写成脚本:ECO 前后各跑一次 boundary report,端口级时序参数(arrival、required、slew、cap)变化超过阈值(比如 5ps 或接口时钟周期的 1%)就强制走接口相关流程,人的判断只负责复核脚本结论。
还有一类灰色地带值得单独点名:内部 ECO 引发的「参数漂移」。比如修一条深在 block 内部的路径时做了大范围 sizing,整条供电网络的局部电流密度变了,IR drop 轻微恶化,boundary 寄存器的延迟跟着漂了几皮秒——网表层面的接口逻辑一个单元没动,但接口时序确实变了。所以分类判据不能只看网表 diff,必须看 ECO 后重跑的 boundary 时序数据,这也是判据脚本化的另一个理由。
二、boundary 改动怎么传到 top
接口相关 ECO 确定之后,改动要沿一条固定链路传上去。第一步是 block 侧重新签核接口路径:用 topdown block 时序预算 下发的预算约束,对 ECO 后的 block 跑一次完整 STA,产出新的 boundary 时序报告。这里要特别盯预算余量——block 内部修好了不等于接口达标,修 setup 的 sizing 可能把输入端口的负载电容顶大,反而恶化 top 侧驱动它的那条路径。
第二步是接口约束的反向协商。如果 ECO 后 block 端口参数超出了原预算的假设范围(比如输入 cap 超了预算表里的上限、输出 delay 吃掉了留给 top 的裕量),block 不能自作主张签收,必须把偏差数据抛回 top:top 侧评估能否在互连线段、端口 buffer 上吸收这个偏差,能吸收就更新预算表双方签字,不能吸收就打回 block 返工。这个「预算-实测-再预算」的闭环是层次化收敛的核心机制,本质上和 PR 时序收敛 ECO 在平坦设计里做的事一样,只是跨了层次边界。
第三步是同步交付物的版本:新网表、新 SPEF、新 boundary 报告、新抽象视图(下一节)打一个统一的版本标签,一起进交付库。top 侧的消费脚本只认整套标签,拒绝混搭。
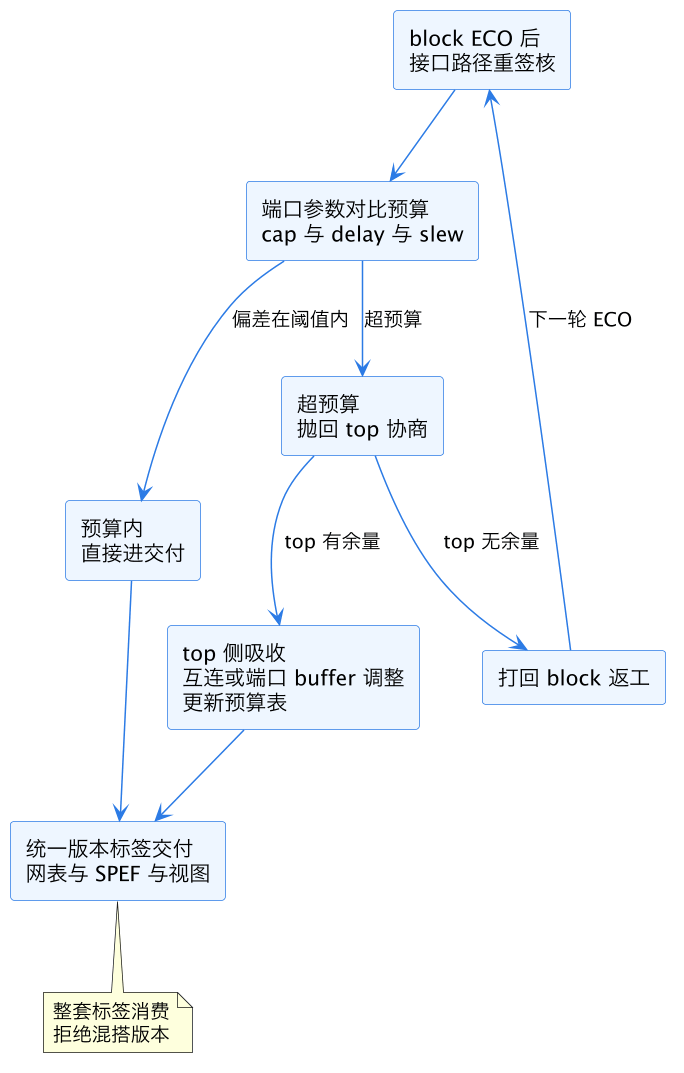
这张图展示的是 boundary 改动的上行链路和返工回路。注意「打回返工」那条边回到了起点——层次化 ECO 的代价模型里,跨层返工是最贵的一种,一次 block-top 往返通常以天计。所以成熟的团队会在 ECO 实施前做 what-if 预演(参考 时序 ECO what-if 分析):先在 block 数据库里试算 ECO 对 boundary 的影响,确认不碰预算红线再真正落刀,把返工率压到个位数百分比。
三、ILM/ETM 重生成的时机判据
抽象视图是 top 层看 block 的唯一窗口,它什么时候必须重生成,直接决定同步成本。激进策略是「block 网表一变就重生成」——最安全,但一次 ILM 提取在大型 block 上要跑几个小时,多 block 并行时排队资源会爆。保守策略是「攒一批再更新」——省机器,但 top 签核长期跑在过期视图上,风险随时间累积。工程上正确的姿势是按影响量化判据分级处理。
重生成的硬性触发条件有三类:一是 boundary 时序弧变化,ILM 里保留的正是 boundary 到第一级寄存器的接口逻辑,这部分网表或延迟变了视图就必须重来;二是端口电学参数变化超过工具建模精度,比如输入 cap 变化让 top 侧算出的端口 slew 偏差超过签核容差;三是时钟定义变化,block 内部时钟树 ECO 改了 boundary 寄存器的 clock latency,而 ILM/ETM 里时钟延迟是写死的建模值。ETM(liberty 形式的接口时序模型)的判据类似,只是它表达的是端口到端口的时序弧查表,任何落在表里的弧变了都得重提。
可以豁免的场景也要写清楚:纯内部 ECO 经脚本确认 boundary 报告零差异、金属层 ECO 只动了内部走线(见 金属层 ECO 备用单元流程)且寄生提取显示端口 net 无变化——这些场景重生成纯属浪费算力,豁免记录进 ECO 单归档即可。
| 判据维度 | 必须重生成 | 可豁免 | 量化阈值示例 |
|---|---|---|---|
| boundary 时序弧 | 接口逻辑网表或弧延迟变化 | 仅内部路径变化 | 弧延迟变化 > 5ps |
| 端口电学参数 | 输入 cap / 输出驱动变化 | 变化在建模精度内 | cap 变化 > 预算 2% |
| 时钟建模 | boundary 寄存器 latency 变化 | 仅内部 sink 变化 | latency 变化 > 5ps |
| 金属层改动 | 端口 net 寄生变化 | 纯内部走线 | 端口 net RC 变化 > 1% |
四、top 侧对齐:约束、SDC 与签核验证
视图更新到 top 只是完成了一半,top 侧还要做一轮对齐验证。第一是对齐 SDC:block 交付的 boundary 约束和 top 的接口约束必须同源——top 侧用 set_input_delay / set_output_delay 描述的接口预算,和 block 侧签核用的预算值要逐端口对拍。SDC 本身是活文档(生命周期见 SDC 数据流),ECO 改了预算却没同步 SDC 版本,是最经典的低级错误。
第二是重跑 top 级接口路径签核:加载新 ILM/ETM 后,在 Signoff STA 与 PrimeTime 环境里对所有跨 block 路径重新计时。要盯两个指标:接口路径 slack 的变化量是否和 block 上报的 boundary 偏差一致(不一致说明视图提取或约束映射有洞),以及是否出现新的跨 block 违例。MMMC 环境下(见 corners 与 MMMC 数据流)这一步要每个 corner 各跑一遍,ILM 也是按 corner 交付的,混 corner 加载属于流程事故。
第三是回归比对:把 ECO 前后的 top 级 QoR 报告做 diff,接口路径之外的数字应该零变化——top 层自己的逻辑没被这次 ECO 碰,任何意外的 slack 漂移都说明有未声明的改动混进了交付物。这条「无关路径零漂移」检查是抓版本混搭的最后一道网。
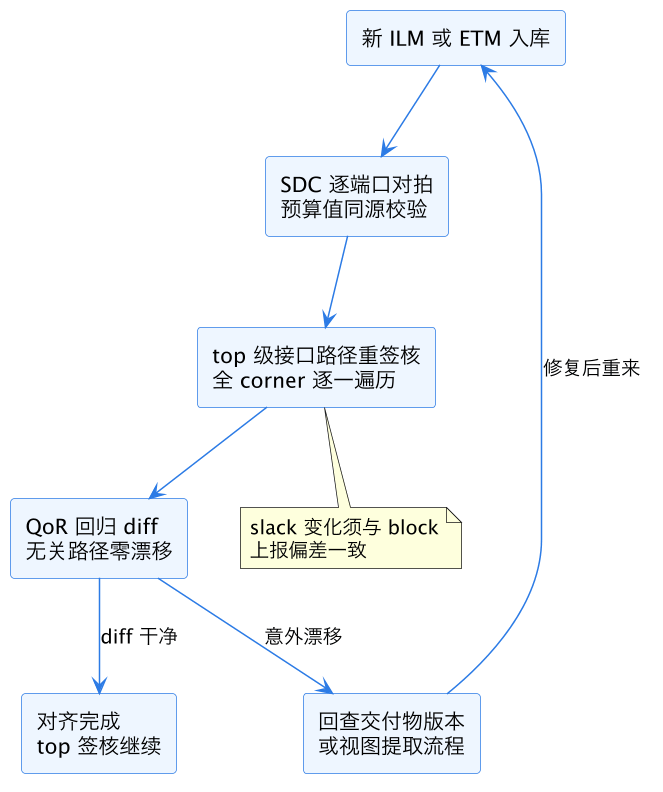
这张图是 top 侧三段式对齐流程。实战里 debug 支路最常见的根因不是工具问题,而是人:block 团队交了视图忘了交配套 SDC,或者 top 脚本从库里抓到了旧标签的版本。流程自动化的价值就在这里——把「拿哪份文件」从人的记忆变成标签系统的机械查询。
五、版本纪律:多 block 并行 ECO 不翻车的规矩
单 block ECO 的同步已经够繁,真实项目里更常见的是多个 block 同时改。这时版本纪律成了生死线。规矩一:基线制。top 层冻结一个「集成基线」,内含每个 block 的视图版本清单;任何 block 的 ECO 交付只进候选区,通过第三节判据和第四节对齐验证后,基线清单整体升版——top 签核永远跑在一份完整自洽的基线上,不存在「A 用新视图、B 用旧视图」的中间态。这和 数据管理数据流 讲的配置管理是同一套思想在 ECO 场景的落地。
规矩二:原子升级。一次基线升版要么包含某 block 的全套交付物(网表、视图、SDC、SPEF),要么一样不含。半套交付比不交付更危险——新视图配旧 SDC 的签核结果看起来有数,实际上全是错的,而且错得很安静。
规矩三:窗口对齐。接近 tape-out 时,所有 block 的 ECO 要排进统一的集成窗口:窗口内冻结交付,top 侧集中重签核,确认收敛后进 Signoff 收敛 ECO 的最后闭环。各 block 各自为政、随到随交的「流式」模式在项目早期可行,收官阶段必然制造版本地狱——top 每签核一次面对的视图组合都不一样,QoR 趋势失去意义,收敛判断无从下手。
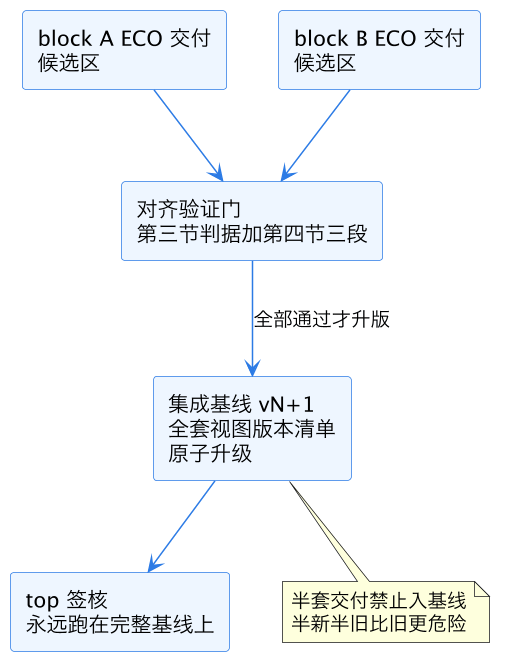
这张图是版本纪律的全貌:多个 block 的 ECO 交付在候选区等待,验证门全绿后基线原子升版,top 签核只消费基线。它回答了一个管理层常问的问题——为什么 ECO 都交付三天了 top 还没用新数据?因为零散消费每一份交付的代价(每次重签核、每次 QoR 波动分析)远大于攒齐一批、验证、原子升版的一次性成本。纪律不是官僚,是把不可控的混搭风险换成可控的批量成本。
规矩四:审计留痕。每一次基线升版都要能回答「这版基线里每个 block 的视图是从哪份网表、哪个 corner、哪次 ECO 提出来的」。这意味着交付库里视图文件、来源网表版本、提取日志三者要绑定归档。tape-out 后的硅后问题回溯(见 硅反馈数据流)经常要倒查几个月前某次 ECO 的完整链路,没有留痕纪律,回溯就退化成考古。
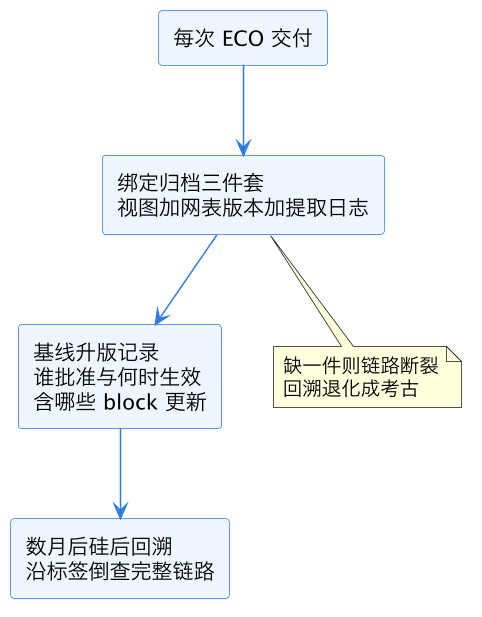
这张小图是审计留痕的最小闭环:交付即归档、升版即记录、回溯可倒查。它平时看起来是纯开销,第一次硅后定位救回一次 respin 就值回全部成本。
这一篇在知识体系里的位置
本篇是 eda/ 目录层次化设计线的「变更侧」专文:静态视图建模在 层次化流程 ILM 与 ETM,接口时序分析在 层次化 STA 与 block 接口,预算下发在 topdown block 时序预算,本篇讲的是这些静态资产在 ECO 冲击下如何保持一致。横向连接 ECO 谱系的 功能 ECO 网表补丁、金属层 ECO 备用流程、PR 时序收敛 ECO 与收官阶段的 Signoff 收敛 ECO,方法论底座是 ECO 变更传播数据流 与 数据管理数据流。读完本篇,一次 block 级 ECO 从落刀到 top 签核重新可信之间的每一步,你都知道该检查什么、该冻结什么。
总结
层次化 ECO 的核心是一条「分类 → 传递 → 重生成 → 对齐 → 基线升版」的同步链:先把改动按是否触碰 boundary 分流(脚本化量化判据,不靠印象),接口相关改动经「block 重签核 → 预算协商 → 统一标签交付」传到 top,ILM/ETM 按 boundary 时序弧、端口电学参数、时钟 latency 三类硬判据决定重生成或豁免,top 侧再做 SDC 逐端口对拍、全 corner 接口路径重签核、无关路径零漂移回归三段验证,最后多 block 交付以基线制原子升版——top 签核永远只消费完整自洽的基线,任何半套交付、混搭版本、流式交付都是让签核结果安静失效的捷径。