MBIST 并发测试:多存储器并行 BIST 的功耗调度与验证要点
更新时间:2026-10-07。一颗中端 SoC 上挂着三四百个 SRAM/ROM/Register File 实例是常态——L1/L2 缓存、各类 FIFO、查找表、TCAM,全都要过 MBIST(Memory Built-In Self-Test,存储器内建自测试)。如果一个一个串行跑,测试时间直接吃掉 CP(Chip Probing,晶圆测试)成本的大头;如果一口气全并发,瞬间功耗又可能把芯片打穿。MBIST 并发测试的核心就是在这两头之间找平衡:用分组调度把测试时间压下去,同时把每一步的功耗钉在预算内。这一篇是 DFT 方向的标准篇,MBIST 原理与算法背景见 MBIST 存储器内建自测试 和 March 算法详解,修复流程见 MBIST 修复流程验证。
本文要回答的问题
- 为什么不能把所有存储器一把全并发跑 MBIST?
- 并发分组按什么维度切,功耗预算怎么算?
- 调度序列怎么编排,串行/并发混合时接口怎么接?
- 验证侧要钉死哪些检查点,覆盖率怎么闭环?
- 量产导入时常见哪些坑,怎么提前排掉?
一、并发 MBIST 的动机与功耗墙
先算一笔账。某 7nm 网络芯片有 412 个存储器实例,逐个串行跑完整 March C- 算法需要约 28ms;ATE(Automatic Test Equipment,自动测试机)机时按每秒几美分计费,单颗芯片光 MBIST 就要摊掉近 1 美分的测试成本,月产百万颗就是上万美元。把并发度拉到 8 组,测试时间降到 4ms 左右,成本砍掉七分之六——这就是并发测试的原始动机:测试时间就是钱。
但并发不是免费的。MBIST 跑 March 算法时,存储器阵列在读、写、读三个操作间高频翻转,动态功耗远高于正常功能模式。实测数据里,单块 16KB SRAM 跑 March C- 的瞬时功耗可达功能模式的 2 到 3 倍;如果 400 块同时开跑,芯片总功耗可能冲到功能峰值的 1.5 倍以上,直接触发三个问题:一是 IR Drop(电压跌落)超标,存储器在低压下读出错误数据,造成误判(overkill,好片被当坏片扔);二是片内温度骤升,加速老化甚至触发热保护;三是 ATE 供电能力超限,机台直接报警停机。功耗墙就是并发度的天花板。
上图把三种执行方式和三条功耗约束画在了一起:串行省功耗但烧机时,全并发省机时但撞功耗墙,分组并发是唯一可行的落点——组数由最紧的那条约束反推。实际项目里 IR Drop 往往是最紧的,因为它直接造成误判,损失的是良率。
二、并发分组的四个维度
分组不是随手把 412 个实例切成 8 堆。切组的依据有四个维度,优先级从高到低。
物理位置(电源域)。同一个 power domain(电源域)内的存储器尽量分散到不同组,避免某一域内多实例同时翻转造成局部 IR Drop 热点。Floorplan 上相邻的 SRAM 宏也尽量拆开,因为它们共享局部的供电网格。
存储器类型与容量。同组内实例的测试时长要接近,否则组内最慢的那块拖住整组——大容量 SRAM(如 2MB L2 切片)和小容量 RegFile(128 项)混在一组,RegFile 早早跑完干等,并发收益被稀释。经验做法:按测试周期数排序后做贪心装箱,组间时长偏差控制在 10% 以内。
时钟与接口共享。挂在同一个 MBIST 控制器下、共享测试总线的实例天然要排进同一组或相邻组,调度状态机按控制器粒度推进。跨时钟域的实例还要确认测试时钟切换的毛刺约束,见 at-speed 时钟控制。
修复资源冲突。带 BISR(Built-In Self-Repair,内建自修复)的存储器,修复信息要写进共享的 eFuse 或修复寄存器链——同组并发的实例如果共用一条修复链,修复写回阶段必须串行化,调度里要给这一阶段单独留时隙。

上图是分组流程的四条输入线:四个维度各自过滤一轮,最后汇总成满足功耗预算的分组方案。这个方案要同时交给两个下游——ATE 测试程序按它排执行序列,功耗签收(power signoff)按它做矢量化的 IR Drop 分析,两边用的是同一张分组表,任何一方改动都要回灌另一方。
三、功耗预算的算式与调度序列
每组的功耗预算不是拍脑袋,是从三条限值反推出来的。简化算式:单组预算 = min(域 IR Drop 限值折算功耗, 结温限值折算功耗, ATE 供电余量) − 背景功耗。背景功耗指测试模式下常开逻辑的功耗(PLL、扫描链闲置态、IO 保持),实测值通常在总预算的 20% 到 30%。以某项目为例:芯片测试模式总功耗上限 6W,背景功耗 1.5W,剩余 4.5W 分给并发组;单块 SRAM 平均测试功耗 0.55W,则单组最多 8 块,412 块切成约 52 个调度步——但按时长装箱后实际合并为 8 组循环、每组内部再分两拍,最终 16 个调度步完成。
调度序列(schedule)由测试控制器的有限状态机驱动:每个调度步拉起本组的 BIST 使能,等待各控制器回 done,收集 fail 标志,再推进下一步。带修复的实例在全部调度步完成后统一进入修复写回阶段。
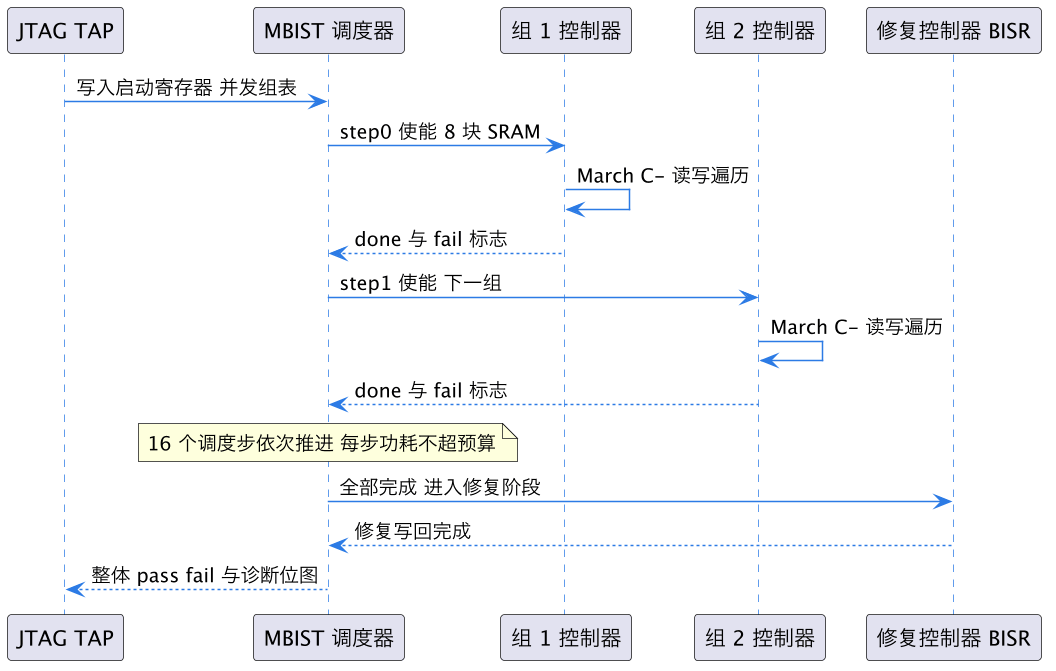
上图是一个简化到两组的调度时序:调度器串行推进每个并发组,组内多块并行;所有组跑完后才进入修复写回——因为修复资源是全芯片共享的,必须串行。注意图中「done 与 fail 标志」这一拍,调度器必须等组内最慢的控制器回 done 才推进,这就是第二节要求组内时长对齐的原因。验证时要特别检查一种边界:组内某控制器因缺陷永不回 done,调度器要有超时跳出机制并把该组标记为 fail,否则 ATE 会整颗挂起烧机时。
四、验证侧的五个检查点
并发调度的验证比单块 MBIST 多出一整层,核心检查点有五个。
分组表一致性。RTL 里实现的分组表(通常在调度器配置寄存器或硬编码 ROM 里)必须与 DFT 交付的分组文档逐位一致。写一条断言:每组使能信号拉起时,被使能的控制器 ID 集合等于分组表预期集合——这条检查在回归里抓到过「文档改了 RTL 没改」的真实事故。
功耗波形审查。功能仿真不验功耗,但可以验「同一时刻使能的组数不超过 1」「相邻调度步之间有足够的间隔拍」这类结构性约束。真正的功耗验证交给功耗仿真工具跑矢量化分析:把调度序列的波形文件喂给 IR Drop 工具,确认每一步的峰值电流都在包络内,流程见 功耗感知仿真 UPF。
fail 隔离与诊断。某组报 fail 时,诊断数据(哪块存储器、哪个地址、哪一拍)必须完整传出,不能被后续调度步覆盖。检查点:注入单块存储器的固定故障,跑完整调度序列,确认 fail 位图精确定位到注入实例,且其余组结果不受影响。
超时与异常路径。用 force 语句强制某控制器 done 信号挂起,验证调度器超时计数器动作、错误码上报、序列能终止。这条路径在 RTL 评审里最容易被漏掉,因为正常流程永远走不到它。
修复阶段串行性。带 BISR 的实例并发跑完算法后,修复写回必须逐个进行。检查修复链上任意时刻只有一个实例处于写回态,eFuse 烧写电压只被拉起一次,相关背景见 BIRA/BISR 修复机制。

上图是五个检查点汇入覆盖率闭环的结构:每一条检查点都要有定向用例能稳定复现,再加上故障随机注入的回归。覆盖率模型建议按「调度步 × 故障模型(stuck-at、transition、coupling)× 测试时钟档位」建 cross,bin 数会到几千个,但这是量产误判率收敛到 ppm 级别的必要投入。
五、量产导入的坑与混合调度策略
纸面方案到量产之间还隔着几个经典坑。其一,测试时钟频率的功耗非线性:MBIST 通常支持多个时钟档位,降频可以线性降动态功耗,但 IR Drop 的瞬态分量不降反升的风险存在——某些设计在高频下反而因为翻转分散而更平稳,结论必须以实测 IR Drop 报告为准,不能拍脑袋降频。其二,温度自反馈:长跑 MBIST 时结温爬升会使漏电增大、时序边际收缩,高温档位的功耗预算要单独留 10% 到 15% 裕量,量产三温(-40°C/25°C/125°C)测试程序要分别标定。其三,CP 与 FT(Final Test,终测)调度不能照抄:CP 用探针卡,供电和散热条件差,并发度要保守;FT 用 socket 且封装后散热好,可以放开到更激进的分组,两套调度表分开维护。其四,诊断模式要留后门:量产 fail 片要做失效分析时,需要能把任意单个实例从分组里摘出来单独跑,调度器要支持「单步单组单实例」的降级模式,相关测试模式划分见 CP/FT/老化诊断。
混合调度是工程上的常见妥协:对大功耗实例(大容量 SRAM、TCAM)采用严格分组串行,对小功耗实例(零散 RegFile)打包成一组全并发,用一张两级调度表描述。这样比纯串行快 4 到 6 倍,又比均匀分组更不容易踩热点。下面这张表把三种调度策略的取舍放在一起对比:
| 策略 | 测试时间(412 实例示例) | 峰值功耗 | 误判风险 | 调度复杂度 | 适用场景 |
|---|---|---|---|---|---|
| 全串行 | 约 28ms | 最低(单实例级) | 极低 | 最低 | 小芯片、样片阶段 |
| 均匀分组并发 | 约 4ms | 中(受预算约束) | 低(预算内) | 中 | 量产主流 |
| 两级混合调度 | 约 5ms | 中高(大实例独占步) | 低 | 高 | 实例功耗差异大的芯片 |
表里混合调度的时间略长于均匀分组,因为大功耗实例独占调度步时整组资源被稀释;但它换来的是功耗波形更平、热点更可控。实际选型看实例功耗分布的方差:方差小走均匀分组,方差大走混合。

上图是两级混合调度的序列结构:大实例独占前几步,中等实例中并发,小实例一把打包,修复串行收尾。功耗波形呈阶梯状而不是尖峰——每步都贴近预算上限跑,利用率最高,又始终留有不越线的裕量。这张阶梯图也是功耗签收报告里要附的标准交付物。
这一篇在知识体系里的位置
本篇是 chip-design/verification 目录 DFT 族的标准篇,主关键词 MBIST 并发测试。它向上承接 MBIST 存储器内建自测试 的单实例原理与 March 算法详解 的算法层背景;横向与 MBIST 修复流程验证(修复串行化阶段)、低功耗捕获测试(扫描侧的同类功耗问题)、扫描 shift 功耗控制(功耗墙的另一战场)同属测试功耗族;量产导入对接 CP/FT/老化诊断,功耗验证方法论见 功耗感知仿真 UPF。
总结
MBIST 并发测试的本质是拿功耗预算换测试时间:按电源域打散、按时长装箱、按控制器聚类、按修复资源串行化四个维度切组,单组预算从 IR Drop、结温、ATE 供电三条限值反推,调度器逐步推进、修复阶段串行收尾;验证钉死五个检查点——分组表一致、功耗包络、fail 隔离、超时路径、修复串行,再按「调度步 × 故障模型 × 时钟档位」闭环覆盖率;量产时 CP 保守、FT 激进两套表分开维护,实例功耗方差大就用两级混合调度把功耗波形压成阶梯——组切得对、功耗钉得住、诊断留后门,并发 MBIST 才能既快又稳。