神经网络入门 01:它解决什么问题、到底在学什么
更新时间:2026-09-08。本文是
nn/域入门第 01 篇。域导航见 神经网络与深度学习导读;硬件视角的推理入门见 fpga 域 神经网络与 FPGA,算力载体见 gpu/ 域。
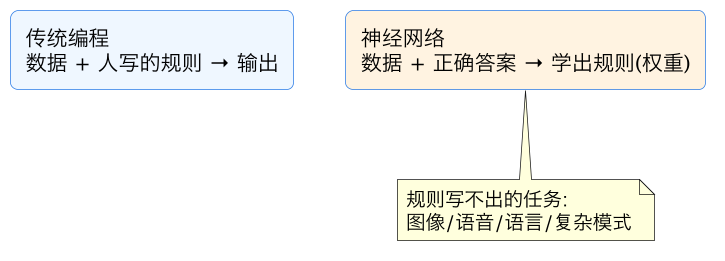
一、传统编程 vs 神经网络
二、训练 = 下山三步循环
| 步骤 | 做什么 |
|---|---|
| 前向传播 | 输入过网络算出预测(大量乘加) |
| 算损失 | 预测和正确答案差多远 |
| 反向传播+更新 | 按梯度把权重往减小损失方向挪一小步 |
百万次迭代后,上亿权重学成模型。硬件加速点就在"海量乘加"。
三、任务版图与爆发条件
- 任务:分类 / 回归 / 检测 / 分割 / 序列转换(LLM)/ 生成 / 决策;
- 构件:MLP、CNN(图像)、Transformer(注意力,大模型);
- 爆发三要素:大数据 + GPU 算力 + 算法同时成熟。
常见坑对照
| 误解 | 实际 |
|---|---|
| 网络"理解"内容 | 它学的是输入到输出的统计映射 |
| 模型越大一定越好 | 还要数据匹配、会过拟合、推理更贵 |
| 训练和推理一回事 | 训练学权重(GPU 集群),推理做预测(可下沉边缘/FPGA) |
| 有 AI 就不需要懂硬件 | 部署延迟/功耗/成本正是硬件工程决策 |
相关与延伸
域导航:神经网络导读;后续:张量/前向反向传播、CNN、Transformer、训练实践。 硬件交叉:FPGA 推理入门、GPU 域、AI 应用见 data-ai。
总结
神经网络解决"规则写不出来但有大量数据"的问题:传统编程是人写规则算输出,神经网络是用海量"输入→答案"样本,让算法自动调整网络中上亿个权重(前向算预测→损失衡量误差→反向传播按梯度微调,循环百万次),把规则学出来——它本质是数据驱动的复杂函数拟合,擅长分类、回归、检测、分割、序列转换(翻译/对话)、生成等任务,核心构件是 MLP/CNN/Transformer。深度学习现在才爆发是因大数据、GPU 算力、关键算法三要素同时成熟;硬件工程师的位置在推理部署——训练靠 GPU 集群,延迟/功耗/成本敏感的推理场景下沉到 FPGA/边缘 GPU/NPU,理解"训练学权重、推理做乘加"这条主线后,后续张量、反向传播、量化、AI 芯片等篇都挂在这一直觉上。