Whisper 推理优化:流式 chunk、蒸馏小模型与 batched long-form 转写
更新时间:2026-10-03。前面 连续批处理调度器 讲的是 LLM 服务侧的吞吐工程,而语音识别(ASR, Automatic Speech Recognition)这条线上的当家模型 Whisper 有一套自己的瓶颈结构:编码器吃定长 30 秒音窗、解码器逐 token 自回归、长音频靠滑动窗拼接。原始实现的「一段音频进、一段文字出」在实时字幕、会议纪要、批量转写三种场景下分别撞上一次墙。Whisper 推理优化就是围绕这三堵墙展开的:流式 chunk 推理降延迟、蒸馏小模型降算力、batched long-form 提吞吐。本文把三条线的机制与数字讲清楚,底层的 KV cache 机制可对照 KV cache 推理显存管理。
本文要回答的问题
- Whisper 的 30 秒定长窗是怎么来的,为什么它同时是流式化的最大障碍?
- 流式 chunk 推理怎么把 30 秒窗拆小,chunk 边界的精度损失怎么补?
- distil-whisper 这类蒸馏模型砍掉了解码器的什么,为什么 2 层解码器还能保住字准率?
- batched long-form 转写如何把长短不一的音频拼成批,吞吐能提几倍?
- 三条路线怎么组合,实时字幕和离线批量转写各该选什么配置?
一、瓶颈结构:定长窗编码器加自回归解码器
先看清 Whisper 的计算结构。输入音频先被切成 16 kHz 采样,按 30 秒一段取出,算出 80 维 log-Mel 频谱(短于 30 秒的一律补零到 30 秒)。编码器是一个标准 Transformer,把 3000 帧频谱下采样到 1500 个音频 token,一次性算完;解码器拿着特殊起始 token 自回归地逐字吐出文本,每个解码步都要对编码器输出做交叉注意力,并用 KV cache 缓存历史。
这个结构里有三个让工程不舒服的点:
- 编码器定长:无论你说 2 秒还是 30 秒,编码器都按 30 秒算,短音频浪费大量计算;反过来流式场景里,想提早出字就必须伪造一个「30 秒窗」。
- 解码器自回归:large-v3 解码器 32 层,逐 token 串行,GPU 利用率低——这和 LLM decode 阶段瓶颈在带宽不在算力是同一个道理。
- 长音频靠滑窗拼接:原生方案是 30 秒窗滑动,用前一窗的文本当 prompt 维持上下文,窗间边界经常断词、重复或丢句。

上图是原始管线的三段式结构。注意编码器是「一次性并行算完」的,解码器才是逐 token 串行的——这决定了后文两条优化路线分别砍向哪里:蒸馏主要砍解码器深度,批处理主要救编码器与解码器的 GPU 占空比。
二、流式 chunk 推理:把定长窗拆小,把延迟降下来
实时字幕场景的核心指标是首字延迟(从人开口到屏幕上出现第一个字)。30 秒窗意味着最坏要等 30 秒,显然不行。流式化的思路是用小 chunk 喂编码器,让它在「比 30 秒短的窗」上工作。具体做法分两派。
第一派是「协议不变、输入截短」:既然编码器只要求输入是 30 秒以内补零的频谱,那就每攒够 1~2 秒音频就拼上已有的上下文凑一段送进去,靠 Whisper 自身的时间戳预测对齐,重复部分用后处理去重。这类方案(如 whisper_streaming 的 LocalAgreement 策略)的技巧在「本地一致性确认」:连续两次转写结果里前缀一致的部分才提交输出,不一致的尾部留着等下一帧再定,避免字幕闪烁。
第二派是「重训流式变体」:给编码器加因果卷积和 chunk 内注意力掩码,让音频 token 只依赖左侧历史,变成真正的流式编码器(类似 滑动窗口注意力 的思想)。NVIDIA 的 Canary、阿里的 Paraformer/SenseVoice 走这条路,延迟可压到几百毫秒,代价是要重新训练,不再是「拿现成 Whisper 直接用」。

上图的关键环节是确认逻辑:模型每帧都在「猜」,但只有连续两帧猜测一致的词才放行给用户。工程上还要处理 chunk 边界的断词——一个词横跨两个 chunk 时前一帧只看到了它的前半截,发音不全容易误识别,确认机制天然把这类词推迟到信息完整时再输出,这正是用「少量延迟」换「边界精度」的典型权衡。VAD(Voice Activity Detection,语音活性检测,先判断哪段有人声)也是必备前置:没人说话的静音段直接跳过,不喂模型,省算力也减少幻觉(Whisper 在纯噪声段容易「脑补」出字幕)。
流式化的第二个坑是上下文丢失。30 秒窗每次只看见最近 30 秒,人名、术语、前半句的指代都在窗外,识别质量相比「整段听完再转」有明显下滑。常用补丁有三个:一是把上一窗已确认文本的最后十几个词作为解码器 prompt 前缀,让模型知道前文话题;二是给热词表做偏置(在 prompt 里塞领域词汇,或通过 logit 偏置加权),医疗、法律这类术语密集场景能把专有名词错误率压下三到五成;三是 chunk 之间保留 1~2 秒的重叠带,靠时间戳对齐后去重,避免边界词被劈成两半。这三个补丁都是纯工程手段,不动模型权重,是「拿现成 Whisper 直接用」路线的主力工具箱。
还有一层容易被忽视的账:chunk 越小,每秒音频摊到的「补零浪费」越大。1 秒音频补零到 30 秒,编码器 97% 的计算在算零。所以流式实现的编码器通常会做动态形状截断——只算实际有效帧对应的卷积与注意力范围,把补零段跳过。faster-whisper 与 TensorRT 部署都支持这种变长输入,是实时场景把「小 chunk」和「低浪费」同时拿到的关键开关。
三、蒸馏小模型:解码器砍到 2 层的代价与收益
第二条线砍模型本身。distil-whisper(HuggingFace 出品)的做法是保留完整编码器、把 32 层解码器蒸馏到只剩 2 层,用 large-v3 当老师做序列级知识蒸馏(teacher 生成的伪标注当训练目标)。效果:模型参数从 1.55B 降到 0.76B,解码器参数占比从约一半降到个位数,短音频(小于 30 秒单次前向)上推理速度约 6 倍,词错率(WER)在英语短句上只退化 1 个百分点左右,且因为蒸馏目标平滑了老师的长尾幻觉,噪声段幻觉率反而下降。
为什么砍得动?ASR 的解码器比 LLM 的解码器「任务轻」得多:它生成的文本绝大部分由音频内容决定,语言模型的先验只起纠错润色作用。32 层解码器的大量容量其实在学「语言流畅性」,2 层加一个还不错的注意力就够把音频 token 对齐到字。这也解释了蒸馏版的一个已知短板:长音频上幻觉和重复回潮。长音频靠滑窗 prompt 维持上下文,2 层解码器对 prompt 上下文的利用能力弱,跨窗衔接变差——所以 distil 官方建议长音频配合 chunk 加批处理(见下节),用管线设计弥补模型能力。

蒸馏之外还有正交的手段叠加:INT8/FP16 量化(思路同 INT8/INT4 量化校准)、CTranslate2 引擎(faster-whisper 的核心,把计算图重写为带融合的 C++ kernel)、GGUF 格式 CPU 部署(whisper.cpp,与 llama.cpp 的 GGUF 格式 同源)。三者与蒸馏可叠加:distil 小模型 + CTranslate2 INT8 在一张消费级卡上能跑到实时率的几十倍。
| 模型档位 | 参数量 | 英语 WER(短句) | 相对速度(同硬件) | 适用场景 |
|---|---|---|---|---|
| large-v3 | 1.55B | 基准(约 8%~10% 量级) | 1x | 精度优先的离线转写 |
| distil-large-v3 | 0.76B | +1 个百分点左右 | 约 6x(短音频) | 实时字幕、批量短音频 |
| distil-medium / small 系 | 0.4B 以下 | +2~4 个百分点 | 10x 以上 | 边缘设备、草稿级转写 |
四、batched long-form:长音频切块成批,把 GPU 喂满
第三条线解决「一小时会议录音要转多久」。原始 long-form 管线是严格串行的:切窗、编码、解码、拼接,一个窗一个窗来,GPU 大部分时间在等解码器逐 token 吐字。优化后的 batched long-form(faster-whisper 与 transformers 4.36+ 都实现了)把流程改成:先整段跑 VAD 切成若干语音块,把所有块攒成 batch 一起编码、一起解码,最后按时间戳拼接。
这里有两个工程要点。一是块长相齐:batch 内各块补零到同一长度,补零比例直接浪费算力,所以切分时要按 VAD 边界尽量切成相近长度(典型 30 秒上限内尽量塞满),并按长度排序分桶——这与 LLM 服务里的长度分桶(见 连续批处理调度器)是同一手法。二是解码阶段用 batched greedy/beam:整个 batch 的 KV cache 并行推进,谁先吐出结束符谁先退出,剩下的继续——本质就是 ASR 版的连续批处理。
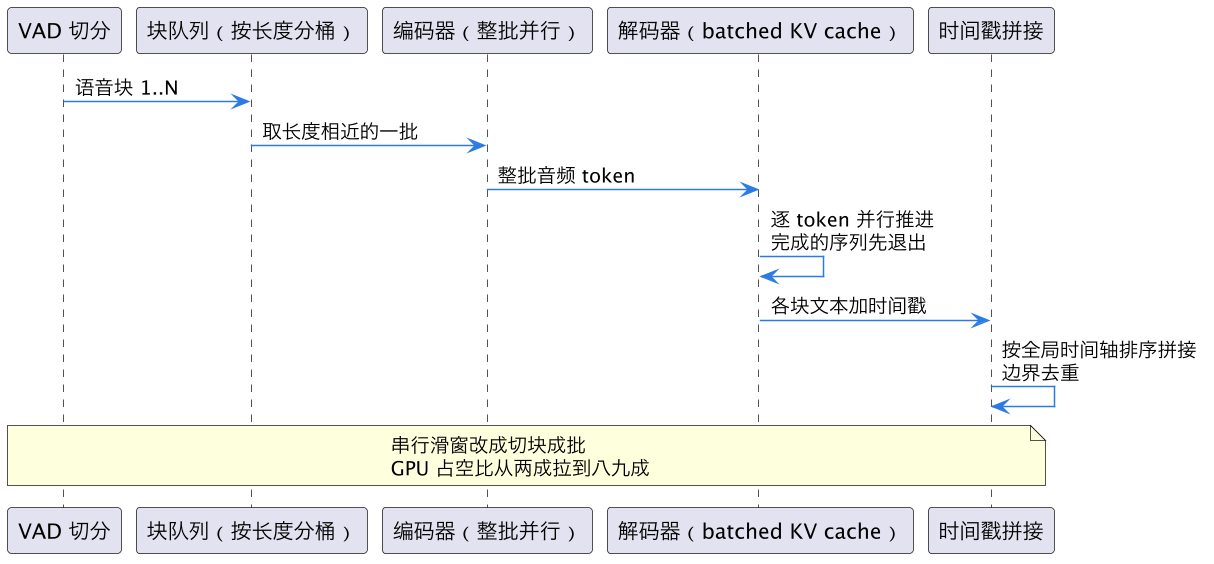
收益数字:官方报告 large-v3 配 batched long-form 在 A100 上吞吐提升约 4~5 倍(相对串行滑窗);faster-whisper 叠加 CTranslate2 与 INT8 后,单卡一小时音频几分钟内转完是常态。如果再叠 distil 小模型,三条线的收益近似相乘——模型变小、每块更快、块间还并行。精度侧的账也要记:切块转写与整段滑窗相比 WER 基本持平,差异集中在边界句的标点与大小写上,因为 VAD 块是按静音切的,不保证对齐句子边界。对精度敏感的场景可以在拼接后过一次轻量标点还原模型,把这块损失补回来。
需要注意批大小的副作用:批越大显存里的 KV cache 和频谱缓冲越大,且长尾长块会拖住整个 batch(其余块算完了等它),所以生产上通常批 8~16、分桶粒度 5 秒左右,在长尾巴与利用率之间取平衡。多卡或多文件并发时还可以按 CUDA stream 异步重叠 的思路把「VAD 切分」「编码」「解码」三段用流水线错开。
五、组合选型:实时字幕与离线转写两套配方
三条线不是互斥的,按场景组合:
配方 A 的关键词是延迟:chunk 大小取 1~2 秒,确认窗口 2 帧,模型用 distil 档位,INT8 量化,单并发下首字延迟可压到 1 秒上下。配方 B 的关键词是吞吐:VAD 切块、分桶成批、批 8~16,精度敏感就用 large-v3、不敏感就 distil,吞吐相比原始实现有一个数量级的提升。配方 C 面向没有 GPU 的场景,GGUF 量化模型加 CPU 线程绑定(手法同 llama.cpp CPU 线程绑定),4~8 核 CPU 跑 small 级模型能到实时率的 1~3 倍。
| 优化线 | 砍的是哪段 | 典型收益 | 主要代价 |
|---|---|---|---|
| 流式 chunk | 等待延迟 | 首字延迟 30 秒级降到 1~2 秒 | chunk 边界断词,需确认机制 |
| 蒸馏小模型 | 解码器算力 | 速度约 6 倍,参数减半 | 长音频幻觉回潮 |
| batched long-form | GPU 占空比 | 吞吐 4~5 倍 | 显存上涨,长尾巴拖批 |
最后补一条落地提醒:三条线各自的可观测性指标不同,上线前要先想清楚盯什么——流式看首字延迟分位数与确认回退率,批量看每小时音频的转写耗时与 GPU 占空比,蒸馏看相对基准模型的 WER 回归。指标体系的搭法可借用 LLM 推理可观测性体系 的分层思路,把延迟、吞吐、质量三类指标分开埋点。
这一篇在知识体系里的位置
本篇是「推理服务优化」线索在语音模态的展开:上游通用机制是 KV cache 推理显存管理(自回归解码的公共底座)与 连续批处理调度器(batched long-form 的思想源头);同层可对照 投机解码(LLM 侧另一种给自回归提速的路线,ASR 侧也有对应的 speculative 转写变体)、INT8/INT4 量化校准 与 TensorRT 推理优化(引擎层加速的通用手法);下游延伸是多模态理解管线里 ASR 前置模块的部署,以及 LLM 推理可观测性体系 在语音服务上的指标移植。
总结
Whisper 推理优化是三条线的组合拳:流式 chunk 用「小窗加前缀一致性确认」把首字延迟从 30 秒压到 1~2 秒,distil-whisper 靠「编码器全留、解码器砍到 2 层」的序列级蒸馏换来约 6 倍速度,batched long-form 用「VAD 切块、分桶成批、batched 解码」把 GPU 占空比拉满带来 4~5 倍吞吐——三者近似相乘叠加,再配 INT8 量化与 CTranslate2 引擎,同一张卡上的转写吞吐能比原始实现高出一个数量级以上,代价只是 chunk 边界与长音频幻觉这两处需要管线设计兜底的精度缝隙。