动态 IR 压降分析:vectorless 与 VCD 驱动、瞬态电流波形与 decap 布局迭代
芯片时钟一翻,数百万个晶体管在同一瞬间要电流,电源网格的电阻不答应——局部电压瞬间下陷,逻辑变慢,严重时功能出错。这就是动态 IR 压降(dynamic IR drop),先进节点电源完整性(PI)签核里最难收敛的科目。本篇把动态分析讲透:它和静态分析差在哪、vectorless 与 VCD 两种驱动方式怎么选、瞬态电流波形怎么建模、decap 迭代怎么一步步收敛到判据以内。电源网格的电气模型生成见 PGV 电源网格视图生成,本篇站在分析侧。
本文要回答的问题
- 动态 IR drop 和静态 IR drop 的本质差别是什么,为什么静态过了动态还会挂?
- vectorless 与 VCD/SAIF 驱动两种分析方式各自的盲区和适用场景?
- 标准单元的瞬态电流是怎么建模的,APL 电流波形起什么作用?
- 拿到动态压降违例,decap、电源网格、布局三类修复怎么排优先级?
- signoff 判据怎么定,分析报告里哪些指标必须逐条过?
一、动态 vs 静态:差在「时间」这个维度
静态 IR drop 分析把电流当成恒定值:每个 instance 按平均功耗折算成直流电流源,求解电阻网络的稳态压降。它回答的是「长期平均供电健不健康」,主要暴露网格结构性缺陷(某片区域 via 太少、某条主干太细)。
动态分析求解的是瞬态:电流随时间变化,网格里除了电阻还有封装电感、片上电容(decap + 寄生),系统本质上是一个带储能元件的瞬态网络。时钟沿前后几十到几百皮秒,电流尖峰把局部电压砸出一个坑;坑的深度取决于瞬态 di/dt、局部电阻、以及附近有多少电容能顶上。
这就是为什么静态过了动态还会挂:
| 对比维度 | 静态 IR drop | 动态 IR drop |
|---|---|---|
| 激励 | 平均电流(直流) | 随时间变化的瞬态电流 |
| 网络元件 | 只有 R | R + 片上 C + 封装 L |
| 时间尺度 | 稳态 | 时钟沿前后 ps–ns 级 |
| 暴露的问题 | 网格结构缺陷 | 同步开关引发的瞬态塌陷 |
| 典型修复 | 加宽/加密网格 | 加 decap、错相、降 toggle |
动态压降的危害路径是间接的:电压下陷 → 该处标准单元延迟增大 → 关键路径 setup 余量被吃掉。先进节点低压供电(0.7–0.9 V),10% 的瞬态压降就足以让局部延迟恶化 5%–15%——这是硅后「频率怎么都跑不上去、降电压就死机」类问题最常见的片内成因之一。
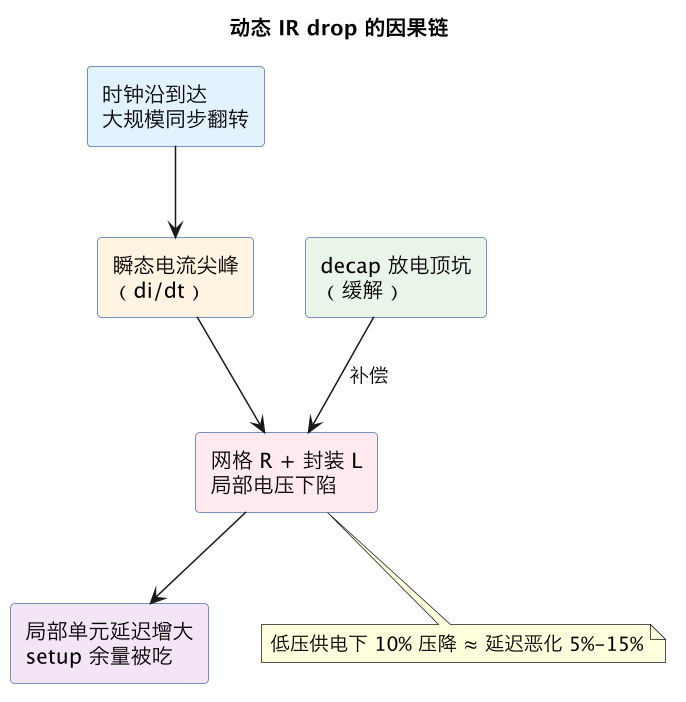
上图里 decap 是唯一站在「缓解」侧的元素——这也预告了修复手段的核心:timing 框是后果,drop 框是战场,decap 是主武器。
二、激励从哪来:vectorless 与 VCD 两种驱动方式
动态分析的准确性上限由翻转激励决定——哪些 instance 在什么时刻翻转,直接决定电流波形怎么叠加。工业界两种做法:
方式一:vectorless(无向量)。不给仿真向量,工具按概率模型假设每个 instance 的翻转行为:用静态概率分析(SPA)或用户指定的 toggle rate,再叠加「同时翻转比例」参数,构造出统计意义上的最坏激励。
- 优点:零依赖,网表加寄生就能跑,覆盖全芯片无死角,天然偏悲观,适合早期评估和 signoff 兜底;
- 缺点:悲观度不可控——它可能让逻辑上不可能同时翻转的两组逻辑同翻,报出的违例点要花大量人力甄别真伪。
方式二:VCD/SAIF 驱动。用功能仿真产生的波形(VCD)或翻转统计(SAIF)驱动分析,电流激励忠实于真实业务场景。活动率数据的格式与交接见 VCD/SAIF 活动率数据。
- 优点:违例点真实可信,能回答「这个业务场景下会不会出问题」;
- 缺点:覆盖盲区由向量决定——没跑到的场景等于没分析;而且门级仿真吐 VCD 极慢,全芯片全时段基本不可行,只能选时间窗。
工程上的标准姿势是两条腿:VCD 驱动跑真实场景验证「会不会出问题」,vectorless 跑全芯片兜底「最坏能坏到哪」。两者结论打架时(vectorless 报违例、VCD 不报),先查 vectorless 的同步翻转假设是否过激,再查 VCD 的向量覆盖率——bias 哪边都不能全信。
两种方式的对照一览:
| 维度 | vectorless | VCD/SAIF 驱动 |
|---|---|---|
| 前期依赖 | 无 | 门级仿真向量 |
| 覆盖 | 全芯片无死角 | 由向量决定,有盲区 |
| 悲观度 | 偏高(同步翻转假设) | 贴近真实 |
| 违例甄别成本 | 高(要证伪假违例) | 低 |
| 典型用法 | 早期评估、signoff 兜底 | 关键业务场景验证 |
VCD 方式里最容易翻车的是时间窗选择:门级仿真动辄微秒毫秒级,全时段分析不可行,只能截取高活动率窗口。选窗的依据应该是翻转率统计曲线(先跑一遍轻量统计找出 toggle 峰值区),而不是凭感觉选「看起来忙」的段。更隐蔽的坑是窗口的前几个时钟周期——VCD 起始处大量信号从 X 收敛到确定值,会产生现实中不存在的翻转浪涌,分析时要把窗口头部砍掉或做初始化对齐,否则报出的「最坏压降」其实是仿真伪影。
三、瞬态电流波形:APL 建模是精度分水岭
激励定了「谁翻」,还要建模「翻的时候电流长什么样」。早期做法是把每次翻转近似成三角波/指数波,峰值和宽度按 library 的功耗表估算——快但粗糙,峰值电流误差轻松到 30% 以上。
先进流程用 APL(Advanced Power Library)电流波形库:对每个标准单元、按输入 transition 和输出负载分档,用 SPICE 预表征出真实的瞬态电流波形(含短路电流分量、内部节点充放电)。分析时按实际的 transition/负载查表取波形。表征方法见 APL 电流波形表征。
为什么值得花这个成本?动态压降本质是「电流波形与电源网络阻抗的卷积」,波形峰值差 30%,压降峰值就差得更多(电感分量对 di/dt 更敏感)。用三角波近似的分析结果,和 APL 驱动的结果在同一设计上可以差出「过」与「挂」的区别。一句话:动态 IR 分析签核化的前提,是电流模型签核化。
四、一个算例:decap 要补多少,粗算怎么估
修复迭代中最高频的问题是「这片热点大概要补多少 decap」。粗算可以把 decap 当成给瞬态电流尖峰供能的水库:热点区在某时钟沿的瞬态电流超出电网能即时供给的部分,全部由 decap 放电顶上。
假设某 1 GHz 设计的热点区,瞬态分析显示时钟沿后 200 ps 内电流缺口约 50 mA,允许的局部压降是额定 0.8 V 的 5%(40 mV)。水库公式:
- Q = I × Δt = 50 mA × 200 ps = 10 pC;
- C = Q / ΔV = 10 pC / 40 mV = 250 pF。
也就是说,热点区有效半径内需要约 250 pF 的可用 decap。两个修正系数不能漏:其一,decap 的放电电流同样要走过一段网格电阻,离热点越远、顶上来的份额越少,工程上按距离打 5–8 折;其二,decap 在稳态时充到的电压本身就低于额定(静态压降),可用容量再小几个百分点。折算下来,实际要插的标称容量往往在粗算值的 1.5–2 倍,即 375–500 pF——换成具体工艺 decap 单元的数量,按单元手册的 fF/um^2 密度折算面积即可。
这个粗算的价值不在精度(瞬态分析会给出精确答案),而在决策速度:看到热点报告的两分钟内,你就能判断「这片靠填空位插 decap 够不够」,还是「空间根本不够,要动布局或网格」——这决定了走哪条修复支线,避免在插不满的路上空转两轮迭代。
五、违例修复:decap、网格、布局三线并进
分析报告出来,热点区域(压降超标区)通常成片出现在时钟负载重、toggle 率高的逻辑附近。修复手段按优先级排:
| 手段 | 作用机理 | 代价 | 适用 |
|---|---|---|---|
| 加 decap(去耦电容) | 就近储能,时钟沿瞬间放电顶坑 | 面积、漏电 | 首选,80% 的热点靠它解决 |
| 加密/加宽电源网格、加 via | 降低局部电阻 | 布线资源 | 结构性热点(decap 填不平的) |
| 布局调整(打散高 toggle 逻辑、时钟负载均衡) | 从源头摊平电流尖峰 | 时序扰动大 | 签核前中期 |
| 错相/分 bank 时钟 | 把同步翻转摊到不同时刻 | 架构级改动 | 早期规划 |
decap 迭代是最日常的循环,标准走法:
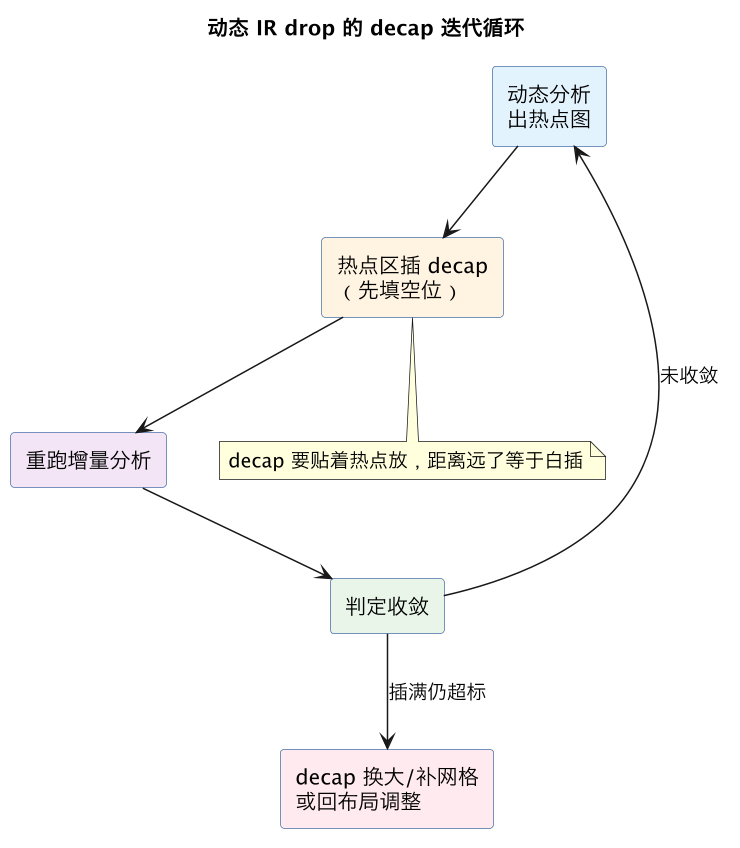
两个实操要点:
- decap 的位置比数量重要。去耦电容的有效半径有限(取决于网格电阻),离热点几十微米外的 decap 贡献断崖式衰减。插之前看热点图,贴着电流尖峰的 instance 群放,而不是全芯片均匀撒。空位不够时,打散一部分标准单元腾出位置(placement refine)比往远处堆 decap 有效得多。
- decap 有漏电和 EM 代价。大面积 decap 在先进节点贡献的静态漏电不可忽略,且 decap 本身的电源 via 也吃 EM 预算,见 via pillar 与 EM/IR。迭代收敛的目标不是「压降越小越好」,而是「压降进判据且 decap 总量最小」。
多电压域与 DVFS 设计还要多一层工作量:每个电压状态(voltage/frequency 工作点)都是一个独立的分析场景。0.9 V 高频点的电流大但电压余量宽,0.65 V 低频点的压降百分比限值反而更紧——哪个工作点最坏并不显然,全部分析一遍才是稳妥做法。电平转换器(level shifter)和隔离单元所在的两域交界,是动态压降报告的常客,值得在热点图上单独标注检查。
六、signoff 判据与报告解读
动态 IR drop 的 signoff 判据一般长这样:
| 判据项 | 典型口径 | 说明 |
|---|---|---|
| 最大动态压降 | ≤ 电源的 5%–10%(按域) | 全芯片逐 instance 检查 |
| 有效电压下的时序影响 | 压降折算延迟增量 ≤ 时序余量 | 与 STA 联动的高级判据 |
| 激励覆盖 | VCD 场景清单 + vectorless 兜底 | 流程性判据 |
| 工艺角覆盖 | 快角(大电流)与慢角(低压)都跑 | 漏角等于没签 |
报告解读的三个经验:
- 热点图比数值表重要。数值表告诉你「最坏点差多少」,热点图告诉你「这片区域是不是系统性的」——成片的临界区比孤立的超标点危险得多,因为 PVT 漂移会把临界区推过线。
- 看波形不只看峰值。报告里的电压波形能区分「窄而深的坑」(decap 不足,局部 di/dt 问题)和「宽而浅的坑」(网格电阻问题,持续负载),两种坑的修复手段完全不同。还有一种「周期性涟漪」是封装电感与片上电容的谐振,频率落在时钟谐波附近时会被逐周期放大——这类坑要靠 decap 的容值搭配(大容量低频 + 小容量高频并联)来压,单一容值堆量无效。
- 和 EM 报告交叉看。动态压降热点往往也是电流密度热点,信号与电源 EM 差异 里的电源 EM 判据在同一区域多半也紧张,两个报告放一起看能一次修两类问题。
最后把流程纪律说死:动态 IR drop 分析必须在时序 signoff 之前收敛,因为它的结论是 STA 余量是否可信的前提;任何大规模 ECO(尤其时钟树改动、decap 增删)之后必须增量重跑,见 签核收敛 ECO 的迭代纪律。有条件的话,把「压降折算成延迟增量、回灌给 STA 重查关键路径」的高级联动跑一轮——很多团队签核只查压降限值,直到硅后才发现某条压线路径恰好躺在热点区中央,这种交集型风险只有联动分析抓得到。
这一篇在知识体系里的位置
- 同族:PGV 电源网格视图生成 讲电源网络的电气模型怎么建;APL 电流波形表征 讲电流库怎么来;via pillar 与 EM/IR 讲网格侧的加固手段。
- 数据依赖:翻转激励见 VCD/SAIF 活动率数据;可靠性交叉检查见 信号 EM 与电源 EM 差异。
- 下游:判据收口与时序联动见 S5 签核收敛 与 签核收敛 ECO;EM 判据的 library 侧输入见 Liberty EM 与 max toggle 表征。
总结
动态 IR 压降分析求解的是「时钟沿引发瞬态电流尖峰、在 R+L+C 电源网络上砸出电压坑、坑吃掉局部时序余量」这条因果链,与只管平均电流的静态分析互补;激励用 VCD 驱动验证真实场景、vectorless 全芯片兜底,精度分水岭在 APL 电流波形库(三角波近似峰值误差 30% 起);修复以贴热点插 decap 为主、网格加密和布局打散为辅,迭代目标是压降进判据且 decap 总量最小;signoff 要逐 instance 过压降限值、覆盖快慢工艺角,热点图看系统性、波形形状分坑型(窄深补 decap、宽浅补网格),且必须在时序 signoff 之前收敛——动态 IR 不收敛,STA 的余量数字就是建立在流沙上的。