FastSPICE 分块调优:精度分区档位、数模接口处理与速度精度取舍实战
一颗 SoC 级的全芯片 SPICE 仿真,晶体管几千万起步,用传统 SPICE 跑到天荒地老也出不了结果。FastSPICE 之所以能把时间压到可接受的范围,靠的不只是求解器快,更是「区别对待」——对关键路径用高精度慢慢算,对数字外围、存储阵列这类行为规整的模块用大刀阔斧的近似快速推过去。这就是 FastSPICE 分块调优 的主战场:把设计切成若干分区,逐块配置精度档位,让每一分仿真预算都花在刀刃上。SPICE 求解器原理讲过牛顿迭代与矩阵求解的底层开销,模拟版图寄生与后仿真讲过寄生抽取后网表规模为什么会爆炸;本篇聚焦仿真器这一侧:分区怎么划、接口怎么处理、速度精度的账怎么算。
本文要回答的问题
- FastSPICE 分块调优为什么是必要的,不分块一把梭会发生什么?
- 精度分区通常分几档,每一档背后仿真器实际放松了什么?
- 数字块和模拟块交界的接口节点,为什么要特殊处理、怎么处理?
- 速度与精度的取舍有没有可量化的验收判据,而不是「看着波形像就行」?
一、为什么必须分块:全芯片仿真的精度错位
不分块的后果很直接:要么整个设计用最高精度跑,仿真时间以周计;要么全局放松精度,关键模拟路径的增益、相位裕度、抖动全都不准,签核报告等于废纸。矛盾出在设计的「精度需求分布」极不均匀:
| 模块类型 | 精度需求 | 网表特征 | 全局同精度的浪费 |
|---|---|---|---|
| PLL / ADC / SerDes 模拟核 | 极高,决定签核成败 | 几千到几万器件 | 无,这是预算该花的地方 |
| 电源管理与偏置网络 | 高,直流工作点敏感 | 中等规模 | 低 |
| 数字标准单元逻辑 | 低,关心翻转时序不关心波形细节 | 百万级器件 | 极高,高精度纯属烧钱 |
| 存储阵列(SRAM 阵列体) | 阵列体可大幅近似,灵敏放大器除外 | 高度重复结构 | 高,重复结构可压缩 |
| ESD / 封装模型 | 看场景,常只需寄生级参与 | 无源为主 | 中 |
一颗典型 SoC 里,真正需要 SPICE 级精度的器件往往不到总数的 1%。分块调优要做的就是把这个不均匀性显式地告诉仿真器,而不是让它对每个 MOS 都一视同仁地做完整牛顿迭代。
二、精度分区档位:仿真器到底放松了什么
主流 FastSPICE 引擎(Spectre XPS、HSPICE Precision、CustomSim 等)都把精度组织成若干档位,名字各异,本质是按「放松了多少近似」排序。常见的三档划分如下:
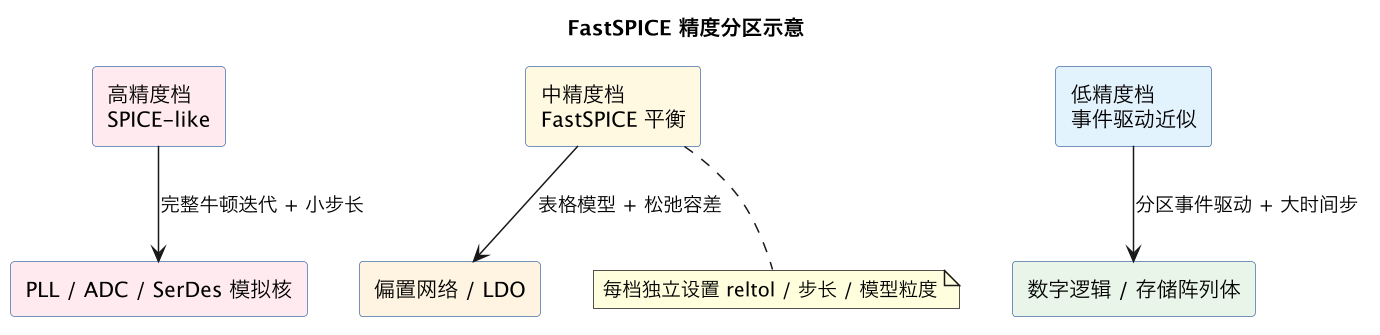
上图从上到下对应仿真器近似程度由浅到深。高精度档几乎退回到传统 SPICE:完整器件方程、牛顿迭代收敛到紧容差、自适应步长不偷懒,波形精度可对标 sign-off SPICE,代价是速度只有 FastSPICE 标称值的几分之一。中精度档开始做代表性近似:器件模型换成查表加插值(预先扫描 I-V/C-V 特性存表)、reltol 从 1e-4 量级放松到 1e-3、允许更大的局部截断误差。低精度档则把数字块按事件驱动方式推进——一个反相器链没有输入变化时根本不占计算量,时间步长由翻转事件而不是精度要求决定,速度可以比高精度档快两个数量级。
划档的实操原则是按签核责任划,不按层次图省事:同一个 IP 内部也可能拆档——PLL 的 VCO 和电荷泵放高精度档,分频器链放中档,数字控制状态机放低档。粒度过粗浪费预算,粒度过细则分区配置本身变成维护负担,经验值是全芯片 5 到 15 个精度分区为宜。
三、数模接口节点:分块的接缝最容易漏水
分区一切,必然产生跨精度档的接口节点,而仿真事故十有八九出在接缝上。问题有三类。
第一是精度污染不对称:高精度块看着低精度块推过来的输入波形——边沿被事件驱动粗化、电平被量化——算出来的结果再准也带上了输入误差。反过来低精度块接收高精度块的输出却常常无所谓。所以接口处理的核心是把高精度档的边界往外推一圈:把驱动高精度块输入的那一级驱动器(哪怕它在数字区)也拉进高精度档,这叫「包壳」(wrapper)处理。
第二是数模电气转换。数字区常用行为模型或简化驱动,模拟区要的是真实电压电流。接口处需要显式的 D2A/A2D 转换元件,并配置阈值、上升时间与负载。阈值设错(比如按 0.5×VDD 判定而实际模块按 0.3×VDD 翻转)会让时序偏差直接体现在仿真结果里,数模混合收敛里讲的接口收敛问题有一半根源在这里。
第三是电源网络的跨块耦合。数字块的大电流翻转会通过共享电源网络弹到模拟块,低精度档如果对电源波形也做了粗化,模拟块的电源抑制表现就会失真。对策是电源/地网络单独建分区,用不低于中档的精度参与仿真,哪怕挂在上面的数字负载是低精度档。
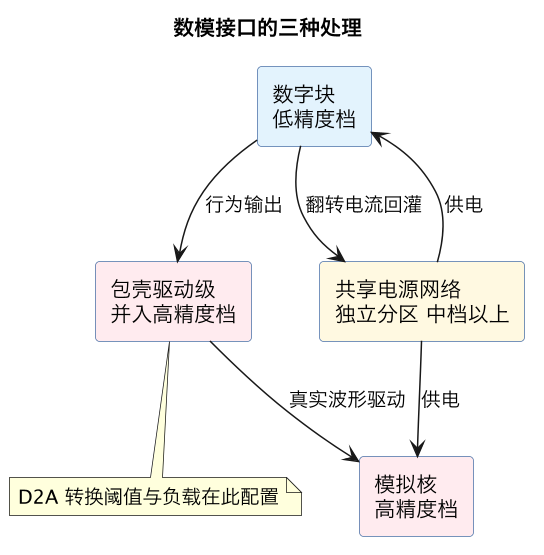
上图的关键是中间那层包壳:它把「数字近似」和「模拟精度」隔开,让接缝处的波形在高精度域内重建。漏掉包壳是新手配置分区时最常见的错误,症状是仿真结果对数字区的精度档位异常敏感——数字区档位一变,模拟指标跟着飘。
四、速度与精度取舍:怎么验收而不是怎么感觉
分块调优的验收必须量化,不能停在「波形看着差不多」。工程上通行的三步法是:
- 黄金参考对照:取一个有代表性的中小规模配置(关键块高精度、其余中档)作为黄金参考,跑一遍并记录关键指标——PLL 抖动、ADC 的 ENOB、建立时间、功耗电流。然后只改被调优分区的档位,对比同一组指标。常用门槛:关键模拟指标偏差小于 1%(抖动类可放宽到 3%),数字路径延迟偏差小于 5%。
- 灵敏度扫描:对每个低/中档分区单独升一档跑一次。如果升档后指标几乎不动,说明该块在当前档位已足够;如果指标明显变化,说明这个块被放松过头了。逐个扫一遍,得到一张「分区档位 → 指标敏感度」的表,这就是最终配置的凭据。
- 收敛性兜底:调优后的配置在多 corner(工艺、电压、温度,见 MMMC 与寄生 corner)下抽样复跑。某些 corner 下工作点移动会让原本「安全」的低档分区失准,抽样复跑是唯一兜底的手段,抽样比例按历史翻车经验取 10% 到 20%。
速度收益的预期也要现实:典型全芯片场景下,精细分块调优相对「全局中档」能再拿到 3 到 10 倍加速,相对「全局高精度」是几十倍。但每多加一个分区档位组合,回归维护和黄金参考更新的成本也在涨——分区配置本身要纳入版本管理,和设计数据一起走 交接契约,否则下次网表更新后没人知道哪条配置还成立。
这一篇在知识体系里的位置
- 求解器底层:SPICE 求解器原理 讲牛顿迭代与矩阵求解,本篇讲在求解器之上用分区调度精度预算;
- 数模上下文:AMS 混合信号收敛 与 混合语言协同仿真 讲数模接口的验证侧问题,本篇第三节从仿真精度侧呼应;
- 上下游:寄生源头的网表规模问题见 模拟版图寄生与后仿真,多 corner 复跑见 MMMC 与寄生 corner,配置版本治理见 X1 交接契约。
总结
FastSPICE 分块调优是把设计按签核责任切成 5 到 15 个精度分区、逐块配置精度档位,让 SPICE 级精度只落在不到 1% 的关键模拟器件上;划档时记住三条:接口接缝用包壳驱动级把高精度边界外推一圈、共享电源网络独立分区且不低于中档、验收用黄金参考加灵敏度扫描加 corner 抽样的量化三步法——速度收益来自「区别对待」,而区别对待的每一条配置都要像设计数据一样版本化,否则下次网表一更新,省下来的仿真时间会加倍还回去。