全局布线拥塞:拥塞图解读、overflow 指标与布局层联合优化
更新时间:2026-10-02。物理实现里有一个让人又爱又恨的环节:布局刚跑完,时序看着还行,工具却丢出一张红得发紫的拥塞图,告诉你这块区域「理论上布不通」。全局布线拥塞(global routing congestion)是整个 place and route 流程里最早、最便宜的可布性体检——它发生在详细布线之前,用的是粗粒度网格上的供需估算,几分钟就能给出答案,而详细布线跑一晚上才知道的结果,往往和它对得上八九成。本站 布线拥塞、DRC 与串扰的三角关系 讲过拥塞在签核侧的连锁后果,布局拥塞与 cell padding 讲过布局侧的常规武器。这一篇把镜头对准中间那个环节:全局布线器本身在算什么、它吐出来的拥塞图和 overflow 数字到底怎么读、以及发现拥塞之后怎么回溯到布局层做联合优化,而不是对着一张红图干瞪眼。
本文要回答的问题
- 全局布线为什么要把芯片切成 G-cell 网格,供需模型里「供给」和「需求」各是什么?
- 拥塞图上红的、黄的、绿的区域分别意味着什么,overflow 这个数怎么算出来的?
- 为什么全局布线说「能布通」详细布线却布不通,两者的精度差距来自哪里?
- 常见的拥塞热点(macro 海峡、高 fanout 网络、标准单元密集区)各有什么形态特征?
- 发现全局布线拥塞之后,回到布局层能做哪些联合优化,各自代价多大?
一、G-cell 网格:全局布线的世界观
详细布线面对的是真实的金属轨道、via 规则和千万级网段,计算量决定了它只能串行迭代、一晚跑一轮。全局布线(global routing,GR)的作用是提前回答一个粗问题:这块区域的走线需求,超没超过这块区域的走线供给?为了把这个问题变得可算,工具把整颗芯片切成一个规则的网格,每个格子叫 G-cell(global routing cell),边长通常是若干条金属轨道间距,一颗百万实例的设计切完大约是几百乘几百个格子。
网格切好之后,每个 G-cell 的每条边都关联两个数。供给(supply):这条边跨越的可用走线轨道数——水平边看水平层(M2、M4……)的轨道,垂直边看垂直层(M1、M3……)的轨道,再减去被 macro 阻挡、电源网格占用、keep-out 区域吃掉的部分。需求(demand):所有跨过这条边的网线估算要占用的轨道数。全局布线器用 Steiner 树近似和拆线算法(典型的是 maze routing 的网格版)把每条网分配到 G-cell 边的序列上,需求就沿边累加起来。
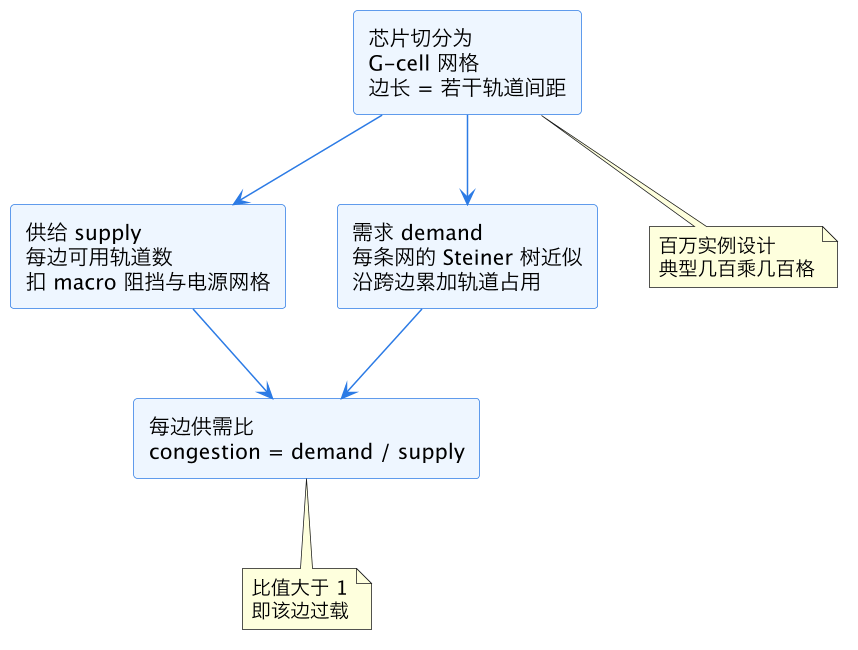
这张图是全局布线的全部世界观:网格化之后,布线问题从「连续平面上的几何问题」退化成「图上的流量分配问题」,每条 G-cell 边是一个有容量约束的弧,每条网是一个要在弧上找路的流。理解这一点,后面所有指标的定义就都是顺理成章的算术了。
有一个细节值得记住:供给不是常数。同一颗芯片里,macro 密集区边缘的 G-cell 边供给会被阻挡砍掉一大半,电源网格(power mesh)打的 strap 和 via 阵列也会成排吃掉高层轨道。所以两块需求相同的区域,供给不同,拥塞程度可以天差地别——只看需求不看供给,是读拥塞图时最常见的误判。
需求侧的估算也有一个常考题:全局布线给每条网画的是 Steiner 树近似,不是真实走线。短网的估算相当准,长网则常常低估——真实详细布线为了绕开局部障碍和满足时序,走线长度超过 Steiner 树百分之二三十并不罕见。这个系统性低估意味着需求数字本身偏乐观,它和后面要讲的 via、DRC 折扣叠加在一起,共同决定了全局布线结果只能当否决票用。
二、拥塞图与 overflow:两个数字的读法
全局布线跑完,工具给出的核心产物是一张染色的拥塞图(congestion map)和一组汇总指标。染色规则通常是:某条 G-cell 边的需求除以供给,小于等于某个阈值(常见 0.8 或 0.9)染绿,接近 1 染黄,超过 1 染红——红色边的含义是「按当前网表分配,这条边上的轨道不够用,详细布线必须绕」。
overflow 是把红色边量化后的总账,定义是所有过载边的「需求减供给」之和,即一共多占了多少条不存在的轨道。报告里通常会拆成水平 overflow 和垂直 overflow 两个数,因为两个方向的供给来自不同金属层,瓶颈方向往往不对称。经验水位是:overflow 为 0 且几乎没有深红边,可布性良好;overflow 占全芯片总需求千分之几以内,详细布线器靠 rip-up and reroute 大概率能消化;overflow 冲到百分之一以上,或者出现成片的深红区,基本可以断定详细布线会大面积违规,必须回头改。
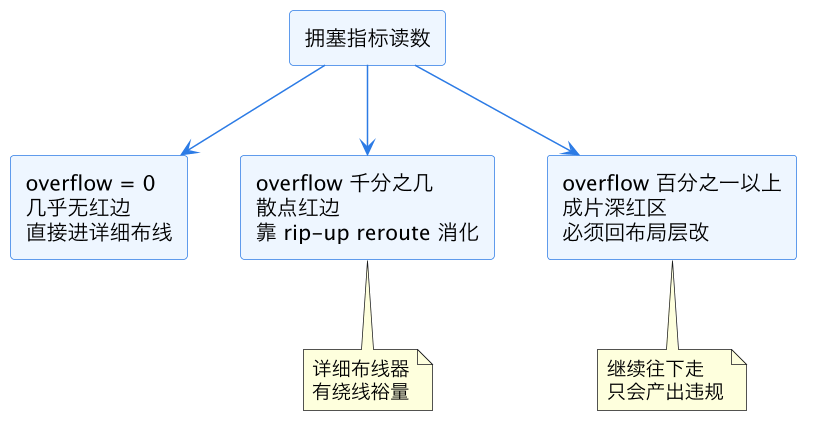
这张判读图给的是工程水位线,但要注意两个陷阱。第一,overflow 是个总和指标,它会掩盖分布——同样 5000 条轨道欠账,均匀撒在五百条边上和集中在十条边上完全是两种病:前者详细布线能绕开,后者是一条布不通的「海峡」。所以 overflow 必须配合拥塞图的空间分布一起看。第二,很多工具报拥塞时按 G-cell 染色是取该格四边最差值,看到红点先点开看是水平边红了还是垂直边红了,方向信息直接指向后面的修法——水平红往往要加横向绕行资源或降密度,垂直红常常是 macro 海峡问题。
三、全局与详细的差距:为什么「能布通」会骗人
把全局布线当成详细布线的精确预言是危险的,两者之间有几个系统性差距。
第一,全局布线假设每条网只占整数条轨道,不考虑 via。真实设计里一次换层就是一颗 via,via 在先进工艺下层往往占不止一条轨道的等效资源,叠 via、fat via、via pillar 的占用更大。全局布线对这些只有一个统计性的 via 折算系数,低估是常态。
第二,全局布线不检查 DRC。间距规则、最小面积规则、eol(end-of-line)规则这些几何约束会让详细布线器在局部不得不绕行,消耗比全局估算更多的资源。先进工艺下相邻轨道还有颜色约束(double patterning),等效于供给再打折扣。
第三,全局布线的网分配是独立贪心加协商迭代的,它找的是「流量上可行」的解,不保证「时序上可接受」的解。详细布线要为时序关键网预留低层短线资源,这会把普通网进一步挤向本已紧张的边。
所以工程上的心法是:全局布线的 overflow 是一个下界——它说有问题,详细布线几乎一定有问题;它说没问题,详细布线仍可能有局部问题。这个「单向可信」的性质决定了它在流程里的用法:当否决票用,不当通行证用。签核侧的更完整视角见 布线拥塞、DRC 与串扰的三角关系。
四、三种典型热点形态:看图识病
读拥塞图最值钱的技能是从红区的形状反推病因。三种形态出现频率最高。
macro 海峡型。两块或几块存储器 macro 之间留了一条几十微米宽的通道,所有跨区信号都得从这条海峡里过。图上表现为一条笔直的深红带,方向与海峡走向垂直,水平垂直溢出通常只在一个方向上爆表。病根在 floorplan,不在单元密度。
高扇出网络型。时钟使能、scan enable、reset 这类扇出几千的控制网,在全局布线里会占据大量轨道。如果逻辑综合或布局没有把这类网的负载就近聚簇,图上会呈现以某个源点为中心向外辐射的红色放射纹。病根在网表结构和布局聚簇。
密度墙型。标准单元摆放利用率冲到 90% 以上的区域,单元之间的走线通道被逻辑本身占满,局部需求暴涨。图上是一片边界模糊的红区,和时序热点高度重合——时序优化器为了修 setup 在这个区域插了大量缓冲器和高驱动单元,进一步加剧了密度。病根是时序与可布性抢同一块地盘。
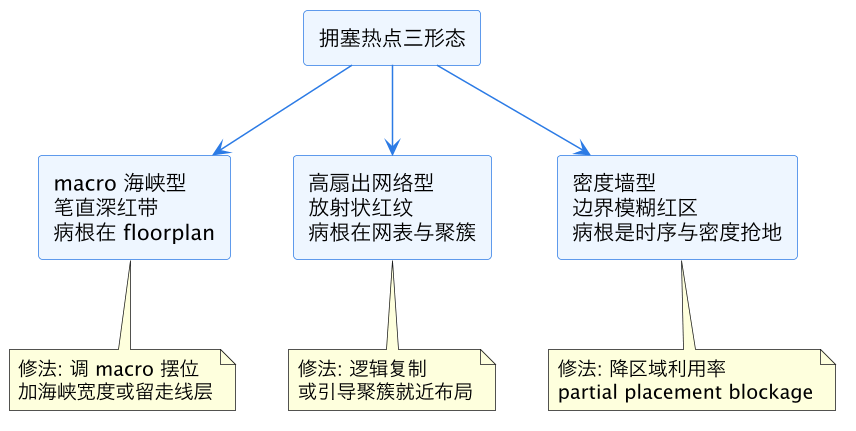
这张鉴别图建议当成晨会读图的第一张幻灯片用:先看形态归哪类,再开对应的药方。形态判断错了,比如把 macro 海峡型当成密度问题去撒 partial blockage,红色只会搬家不会消失。密度类的更多手法见 布局拥塞与 cell padding 和 filler cell 与密度规则。
五、回溯布局层:联合优化的五件武器
全局布线拥塞是布局问题的症状,根治要回到布局层(placement)甚至 floorplan 层。按代价从低到高,常用的五件武器如下。
| 手段 | 作用层 | 原理 | 典型代价 |
|---|---|---|---|
| 拥塞驱动布局重跑 | placement | 布局器按 GR 反馈迭代疏散热点 | 时序 QoR 可能回退几个点 |
| cell padding | placement | 给高 pin 密度单元加间距标签,等效降局部密度 | 面积增加 1%-3% |
| partial placement blockage | placement | 限制红区可放单元数,强制疏散 | 周边区域变挤 |
| 引导聚簇 / 逻辑复制 | 综合与布局 | 高扇出网负载就近聚簇或复制源头 | 网表变更,需重新等价验证 |
| macro 海峡加宽 / 摆位调整 | floorplan | 直接增加海峡区供给 | floorplan 冻结被打破,代价最高 |
上表的读法是:从前往下代价递增、动用的流程层级递增。工程纪律是能用便宜的解决就不动贵的——cell padding 和 partial blockage 能在布局阶段内消化的问题,不要推给 floorplan。反过来,判断为 macro 海峡型的拥塞,也不要指望 padding 能救命,趁早回去改摆位,floorplan 与电源规划的关系见 Floorplan 与电源规划,macro 海峡的供电通道往往和走线通道是同一个空间,两者要一起算。
还有一个容易被忽视的方向:轨道供给本身也是可以谈的。标准单元行高决定了底层轨道数,标准单元 track 高度选型 讲过 7.5T、9T 库之间轨道密度与性能的交换——可布性差的设计选轨道数多的库(如 12T 换 9T),等于全局性提高供给,代价是面积。这是库选型阶段就埋下伏笔的联合优化。
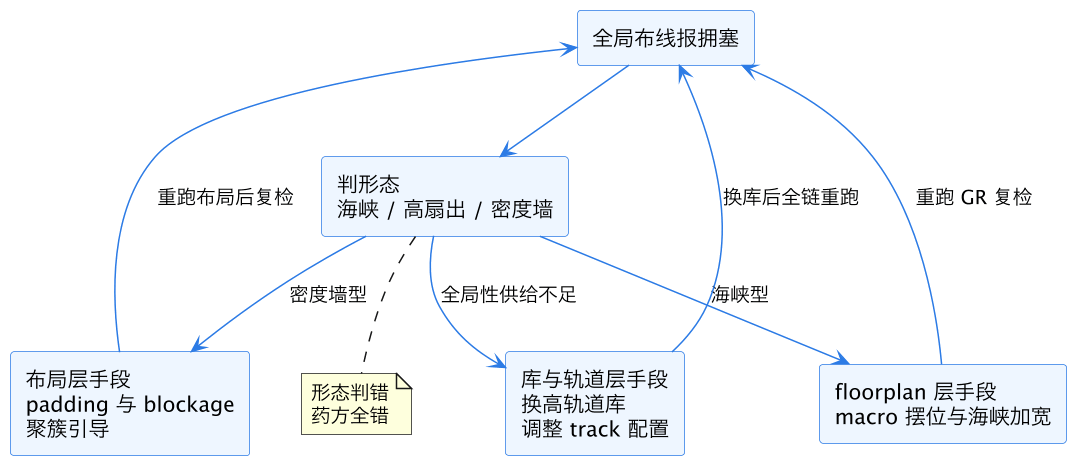
这张决策图是全篇方法学的落点:拥塞只是入口,判形态是岔路口,三条出路分别通向布局、floorplan 和库选型三个层级,每条路的终点都回到「重跑全局布线复检」——拥塞优化永远是迭代闭环,不是一次性的修补。整个数据流在 数据流之 floorplan 与布局阶段 和 数据流之 CTS 与布线阶段 两阶段之间来回,时序收敛侧的 ECO 互动则见 PR 时序收敛 ECO。
这一篇在知识体系里的位置
本篇是 eda/ 目录下物理实现线的一篇标准深讲,向上承接 数据流之 floorplan 与布局阶段 的流程叙事,横向与拥塞的签核后果(布线拥塞、DRC 与串扰的三角关系)、布局侧武器(布局拥塞与 cell padding、filler cell 与密度规则)、floorplan 结构(Floorplan 与电源规划、标准单元 track 高度选型)互相印证;向下接布线阶段数据流(数据流之 CTS 与布线阶段)与时序收敛闭环(PR 时序收敛 ECO、signoff closure ECO)。ECO 期间空位利用的配套策略见 ECO spare cell 摆放策略。
总结
全局布线拥塞是芯片可布性的早期否决票:工具把芯片切成 G-cell 网格,对每条边算「供给(可用轨道)对需求(跨边走线)」的账,过载边的欠账总和就是 overflow,拥塞图则给出欠账的空间分布;读图的功夫在于从深红带、放射纹、模糊红区三种形态反推 macro 海峡、高扇出网络、密度墙三类病根,再按代价从低到高回溯到布局层的 padding 与 blockage、floorplan 的 macro 摆位、乃至库选型的轨道配置做联合优化,每改一轮都回到全局布线复检,直到 overflow 收敛到详细布线器能消化的水位。