FPGA Device DNA 与 eFUSE:芯片唯一序列号、OTP 用户区与授权绑定
同一份比特流烧到一百块板子上,FPGA 上电后跑出来的逻辑完全一样——这既是 FPGA 的好处,也是量产产品的心病:你没法从逻辑内部回答「我现在跑在哪一颗芯片上」。好在芯片出厂时带了两样东西:每颗不同、只读不写的 Device DNA,以及一次性烧断的 eFUSE 用户区。本篇讲清这两个硬件唯一标识原语怎么读、能存什么、防不住什么。
本篇只讲「芯片身份与一次性存储」这一层。比特流加密、AES 密钥存放的完整体系见 FPGA 比特流加密,更高阶的威胁建模与密钥运营在专家层 FPGA 安全:比特流加密、认证与安全启动;文中涉及 JTAG 链和 IDCODE 的背景见 FPGA JTAG 链概念。
本文要回答的问题
- 同样的比特流跑在不同板子上,设计里怎么知道「我是哪一颗芯片」?没有这个能力时,防抄板和设备授权会卡在哪个环节?
- Device DNA 存在芯片哪里、多长、能不能改写?DNA_PORT 原语的移位读出节拍是怎样的,Verilog 里如何实例化?
- eFUSE 用户区和 Device DNA 有什么不同?烧一次就不能反悔的东西适合存什么、不适合存什么?
- 为什么说 DNA 不是秘密?把 DNA 读出来和预设值明文比对,为什么挡不住有准备的攻击者,正确的绑定姿势是什么?
- 下载器能自动识别链上器件型号,靠的也是 IDCODE,它和 Device DNA 是一回事吗?
一、假如没有 FPGA Device DNA 与 eFUSE:克隆一块板为什么零成本
先看不做芯片身份校验时会怎样。SRAM FPGA 每次上电都从板载 Flash 重新加载比特流,比特流本身不含任何「芯片个体」信息——同型号的一百颗芯片,加载同一份文件后内部结构逐位相同。于是产品一量产,几类麻烦同时出现:
| 场景 | 没有硬件身份时的做法 | 后果 |
|---|---|---|
| 防抄板 | 只靠比特流保密 | 拆下 Flash 复制内容即可整板克隆,逻辑不需要被理解 |
| 设备授权 | 授权文件存在 Flash/EEPROM | 授权文件随 Flash 一起被复制,或被擦写绕过 |
| 序列号台账 | 标签纸、外置 EEPROM 写号 | 标签可换、外置芯片可重写,产线和售后对不上 |
| 差异化数据 | 每台设备发一份固件 | 固件版本爆炸,管理成本随出货量线性增长 |
问题的根子是:这些方案里没有一样东西是「芯片出厂焊死、攻击者改不动也复制不出第二份」的。标签能撕、Flash 能抄、EEPROM 能写,唯独硅片制造时刻进去的标识搬不走。这正是 FPGA Device DNA 与 eFUSE 这类片上标识的设计动机——把「身份」做进硅里,而不是做进可拆换的外围器件。
需要先分清的是,芯片里带「身份」意味的东西其实有三种,能力差别很大,封面先给一张总览。
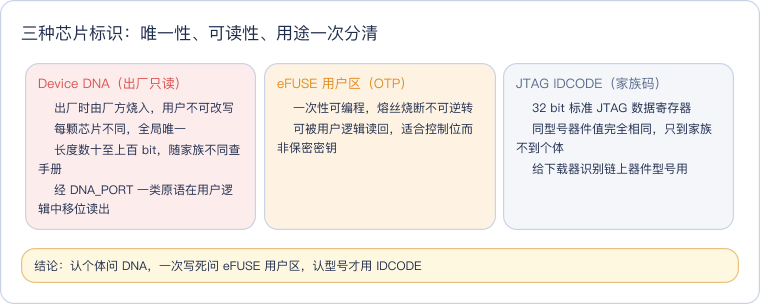
读这张卡抓住一条主线:唯一性和可读性是两个正交的维度。DNA 唯一但只读,适合回答「我是谁」;eFUSE 用户区能由用户写一次,适合存放「这颗芯片被配置成什么状态」;IDCODE 连唯一性都没有,只是型号铭牌。下面先把 DNA 看透。
二、Device DNA:出厂烧入的芯片序列号与 DNA_PORT 读取
Device DNA 是芯片在制造测试阶段写入专用存储单元的一串二进制编号。它有三个性质必须先记住:
- 出厂烧入、只读:用户设计没有任何合法接口可以改写它。它不在 BRAM、不在配置寄存器里,而是独立的片上单元,重新烧比特流、换 Flash、断电都不影响。
- 每颗不同:编号在制造时保证区分,同型号、同卷盘、同生产日期的两颗芯片 DNA 也不同。
- 长度随家族不同:从几十位到上百位的家族都有,不要在代码里假设固定位宽,以对应家族的原语模板(Language Template)和库指南为准。
用户逻辑读 DNA 的标准入口是一个专用原语:7 系列里叫 DNA_PORT,更新的家族命名为 DNA_PORTE2 等(端口也略有增减)。以概念模型看,它对外就是四个信号:CLK 拍动读取动作,READ 拉高一个周期把 DNA 并行装入内部移位寄存器,SHIFT 为高时每个时钟把寄存器向 DOUT 挪一位,数据从最低位开始串行吐出;另有 DIN 用于多片级联拼接的场景。整个过程是一次「并行装入、逐位移出」。
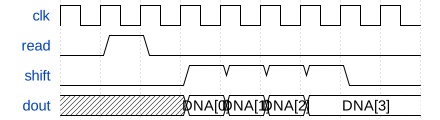
读这张节拍图:第一个高电平发生在 read 上,它像一次「装载」命令,内部移位寄存器在此拍获得整串 DNA;之后 shift 拉高,每个时钟上升沿把移位寄存器向右推一位,dout 依次送出 DNA[0]、DNA[1]……直到取满该家族的全部位宽。这是一张概念示意,实际的建立/保持要求、首个数据位相对装载拍的位置以原语手册为准,工程上的稳妥做法是在 shift 拉高后的每个时钟沿采样 dout 并拼进寄存器。
下面是一段概念性的 Verilog 读取逻辑,用一个小状态机完成「复位 → 装载 → 移位 → 完成」:
module dna_reader (
    input  wire        clk,
    input  wire        rst_n,
    output reg [63:0]  dna_value,   // 位宽按家族改,勿照抄
    output reg         dna_valid
);
    // 概念示例:以 7 系列 DNA_PORT 端口命名;
    // 实际位宽、SIM_DNA_VALUE 与原语名以 Vivado 语言模板为准。
    localparam integer DNA_WIDTH = 64;

    reg [2:0] state;
    reg       read;
    reg       shift;
    wire      dout;
    integer   bit_cnt;

    localparam S_IDLE  = 3'd0,
               S_LOAD  = 3'd1,
               S_SHIFT = 3'd2,
               S_DONE  = 3'd3;

    DNA_PORT #(
        .SIM_DNA_VALUE(64'h0000_0000_0000_0000)  // 仅仿真时出现的值
    ) u_dna_port (
        .DOUT (dout),
        .READ (read),
        .CLK  (clk),
        .SHIFT(shift)
    );

    always @(posedge clk or negedge rst_n) begin
        if (!rst_n) begin
            state     <= S_IDLE;
            read      <= 1'b0;
            shift     <= 1'b0;
            bit_cnt   <= 0;
            dna_value <= 64'd0;
            dna_valid <= 1'b0;
        end else begin
            read  <= 1'b0;
            shift <= 1'b0;
            case (state)
                S_IDLE: begin
                    bit_cnt <= 0;
                    state   <= S_LOAD;
                end
                S_LOAD: begin
                    read  <= 1'b1;          // 一拍装载
                    state <= S_SHIFT;
                end
                S_SHIFT: begin
                    shift                 <= 1'b1;
                    dna_value[bit_cnt]    <= dout;   // 低位先出
                    if (bit_cnt == DNA_WIDTH - 1)
                        state <= S_DONE;
                    else
                        bit_cnt <= bit_cnt + 1;
                end
                S_DONE: begin
                    dna_valid <= 1'b1;      // dna_value 此后稳定
                end
            endcase
        end
    end
endmodule
这段代码里有三处不要照抄:位宽按家族手册改、原语名按家族换(如 DNA_PORTE2 的端口列表不完全相同)、SIM_DNA_VALUE 只在仿真中生效,上板后读到的永远是真编号。综合后它只消耗几个触发器和一个专用原语,不占 BRAM,可以在启动阶段跑一次、把结果锁存供后续逻辑使用。
几个实操要点:读取只需要在配置完成、逻辑复位释放后做一次,DNA 不会变化,没必要周期重读;驱动 CLK 的时钟频率上限随家族不同(多数家族可以直接用几十 MHz 的系统时钟,但仍以手册的原语参数页为准);除了用户逻辑原语这条路,下载器工具链通常也能直接读出 DNA 显示在器件属性里,产线夹具不写一行 RTL 也能登记编号。若设计里还要把 DNA 经 UART、PCIe 上报给上位机,建议在 dna_valid 拉起后只上报一次并做同步处理,避免把移位过程中的中间值发出去。
三、eFUSE 用户区:一次性烧断的存储
eFUSE(electronic fuse,电子熔丝)是另一类片上存储:每个比特对应一小段熔丝链路,未烧为一种状态,用专用编程流程通以大电流烧断后变成另一种状态,物理过程不可逆——没有「再烧回去」这回事。
FPGA 里的 eFUSE 必须区分两类区域,它们的安全语义完全不同,混为一谈会做出错误的方案:
| 区域 | 谁来写 | 能否读回 | 适合放什么 |
|---|---|---|---|
| 密钥/控制专用行 | 产线编程流程 | 用户接口不可读出,仅供片上加解密引擎内部使用 | AES 密钥、关闭 JTAG 等安全控制位 |
eFUSE 用户区(如 UltraScale 起的 EFUSE_USR 一类原语访问) | 用户产线烧写一次 | 用户逻辑可经原语/JTAG 读回 | 授权标志、特性开关、产线编号与批号、绑定辅助位 |
关键结论:用户区 eFUSE 不是保密存储。它的特点是「改不掉」而不是「读不到」——授权标志位烧在里面,攻击者无法把 0 烧成 1 来解锁功能,但他完全可以读到这个值。真正需要保密的密钥只能进专用密钥行,由片上硬件在加密引擎内部取用,外部没有读出通路;这一层和 BBRAM(电池备份 RAM,可改写但靠电池保持)的完整取舍在 配合 FPGA Device DNA 与 eFUSE 的密钥体系里展开。
工程上使用用户区 eFUSE 有几个纪律:烧写通常安排在产线测试之后、出货之前的末段工序,烧录工位要记录「哪颗 DNA 烧了什么值」形成台账;烧写前想清楚能不能撤销——答案是不能,所以产品上量前先在小批量上验证;位资源很少(远小于 BRAM),只存控制位和短编号,别拿它当存储器用。
家族沿革只做定性了解:较新的家族(UltraScale 起及以后)扩展了 eFUSE 的行数与安全控制位,并提供 EFUSE_USR 等用户区访问原语、USER_ACCESS 一类可经 JTAG 写入的用户数据寄存器;不同家族在原语命名、行组织、烧写工具入口上差异不小,移植设计时以目标家族文档为准,不要把旧家族的地址和流程直接套过去。
四、三个典型用途:防抄板、授权序列号、根信任辅助
硬件唯一标识落到产品里,常见三种用法,强度和成本依次递增。
防抄板绑定是最直接的诉求:让加密后的镜像「只认这一颗芯片」。产线读出每颗芯片的 DNA,用主密钥对 DNA 派生设备唯一密钥或生成绑定凭据,随板保存一份;设备上电后,片内逻辑完成一次校验才放行核心功能。这样复制 Flash 得到的密文和凭据换一颗芯片就对不上,克隆者还得解决密钥问题,而不是单纯复制文件。
授权与序列号管理更常见于分档销售的产品:同一个比特流,出厂时按订单开启不同功能档。DNA 就是天然的设备序列号,授权服务器记录「这串 DNA 买了哪些特性」,产线把授权标志烧进 eFUSE 用户区或下发绑定凭据;标定数据、MAC 地址这类每台不同的数据也可以按 DNA 索引。售后换机时读一下 DNA 就能在台账里查到整颗芯片的出生记录。
根信任辅助是高安全产品的用法:DNA 作为设备身份进入安全启动链,配合比特流加密、签名认证形成完整信任根。这一层的威胁建模超出本文范围,专家层 安全篇中 FPGA Device DNA 与 eFUSE 的密钥运营有完整展开。
下面这张图给出「设备授权」最常用的挑战应答链路,也是下一节安全边界讨论的靶子:
图中颜色对应角色:蓝色是片内读取动作,灰色是外部输入的挑战,橙色是密码学计算,红色是判定与拒绝分支,绿色是放行。流程里最要紧的是中间那拍 nonce——它正是下一节的分水岭。
五、安全边界:DNA 被抄录后,明文比对为什么形同虚设
很多设计第一次用 DNA 都会写出这样的逻辑:上电读出 DNA,和常量 64'h1234... 比较,相等就开功能。这种明文比对看起来做了绑定,实际有三个洞:
| 攻击方式 | 明文比对为什么挡不住 |
|---|---|
| 抄录 DNA | DNA 不是秘密:JTAG 可读、逻辑里也能读,知道合法芯片的 DNA 值只需要接触一块真板 |
| 重放 | 比对逻辑只认「相等」,攻击者录制一次合法设备的上电交互即可重放 |
| 改判断 | 如果比特流未加密,直接把「相等才跳转」改成无条件跳转;软核固件里的比较更容易改 |
根本原因是:DNA 是公开标识符,不是密钥,它的角色相当于网卡 MAC 地址或 CPU 序列号——可以被任何人读到。安全不能建立在「别人不知道我的 DNA」上,必须建立在「别人算不出正确应答」上,也就是上一节图里的挑战应答:
- 校验方每次生成一个不可预测的随机数
nonce; - 片内用比特流内置的密钥对
DNA + nonce做 HMAC 一类计算; - 校验方用同一密钥核对应答。由于 nonce 每次不同,录下来的旧应答无法重放;攻击者即使知道 DNA,没有内置密钥也算不出应答。
还要认清这套机制的剩余边界,避免过度承诺:密钥跟着比特流走,所以挑战应答必须与比特流加密叠加才有意义——未加密的比特流里没有秘密可言,密钥会被直接看到;攻击者若能整体搬走原芯片焊到自己的 PCB 上,DNA 绑定也拦不住(它防的是复制,不是转移硬件);对安全性要求更高的场景,应进一步采用设备唯一密钥(由主密钥和 DNA 在产线派生、密文只对该芯片可解),把单台设备被攻破的影响限制在单台之内。一句话:DNA 抬高的是克隆的成本和门槛,它本身不是保险箱,保险箱是它旁边的密钥体系。
六、Device DNA 与 JTAG IDCODE 的区别
初学者常把 DNA 和 IDCODE 混为一谈,因为在 Hardware Manager 里两者都能看到。它们其实完全不同:IDCODE 是 IEEE 1149.1 标准规定的 32 位 JTAG 数据寄存器,编码厂商标识、器件型号和版本号,同型号的每一颗芯片值都相同;它的用途是让下载器扫描 TAP 链时自动报出「链上有谁家的什么器件」,解决的是链路寻址问题,而不是个体识别问题。IDCODE 在 TAP 状态机里的位置可以复习 FPGA JTAG 链概念。
| 维度 | Device DNA | JTAG IDCODE |
|---|---|---|
| 粒度 | 每颗芯片唯一 | 同型号相同,只到家族/版本 |
| 位宽 | 数十至上百 bit,随家族 | 固定 32 bit(标准格式) |
| 写入者 | 出厂烧入,不可改 | 芯片设计时固化,不可改 |
| 读取路径 | DNA_PORT 一类原语进用户逻辑 | 标准 JTAG 指令,下载器自动读 |
| 典型用途 | 设备身份、授权绑定 | 链上器件识别与选型校验 |
一个实用的连带区别:IDCODE 可以被工具用来防止「比特流烧错型号」,但它完全不能用来区分两块同型号单板——要认板,只能认 DNA。产线夹具常见的组合是先看 IDCODE 确认型号和链路,再读 DNA 登记个体身份,各司其职。
这一篇在知识体系里的位置
- 上游:FPGA JTAG 链概念给出了 IDCODE、TAP 链的机制背景,是理解「型号识别」一侧的前置;FPGA 入门 32:比特流下载与固化是比特流与 Flash 的操作背景。
- 平级:FPGA 比特流加密与本篇互为表里——本篇讲硬件唯一标识与一次性存储原语,密钥篇讲 AES/HMAC 与 BBRAM、密钥行 eFUSE;授权绑定方案必须两篇一起看。
- 下游:专家层 FPGA 安全:比特流加密、认证与安全启动把 DNA 绑定放进完整威胁模型(克隆、重放、降级、JTAG 攻击面)与密钥运营体系;专题 04:FPGA 量产流程覆盖产线烧录工序与序列号台账,eFUSE 末段烧写纪律在那里落地。
总结
Device DNA 是出厂烧入、只读、每颗唯一的芯片序列号,经 DNA_PORT 一类原语以「READ 一拍装载、SHIFT 逐拍移出、DOUT 低位先出」的方式读进用户逻辑,位宽随家族不同必须查手册;eFUSE 用户区是一次性烧断、可读回但不可逆的存储,适合授权标志、产线批号等控制位,不适合放保密密钥——密钥只能进不可读出的专用密钥行或 BBRAM。工程上记住三句话:DNA 是身份不是秘密,明文 DNA 比对会被抄录、重放和改判断攻破,正确姿势是叠加比特流加密的挑战应答/HMAC 绑定;DNA 防的是低成本复制,不防搬走原芯片,更高安全等级要用主密钥派生的设备唯一密钥;IDCODE 只是同型号相同的 JTAG 型号铭牌,认个体只能靠 DNA。