连续批处理:iteration-level 调度器如何让长短请求混排不占坑
更新时间:2026-09-29。在 PagedAttention 与 vLLM 推理服务 里我们讲过 KV cache 怎么用分页方式省显存,在 KV cache 与推理显存 里算过一条请求要吃多少字节的 KV。但显存省下来之后,还有一个更上层的问题:这些请求什么时候进 batch、什么时候出 batch。传统 static batching 让整批请求同生同死,短请求被迫等长请求,GPU 一半时间在陪跑。这一篇讲 vLLM/Orca 一脉的连续批处理(continuous batching)调度器:以「迭代」为粒度重组 batch,把利用率从 30% 拉到 80% 以上。
本文要回答的问题
- static batching 的气泡到底浪费在哪,数字有多大?
- iteration-level scheduling 每一轮循环具体做哪几件事?
- 新请求什么时候能被「塞」进正在跑的 batch,准入受什么约束?
- KV 显存不够时,抢占(preemption)的换出(swap)和重算(recompute)两条路怎么选?
- chunked prefill 为什么能同时压住首 token 延迟和提升吞吐?
一、static batching 的气泡从哪来
先看传统做法。static batching(也叫 request-level batching)的逻辑是:攒一批请求,一起送进模型,跑到整批都生成结束才放下一批进来。问题在于 LLM 生成的输出长度天差地别——一句「你好」的回复可能 20 个 token,一篇长摘要可能 800 个 token。整批必须等最长的那条跑完,短请求对应的序列槽位在剩下的时间里只是在反复生成 padding 或者空转。
上图里四条请求同批启动,A 第 20 步就结束了,但它的槽位要一直陪跑到第 300 步。这批里有效 token 占比是 (20+300+80+150)/(4×300) ≈ 46%,一半以上的 decode 算力在陪跑。真实流量长度分布更散(常见是长尾),Orca 论文报告的 static batching 有效利用率常常只有 20%~40%。
更要命的是延迟:新请求 E 明明 GPU 有空闲槽位,也必须等当前批整体结束才能进来,排队延迟被「批内最长请求」绑架。
有人试过补救:等批内某条结束时临时补一条进去。这在框架层面几乎做不动——static batching 的实现里 batch 维度在 CUDA kernel 启动时就固定了,KV cache 也是按整批最大长度一次性分配的,中途换成员意味着整个 batch 的张量重排。要补位,就得把调度粒度本身改掉,这正是下一节连续批处理干的事。
二、iteration-level scheduling:每一步都是调度点
连续批处理把调度粒度从「请求」降到「迭代」(iteration,即一次前向传播生成一个 token 的步骤)。每跑完一步,调度器重新看一遍全场:谁的 token 吐完了,移出;队列里谁在等,有空位就塞进来;然后带着新拼好的 batch 跑下一步。已完成的请求立即释放槽位和 KV 块,新请求立即补位——没有陪跑,没有等待整批结束。
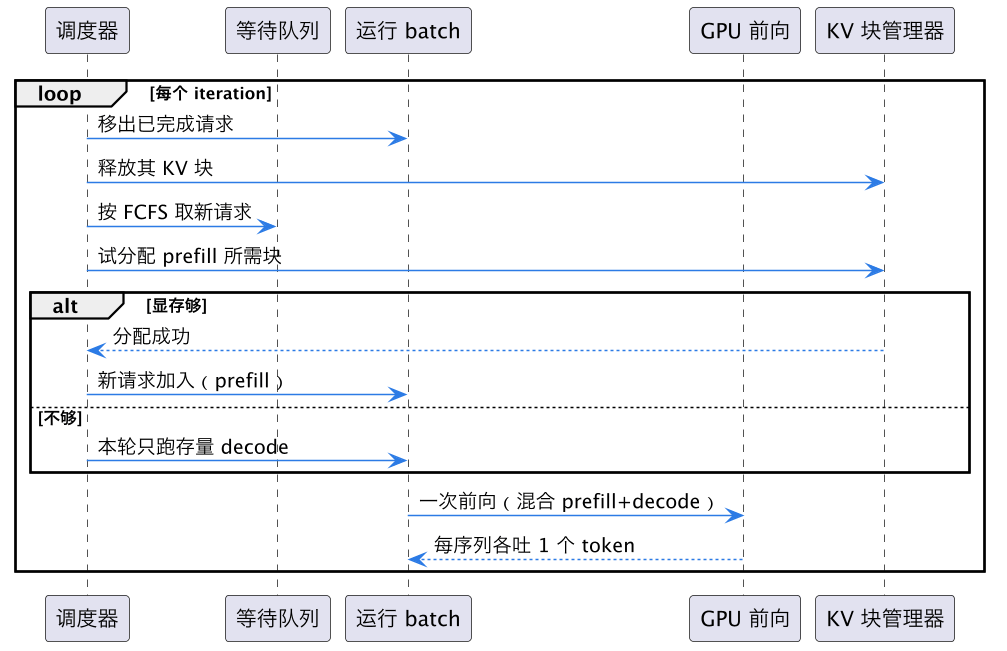
这张时序图就是调度器的主循环。每轮固定五个动作:完成检测 → 块释放 → 队列取新 → 准入试分配 → 拼 batch 前向。注意新请求进 batch 时走的是 prefill(一次性算完整个 prompt 的 KV),老请求走 decode(只算最新一个 token),两者在同一次前向里混跑——这就是「iteration-level」的精髓:batch 成员每一步都在变。
vLLM 里这个循环对应 LLMEngine.step():_schedule() 排出本轮要跑的 SequenceGroup 列表,worker 执行前向,sampler 出 token,再回环。单步耗时通常 30~80ms(取决于 batch 大小和模型规模),调度开销在毫秒级以下,相对前向可以忽略。
和 static batching 对比着看,收益来源有三块。第一块是消除批内气泡:短请求一结束槽位立刻给新人,decode 阶段每个 step 的每个序列槽都在吐有效 token。第二块是消除批间空窗:static 方案里下一批必须等上一批整体收尾,GPU 在收尾部段是半空的;连续批处理没有「批」的概念,永远满载。第三块是排队延迟下降:新请求的等待时间从「批内最长请求的剩余步数」降到「下一个 iteration」,几十毫秒量级。Orca 论文用 GPT-3 175B 规模的模拟给出的数字是同等延迟 SLO 下吞吐可达 static 方案的数倍到十几倍,vLLM 在真实 13B 部署上复现的结论也在 2~4 倍这个区间。
三、准入控制:KV 显存是硬闸门
「有空位就塞」说得轻巧,真正的约束是 KV cache 显存。一条请求的 KV 占用 = 层数 × 2(K和V)× 头数 × 头维 × 字节数 × 序列长度,以 13B 模型 FP16 为例大约每 token 800KB 上下。PagedAttention 把 KV 切成定长块(block,默认 16 token/块),调度器准入判断就变成一道简单的算术题:
关键点:准入只按 prompt 长度试分配,生成阶段还要持续吃块(每 16 个新 token 多吃一块),这部分靠运行时动态分配,真不够了就走抢占。这是一个「乐观准入 + 事后兜底」的设计——如果准入时连 prompt 都放不下的请求永远等下去,会饿死,所以实践中还会配 watermark(预留少量块给运行中请求的 decode 增长)。
另一个准入维度是 max_num_seqs(batch 内序列数上限,默认 256)和 max_num_batched_tokens(单步 token 数上限)。前者防调度元数据膨胀,后者防单步延迟爆掉——batch 里塞 200 条 decode 很快,但混入 10 条 4K prompt 的 prefill,这一步就要算 4 万多 token,ITL(inter-token latency)会明显抖一下。这就是下一节 chunked prefill 要解决的问题。
四、抢占与换出:显存打满时的两条退路
运行中的 batch 持续增长,终究有块不够分的那一刻。调度器必须踢人:把某个序列的 KV 让出来给更前面的序列用。vLLM 提供两种抢占模式:
| 维度 | Recompute(重算) | Swap(换出到 CPU) |
|---|---|---|
| 做法 | 丢弃 KV 块,恢复后重新 prefill | KV 块整体拷到 CPU 内存,恢复时拷回 |
| 恢复代价 | 重新算一遍前缀,O(L) 计算 | PCIe 双向搬运,O(L) 带宽 |
| 典型开销 | 13B 模型 2K token 约 100ms+ | 2K token KV(~1.6GB)约 100ms(16GB/s PCIe) |
| CPU 内存占用 | 零 | 需要 swap space(可配几十 GB) |
| 适用场景 | 前缀短、CPU 内存紧张 | 前缀长、PCIe 宽裕、重算太贵 |
被踢的序列回到等待队列头部(不是尾部),等显存缓和后优先恢复——否则长请求可能被反复抢占永远跑不完,这是公平性上的必要保护。对被抢占请求的调用方来说,体验是流式输出中途停顿几百毫秒再续上,token 不会丢、内容不重头,因为已生成的 token 序列本身一直保存在 CPU 侧的请求状态里,被牺牲的只是 GPU 上的 KV 副本。
受害者选择策略是「最后进来的先走」(LIFO),因为它已投入的 KV 最少、重算/搬运代价最低。工程上还要防乒乓:同一条序列被抢占 N 次后强制等更久,避免负载高峰时几条请求互相踢来踢去谁都不前进。
实际部署里怎么选?经验法则:CPU 内存管够就 swap——拷贝是流式的、可以和计算重叠,对 TTFT 影响可预测;重算会把整条前缀的计算量再吃一遍,长 prompt 场景下比 swap 贵得多,而且这一步 prefill 还会挤占同 batch 其他请求的延迟预算。
五、chunked prefill:把大象切块喂
前面提过混合 batch 的毛刺:一条 8K token 的长 prompt 做 prefill,单步要算 8K token,同 batch 里其他 100 条 decode 请求都得陪它等这一步——ITL 从 40ms 飙到 400ms,在线服务的流式体验直接崩掉。
chunked prefill 的解法:把长 prompt 切成固定大小的块(比如 512 token/块),每个 iteration 只喂一块,剩下的预算用 decode 填满。这样每一步的 token 总数被 max_num_batched_tokens 卡死,单步耗时基本恒定。

代价是新请求的 TTFT(time to first token)略微变长——8K prompt 不再一步算完,要摊 16 步。但每一步都很快,总 TTFT 往往反而优于混合毛刺方案,因为不用等别的长 prefill。SARATHI 论文的数据是 decode 吞吐提升可达数倍、ITL 方差下降一个数量级。vLLM 0.3 之后这个功能默认进主干,生产配置里建议始终开:--enable-chunked-prefill 配 --max-num-batched-tokens 2048 是常见起点。
六、逐迭代走查:一个五步实例
把前面所有机制放进一个具体的五步小例子里走一遍,很多抽象规则就落地了。设块大小 16 token,GPU 上 KV 池共 64 块,max_num_seqs=4。迭代 0:队列里有 A(prompt 100 token)、B(prompt 40 token)、C(prompt 20 token)。调度器按 FCFS 取 A,需 7 块,准入;B 需 3 块,准入;C 需 2 块,准入。本轮 batch = {A,B,C},A 做 prefill 100 token,B 40,C 20。迭代 1:三者都进入 decode,各吐 1 token,占用块数不变(还没跨块边界)。迭代 8:C 输出满 20 个 token 触发 stop,调度器在下一轮开头移出 C、释放 2 块;队列里 D(prompt 60 token,需 4 块)此时空闲块够,准入做 prefill——注意 C 腾出的只有 2 块,另外 2 块来自池里原本的空余。迭代 20:A 的 KV 长到需要第 8 块,申请时发现池子满了(B、D 也在长),触发抢占:选最年轻、投入最少的 D 踢出(swap 模式,KV 异步拷 CPU),A 拿到块继续。迭代 45:B 完成,释放 5 块,D 从队首恢复——swap 模式直接拷回,recompute 模式则重跑 60 token 的 prefill 再接着 decode。
这个例子刻意把准入、完成释放、抢占、恢复四种事件压进 50 步里,真实流量下它们各自以秒级到分钟级的频率出现,但走的完全是同一条主循环。值得记住的一个推论:调度器从不预测输出长度。C 什么时候结束、A 会不会撑爆显存,事前都不知道,所有决策都是「看当前块水位做事后反应」。这让实现简单健壮,但也意味着长输出请求天然是尾延迟来源——业务侧如果对输出长度有先验(比如摘要任务通常 300~500 token),应该用 max_tokens 或长度分层路由把它用起来,而不是指望调度器变聪明。
七、吞吐对比与调参速查
把整条链路的效果落到数字上。以 13B 模型、单卡 80GB、真实对话流量(prompt 均值 200、输出均值 300、长尾到 2K)为基准的典型量级:
| 方案 | 有效算力利用率 | 相对吞吐 | P99 ITL | 说明 |
|---|---|---|---|---|
| static batching(batch=32) | 20%~40% | 1× | 低(批内一致) | 气泡大,但单步延迟稳 |
| 连续批处理 | 60%~85% | 2.5~4× | 有 prefill 毛刺 | Orca/vLLM 论文主结果 |
| + chunked prefill | 70%~90% | 3~4.5× | 平滑 | 在线服务推荐形态 |
vLLM 官方 benchmark 里相对 FasterTransformer 静态批量的吞吐提升常见 2~4 倍,相对 naive HF 实现可达 20 倍以上(后者还叠了 PagedAttention 的显存收益)。
调参速查,按症状对症下药:
| 症状 | 先查 | 再调 |
|---|---|---|
| 吞吐低、GPU 利用率低 | 等待队列是否常空 | 放大 max_num_seqs、检查 gpu_memory_utilization(0.9 起步) |
| ITL 周期性尖刺 | 是否混入整块 prefill | 开 chunked prefill,压低 max_num_batched_tokens |
| 抢占频繁、请求被反复踢 | KV 块水位 | 降并发准入,或换 swap 模式并加大 swap space |
| TTFT 高 | 队列排队时间 | 加副本或开优先级调度,别硬塞单卡 |
| 长输出请求拖垮尾延迟 | 无长度预测时的固有现象 | 按业务设 max_tokens 上限,或分层路由到不同实例 |
调度策略本身也有选择:默认 FCFS(先来先服务)简单公平;vLLM 新版支持优先级字段,VIP 请求可以插队;多 LoRA 场景下调度器还会感知 adapter 驻留,优先调度权重已在卡上的请求,减少换载。这些属于进阶旋钮,先把 FCFS + chunked prefill 跑稳再碰。
最后给一个容量估算的土办法,上线前算一遍能避开大多数翻车:单卡可用 KV 块数 =(显存 × gpu_memory_utilization − 模型权重 − 激活预留)÷ 单块字节数;单请求平均块数 ≈(平均 prompt + 平均输出)÷ 16;两者相除就是稳态并发上限。实测并发长期顶着这个上限跑,抢占就会频繁出现,此时正确的选择是加卡/加副本或换 swap 模式,而不是继续压榨单卡——抢占救的是毛刺,救不了持续过载。
这一篇在知识体系里的位置
- 向上承接:KV cache 与推理显存 算出单请求显存账,本篇的准入判断和抢占代价全部建立在那笔账上。
- 兄弟篇:PagedAttention 与 vLLM 推理服务 讲分页 KV 怎么省显存(块怎么分、怎么共享),本篇讲调度器怎么用这些块(谁进 batch、谁被踢),两者是 vLLM 的显存层与调度层,合读才是完整图景。
- 横向相关:投机解码加速推理 让单步吐多个 token,会改变调度器的迭代语义(准入预算、抢占恢复都要按多 token 计);推理运行时调度 覆盖更通用的算子级调度视角。
- 落地延伸:GEMM Split-K/Stream-K 调度 讲 batch 拼好后底层 GEMM 怎么切,是「调度之下还有调度」的下一层。
总结
连续批处理把 LLM 推理的调度粒度从「请求」降到「迭代」:每生成一个 token,调度器就移出已完成请求、按 KV 空闲块数准入新请求、拼好新 batch 再跑下一步,长短请求混排不再互相占坑,有效算力利用率从 static batching 的二三成提到八成以上;显存打满时用 recompute 或 swap 抢占最年轻序列兜底,配 chunked prefill 把长 prompt 切块摊平,就能同时拿到高吞吐和平稳的 token 间延迟——这是 vLLM 之类现代推理服务吞吐领先静态批量 3~4 倍的核心机制。