DPI-C:SystemVerilog 接入 C 参考模型的接口设计与集成实战
更新时间:2026-10-01。SystemVerilog 测试平台基础 把验证环境的分层讲清楚了,DPI 接入 C/C++ 混合仿真 讲了 DPI 与 C++ 符号交互的坑,用 DPI 挂 C 参考模型做比对 则从「模型比对方法论」角度讨论了为什么要有参考模型。这一篇落在更细的工程层面:当你已经决定用 DPI-C 挂一个 C 模型,接口到底怎么设计、open array 怎么传、调用开销怎么压、在 scoreboard 里放哪个位置,逐条拆开。
本文要回答的问题
- import 和 export 两种方向的 DPI 函数各自适合什么场景,
context关键字到底改变了什么? - 大批数据(一个包、一帧图像)怎么跨语言传?open array 句柄 API 的正确用法是什么?
- 一次 DPI 调用开销有多大?什么粒度的调用会把仿真拖垮,怎么批处理?
- C 参考模型在 UVM 环境里挂在哪一层,和 predictor/scoreboard 怎么衔接?
一、DPI-C 是什么:仿真器进程里的一座直通桥
DPI(Direct Programming Interface,直接编程接口)是 SystemVerilog 标准里规定的一套与 C 语言互调的机制。和它的老前辈 PLI/VPI 相比,DPI 的哲学是「简单粗暴」:不做句柄遍历、不做层次查询,就是把 SV 侧的一次函数调用,直接翻译成对同一个进程里一个 C 函数的调用。参数按标准 ABI 压栈,返回值按 C 约定返回,中间没有事件调度、没有时间推进——对仿真器来说,DPI 函数体内部是「零时间」的。
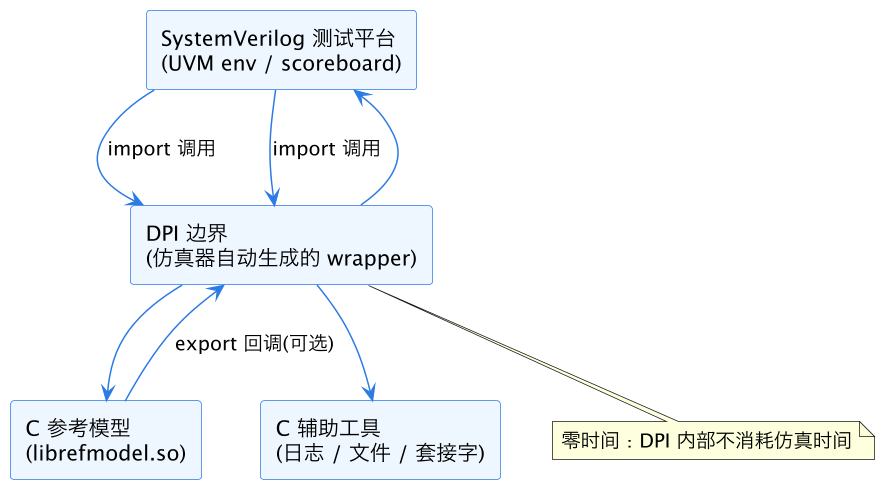
上图是 DPI 集成的基本结构:SV 侧通过 import 声明把 C 函数引进来,像调用本地 function 一样调用它;C 侧如果反过来需要调 SV 的函数(比如从模型内部打印一条 UVM 消息),就用 export 把 SV function 暴露给 C。中间那层 wrapper 由仿真器在编译期自动生成,你只管两边各写各的。
一个常见的疑问是「为什么不直接用 SV 写参考模型」。三个现实原因:其一,很多 golden model 本来就存在——算法团队交付的 C 库、指令集模拟器、第三方密码学实现,重写一遍等于引入第二份需要维护的「参考」,两份参考不一致时你都不知道信谁。其二,C 的执行速度比 SV 行为级代码快一个量级不止,浮点和查表密集型算法差距更大。其三,复用已有 C 库意味着验证环境和软件侧用同一份模型,硅前比对结果对驱动开发直接有效。
正因为「零时间」,DPI 最适合的角色就是算法密集型、无状态机时序语义的东西:加密算法的参考实现、浮点运算单元的行为模型、图像处理流水线、CRC/校验和计算器。凡是「给一组输入、算一组输出」的纯计算,用 C 写一份、DPI 挂进来,比用 SV 重写在开发效率和运行速度上都划算。反过来,凡是涉及信号驱动、等待时钟沿、和 DUT 时序交互的事,DPI 管不了,那是 interface 和 driver 的地盘。
二、import 与 export:两个方向的接口设计
DPI 的调用有两个方向。import 是 SV 调 C,这是挂参考模型的主通道;export 是 C 调 SV,通常只做辅助——最常见的是让 C 模型内部能通过 SV 的 uvm_report_info 打日志,这样模型报错能进 UVM 的报告体系、带严重级别、参与错误计数,而不是 printf 到 stdout 里没人看。
// ---- SV 侧声明 ----
// import:把 C 函数引进来
import "DPI-C" function void ref_model_reset();
import "DPI-C" function int ref_model_exec(
    input  bit [31:0] insn,
    input  bit [31:0] rs1_val,
    input  bit [31:0] rs2_val,
    output bit [31:0] rd_val,
    output bit        trap
);

// export:把 SV 函数暴露给 C(供模型打日志)
export "DPI-C" function sv_log;
function void sv_log(int level, string msg);
  case (level)
    0: `uvm_info("REF_MODEL", msg, UVM_MEDIUM)
    1: `uvm_warning("REF_MODEL", msg)
    default: `uvm_error("REF_MODEL", msg)
  endcase
endfunction// ---- C 侧实现 ----
#include "svdpi.h"
#include <stdio.h>
extern void sv_log(int level, const char* msg);
static uint32_t rf[32]; // 模型内部寄存器堆
void ref_model_reset(void) {
memset(rf, 0, sizeof(rf));
sv_log(0, "reference model reset done");
}
int ref_model_exec(uint32_t insn, uint32_t rs1, uint32_t rs2,
uint32_t* rd_val, svBit* trap) {
/* 解码执行,写 rd_val / trap */
...
return 0;
}接口设计有三条纪律。第一,import 函数尽量设计成无状态调用者视角——状态(比如上面的寄存器堆 rf)封装在 C 侧静态变量或显式句柄里,SV 侧只传激励和收结果。状态散在两边是集成后最难调的 bug 来源:SV 复位了 DUT 却忘了调 ref_model_reset,模型就拿着旧状态继续跑,比对失配查半天。所以配对纪律是:DUT 的 reset 流程里必须有一步调模型的 reset,写进 base test 的 reset phase。
第二,output 参数在 C 侧是指针。SV 的 output bit [31:0] 到 C 侧是 uint32_t*,output bit 是 svBit*。C 函数里忘记解引用、直接对指针赋值,编译能过、行为全错。建议每个 output 参数在函数入口先写一行 *rd_val = 0; 之类的默认赋值,既是防御也是文档。
第三,context 关键字只在你需要它时才加。import "DPI-C" context function ... 声明的函数在调用时会把 SV 侧的作用域上下文传进 C,使 C 侧能用 svGetScope()、能调 export 函数、能用 VPI 查层次。代价是每次调用多一次上下文切换的固定开销。经验法则:纯计算的 import 一律不加 context;只有需要回调 SV(比如调 sv_log)或访问 SV 层次的函数才加。很多团队图省事全部 context,回归慢了一截还查不出原因。
类型映射是接口设计的地基,先把常用对应关系钉死:
| SV 类型 | C 类型 | 备注 |
|---|---|---|
int / bit [31:0] | int / uint32_t | 按值传,最省心 |
longint / bit [63:0] | long long / uint64_t | 注意 C 侧 long 在部分平台是 32 位 |
bit | svBit(unsigned char) | 2 值逻辑,只有 0/1 |
logic | svLogic | 4 值逻辑,含 X/Z,C 侧要自己定 X 的语义 |
string | const char* | 只读;C 返回的字符串指针 SV 侧拷贝收走 |
bit [N:0](N>63) | svBitVecVal*(指针) | 超 64 位一律变成指针传址 |
T data[](open array) | svOpenArrayHandle | 见下节 |
| packed struct | 相同位布局的 C struct/数组 | 要求两边位序严格一致,慎用 |
logic 一行值得单独强调:SV 侧一个 X 传到 C 侧,svLogic 的值是 sv_x(通常为 2),如果你的 C 模型把它当布尔值直接进 if 判断,X 会被静默当作「真」处理掉——参考模型吞了 X,比对就永远发现不了 DUT 的 X 泄漏。纪律是 import 参数尽量用 2 值类型(bit、int),非用 logic 不可时 C 侧入口先显式检查 X/Z 并报错。
三、open array:跨语言传大批数据的正确姿势
标量和位向量按值传很直接,真正的难题是变长大块数据:一个网络包的 payload、一帧解码后的像素、一段 DMA 描述符链。SV 侧它们是动态数组或队列,C 侧它们是 void* + length。DPI 的答案是 open array——声明形参为 input bit [7:0] data[],调用时传任意大小的 unpacked 数组,C 侧收到一个 svOpenArrayHandle 句柄,通过 API 查询维度和取元素。
import "DPI-C" function int ref_model_transform(
    input  bit [7:0] payload[],   // open array:大小由调用点决定
    output bit [7:0] result[]
);int ref_model_transform(const svOpenArrayHandle payload,
const svOpenArrayHandle result) {
int in_len = svSize(payload, 1); // 第 1 维长度
int out_len = svSize(result, 1);
const svBitVecVal* in_ptr =
(const svBitVecVal*)svGetArrayPtr(payload);
svBitVecVal* out_ptr =
(svBitVecVal*)svGetArrayPtr(result);
for (int i = 0; i < in_len && i < out_len; i++)
out_ptr[i] = transform_byte(in_ptr[i]);
return in_len;
}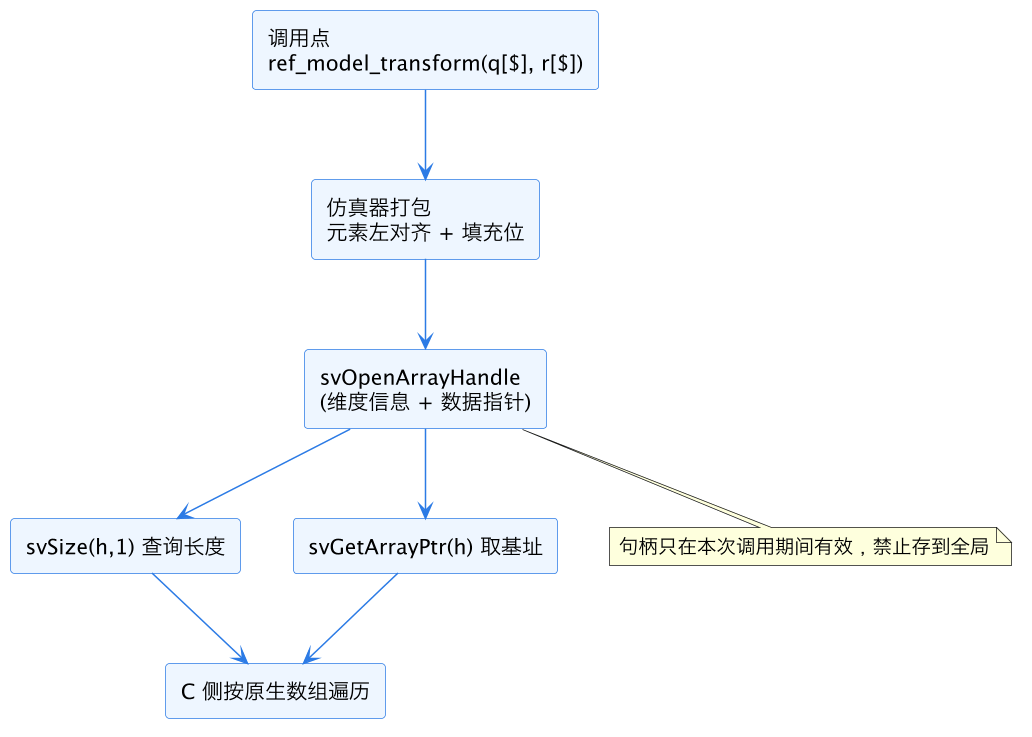
上图是 open array 数据流的完整链路,三个坑必须记住。其一,句柄生命周期:svOpenArrayHandle 只在这次调用内有效,把句柄存进 C 的全局变量留到下次用,行为未定义——有些仿真器恰好还能读到,换一家就段错误。要跨调用持有数据,在 C 侧 malloc 一份拷贝。
其二,元素位宽与填充。bit [7:0] 的 open array,C 侧元素类型是 svBitVecVal(32 位容器),有效数据在低 8 位,高位是填充。按 char* 强转着遍历在大小端不同的机器上会拿到错位数据。稳妥做法:要么元素类型选 packed 维度凑满 32 位(bit [31:0] data[]),要么乖乖按 svBitVecVal 取低位。
其三,方向一致性。input open array 在 C 侧是 const,往里面写是未定义行为;output 的数组大小由 SV 调用点分配好,C 侧只能往里填,不能要求 C 返回一个它自己 malloc 的数组让 SV 接收——SV 的数组尺寸必须在调用前确定。如果输出长度依赖计算结果,拆成两次调用:第一次让 C 算出输出长度,SV 侧据此分配,第二次真正取数据。这个「两趟协议」是 DPI 批量传参的标准模式,关于 SV 数组类型本身的取舍见 SV 数据类型:packed 与 unpacked。
四、调用开销:DPI 不是免费的,按批调用
「DPI 很快」这个说法只对了一半。单次调用的开销确实只有几十到几百纳秒量级(本地 function 调用的几倍),但架不住次数多。一条指令调一次 ref_model_exec、一秒钟仿真跑几千万条指令,光跨界调用就吃掉可观的仿真时间——测试平台性能剖析 里测过真实回归,DPI 调用频繁时跨界开销能占平台侧耗时的三到四成。
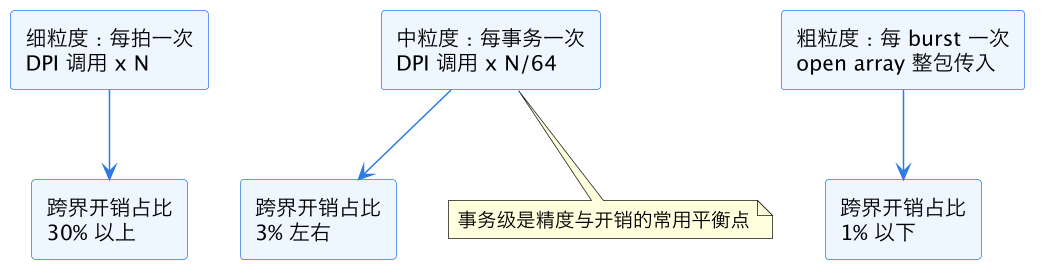
上图给出三档调用粒度的开销对比,数字来自典型配置下的实测量级(具体比例随仿真器和模型复杂度浮动)。优化策略按收益排序:
- 批处理传入:能攒成数组的绝不逐元素调。64 拍的数据攒进 open array 一次传入,跨界次数降为 1/64,单次拷贝开销摊薄到可忽略。
- 合并上下文:把多个零散参数打包进一个 packed struct(DPI 支持 packed struct 按位布局传参,C 侧按相同布局定义),一次调用带齐。
- 减少 output 指针回写:output 参数多的时候,改成 C 侧维护结果缓冲、SV 侧用一个「取结果」的轻量函数批量拉走。
- 砍掉 context:如前所述,纯计算函数不加 context。
| 调用模式 | 每次跨界开销 | 千万次级调用的仿真影响 | 适用场景 |
|---|---|---|---|
| 逐拍 import(含 context) | 高(含上下文切换) | 占平台耗时 30%+ | 只在调试期、必须回调时用 |
| 逐事务 import | 中 | 3% 左右 | 指令级模型、协议包处理 |
| open array 批处理 | 低(摊薄) | 1% 以下 | 数据面模型、图像/报文批量 |
| C 侧驻留 + 轻量拉取 | 最低 | 可忽略 | 大状态模型(内存、缓存) |
还有一类反模式值得点名:把 DPI 当 mailbox 用,SV 每拍调一次 poll() 问 C 侧「有事吗」。这是把事件驱动轮询化,仿真时间越长浪费越大。正确做法是让 SV 侧的事件驱动结构(monitor 的 analysis port)在事务到达时推给 C 模型,C 侧只被动响应。
五、集成结构:C 模型在 UVM 环境里的位置
最后一个问题:挂好了接口,这个模型在环境里放哪?标准答案是 predictor——scoreboard 前面那个「根据激励算出期望结果」的组件。Scoreboard 中的 predictor 模式 讲过这个分层:predictor 订阅 monitor 的 analysis port,收到一笔输入事务,调 DPI 模型算出期望输出,把期望事务发给 scoreboard 和实际结果比对。
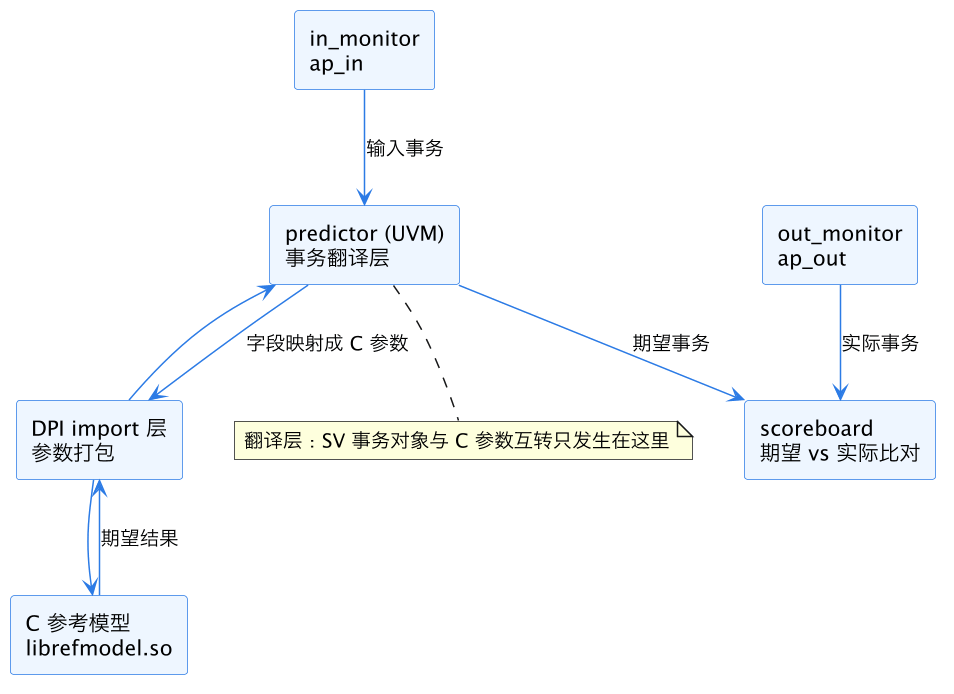
上图是典型集成结构,注意 predictor 里有一层「翻译层」——把 SV 事务对象的字段映射成 C 函数参数、把 C 的返回值装回期望事务对象。这层代码不性感,但它是整个集成里最容易写错的地方:字段位宽截断、字节序搞反、枚举值两边定义不一致,全都是比对失配的重灾区。两条纪律:翻译层集中写在一个 adapter 类里、别散落在各 test 中;reset 时 predictor 负责调 ref_model_reset(),保证模型与 DUT 生命周期对齐,这一点在 C 参考模型比对方法论 里有更系统的讨论。
模型里如果带大状态(比如一块内存模型的内容),别走 import 参数传来传去,让状态驻留 C 侧,SV 只在需要后门访问时调一个轻量读写函数——这和 内存模型后门访问 以及 内存后门记分板方案 是同一个思路的两端:数据在哪,算力就去哪,跨界只传控制与校验摘要。
六、上线前的调试清单:比对失配先查这五件事
集成完成后回归一旦出现大片比对失配,按经验顺序排查,命中率很高:
- 复位对齐:确认 base test 的 reset phase 里调了
ref_model_reset(),且时机在 DUT 复位释放之前。模型带旧状态起跑是失配第一名。 - 字节序与位序:open array 和 packed struct 传参后,第一笔事务先在两边各打一份 hex dump 比对,肉眼确认布局一致,再放量跑。
- X 语义:SV 侧出现 X/Z 的字段在进 C 模型前是否被转换或拦截,
logic参数是否走了 2 值强转。 - 上下文污染:C 模型里有没有用到全局静态变量被多个 import 调用共享,多 testcase 连跑时第二次仿真是否复用了第一次的残留状态——表现为「单跑全过、连跑乱挂」。
- 句柄误存:所有
svOpenArrayHandle是否只在当次调用内使用,有没有被存进全局指针。
这份清单的本质是把前面四节埋的坑反向串一遍:DPI 集成的问题很少是算法错,绝大多数是边界上的约定没对齐。把这份清单固化成集成 checklist,每次挂新模型照走一遍,能把集成期从按周计压到按天计。
这一篇在知识体系里的位置
DPI-C 是验证环境里「借力外部世界」的标准通道,这一篇把接口设计、传参、性能、集成结构四件事串成了可落地的操作清单,外加一份上线前的调试清单。向上,它服务的是 C 参考模型比对方法论 描述的 golden model 验证策略;横向,与 DPI 接入 C/C++ 混合仿真 互补(那篇管 C++ 符号与构建,本篇管接口与性能);向下,传参细节依赖 SV 数据类型 的 packed/unpacked 语义,性能问题归口 测试平台性能剖析,集成位置落在 predictor 模式 的框架里。
总结
DPI-C 接入 C 参考模型的正确姿势是:import 设计成「SV 传激励、C 藏状态」的无状态调用,纯计算不加 context,大批数据用 open array 句柄按批传入(句柄不跨调用持有、两趟协议解决变长输出),调用粒度提到事务级以上把跨界开销压到个位数百分比,模型挂在 predictor 后面、reset 与 DUT 对齐——接口对了,C 模型就是验证环境里最划算的那笔投资。