功能覆盖率完整指南:covergroup/coverpoint/cross/bins 到合并签核全流程
更新时间:2026-09-28。本文是「集成电路大类 · 芯片设计 · 数字验证」序列里功能覆盖率方向的枢纽深文。姊妹篇 代码覆盖率与功能覆盖率 已经讲过「两种覆盖率量的是两件不同的事」,本篇往深走一步:把功能覆盖率从建模 → 采样 → 合并 → 收敛 → 签核的整条流水线拆开讲透,并把散落在各处的专题文(分桶细节、选项语义、合并排除流程、验证计划映射)串成一张地图。
本文要回答的问题
- 一个完整的功能覆盖率模型由哪些部分组成,各自回答什么问题?
- coverpoint 的 bins 怎么设计才有鉴别力,cross 什么时候该加、什么时候是浪费?
- type_option 与 option 的区别是什么,goal/at_least/weight 各控制什么?
- 成百上千个 seed 的覆盖率怎么合并,空洞怎么分析、waiver 怎么签?
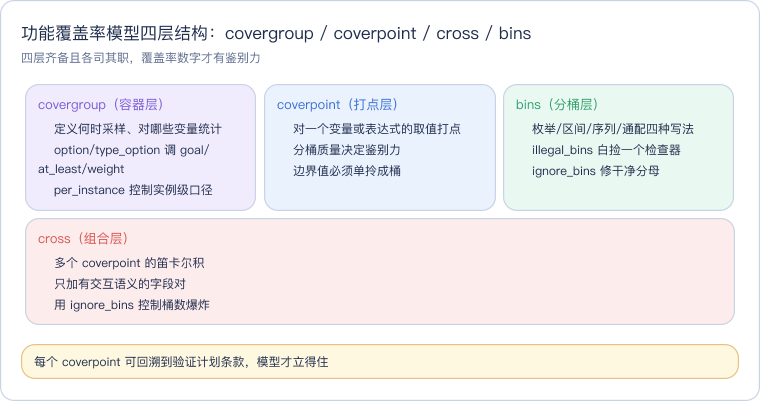
在展开全流程之前,先用一张总览卡把模型的四层结构立起来——covergroup 是容器、coverpoint 是打点、bins 是分桶、cross 是组合,后文每一节都是在给其中一层填细节。读任何一段时如果迷失了,回到这张卡定位自己站在哪一层。
一、覆盖率模型全景:一张图看懂五大件
功能覆盖率不是「写几个 covergroup」就完事,它是一条从规格到签核的链路。先给全景图,后面逐节展开。
这张图的核心信息是:功能覆盖率是一个闭环,不是一个指标。验证计划是源头——每一个 coverpoint 都应该能回溯到规格的某一条款(映射方法见 testplan 与覆盖率映射);合并与报告是中转站——单个 seed 的覆盖率没有意义,必须 merge 成全项目视图;收敛动作是回路——发现空洞后优先回 受约束随机验证 CRV 调约束,而不是堆定向用例。
二、covergroup:功能空间的基本容器
covergroup 是功能覆盖率的顶层结构,定义「在什么时候、对哪些变量、按什么分桶」统计。一个骨架:
covergroup cg_fifo @(posedge vif.clk iff vif.valid);
  option.name      = "fifo_cg";
  option.per_instance = 1;

  cp_op: coverpoint tr.op {
    bins wr = {OP_WR};
    bins rd = {OP_RD};
  }

  cp_level: coverpoint vif.usedw {
    bins empty = {0};
    bins low   = {[1:7]};
    bins mid   = {8};
    bins high  = {[9:15]};
    bins full  = {16};
    illegal_bins bad = {[17:$]};
  }

  x_op_level: cross cp_op, cp_level {
    ignore_bins impossible = binsof(cp_level.empty) && binsof(cp_op.rd) == 0;
  }
endgroup
三个要点:
- 采样事件写在
@(...)里。常见做法是挂在 monitor 观察到真实事务的时刻,并用iff过滤无效周期——统计的是 DUT 实际经历的行为,不是激励端「我打算发什么」。 - per_instance:一个 covergroup 被多个实例(比如 8 个通道)例化时,开
per_instance = 1才能看出「通道 3 从没满过」这种 per-instance 空洞,否则 8 个实例的命中被混在一起。 - covergroup 的更细语法(自动 bins、序列 bins、通配 bins)见专题文 covergroup/coverpoint/bins 详解。
三、coverpoint 与 bins:分桶决定鉴别力
coverpoint 对一个变量或表达式的取值空间打点,bins 把空间切成有名字的桶。分桶质量直接决定覆盖率的鉴别力——全用 default 自动桶等于没测。
| 分桶方式 | 写法示例 | 适用场景 | 常见坑 |
|---|---|---|---|
| 显式枚举 | bins wr = {OP_WR}; | 枚举、命令码 | 新增枚举值忘了补桶 |
| 区间 | bins low = {[1:7]}; | 水位、长度、延迟 | 边界值(0、满、max)漏单拎 |
| 序列 | bins seq = (0=>1=>3); | 状态迁移、协议时序 | 写成集合 {0,1,3} 语义全变 |
| 通配 | wildcard bins err = {4'b1??1}; | 错误码、部分位有效 | 与显式桶重叠重复计数 |
| default | bins rest = default; | 兜底 | default 不计入覆盖率百分比,别拿它当主力 |
两条铁律:
- 边界值必须单拎成桶。FIFO 水位的 0 和 16、数据长度的 1 和 max,这些值最容易藏 bug,埋在区间桶里就永远不知道它们有没有被随机到。
illegal_bins当检查器用。规格禁止的取值(比如 usedw 超过深度)一旦出现立刻报错,等价于白捡一个 assertion;ignore_bins则用于「物理上不可能」的组合,把分母修干净,否则覆盖率永远到不了 100%。
四、cross:专门捕捉「单点都测过、组合没出现」
cross 是多个 coverpoint 的笛卡尔积,是功能覆盖率最有杀伤力的部分。经验法则:
- 该加:有交互语义的字段对——操作×水位(满时写、空时读)、命令×地址区间、传输方向×反压状态、主端×从端组合。
- 别加:互相独立的字段。数据值 × 操作类型如果规格上没有关联,cross 出来的是几十上百个无意义桶,稀释报告还让收敛变难。
- 控制爆炸:cross 的桶数 = 各 coverpoint 桶数相乘。先用
ignore_bins把不可能组合排掉,必要时在 cross 里用binsof(...) intersect {...}只对子集做交叉。
图里这条链是日常收敛的缩影:cross 命中矩阵里 (wr, full) 是 0,多半不是测试不够随机,而是约束分布让「快满了还在写」这个场景概率太低——回去调 dist 权重或加一个「先把 FIFO 灌满再写」的 scenario 层,比写十个定向用例都干净。
五、option 与 type_option:实例调参 vs 类型默认值
这是最容易混的一对。option 作用于当前实例(在 covergroup 体内或 new 之后设置),type_option 作用于该 covergroup 类型的所有实例(只能在 covergroup 体内设)。常用项:
| 选项 | 作用 | 建议值与理由 |
|---|---|---|
goal | 该实例/类型算 100% 所需百分比 | 默认 100;大面积 ignore 的场景可降到 90 但要在计划里写明 |
at_least | 每桶至少命中几次才算覆盖 | 关键场景设 ≥10,一次偶然命中不算数 |
weight | 该 coverpoint/cross 在组总分里的权重 | 危险 cross 加权,装饰性 coverpoint 降权或置 0 |
per_instance | 是否按实例分别统计 | 多实例 DUT 必开 |
strobe/comment | 采样方式 / 报告注释 | comment 写清对应验证计划条目号 |
完整语义细节见 covergroup options/goal/at_least。这里只强调一个真实事故来源:type_option.goal 写错位置(在 covergroup 体外试图设)会被编译器静默当成实例 option,结果整组目标没生效——改完务必看一眼合并报告里 goal 是否真的变了。
六、合并、空洞与 waiver:从回归数据到签核
随机回归动辄几百上千个 seed,每个 seed 产一份覆盖率数据库(ucdb/vdb),必须合并成全项目视图才能判断进度。标准动作:

空洞分类只有三种归宿:能测到的反调约束、测不到的评审豁免、不该存在的提设计问题。具体的数据库命令、merge 策略与排除流程见 覆盖率合并与排除流程,工业化环境里的签核门禁见 UVM 覆盖率收敛签核。两条纪律:
- waiver 不许静默点。每条排除写清「为什么不可能/为什么不测」,设计和验证双签,能回溯到评审记录——否则就是掩耳盗铃。
- 覆盖率数字进回归看板。按模块跟踪趋势,RTL 一改覆盖率就应联动变化;某模块覆盖率连续几周不动,通常是回归没跑到或环境坏了(回归管理见 回归管理与失败分流)。
七、常见翻车清单
- [ ] covergroup 挂在激励端采样,统计的是「发了什么」而不是「DUT 经历了什么」;
- [ ] 边界值埋进区间桶,full/empty/max 从没被单独命中过也不知道;
- [ ] cross 不加 ignore_bins,几百个无意义桶把报告刷成永远 60%;
- [ ]
at_least默认 1,一个 seed 偶然命中就当收敛; - [ ] 多实例 DUT 没开
per_instance,通道级空洞被平均掉; - [ ] 单 seed 覆盖率直接当进度,忘了 merge 才是全项目视图;
- [ ] waiver 无评审记录,审计时拿不出依据。
这一篇在知识体系里的位置
本篇是功能覆盖率的枢纽:上游是 代码覆盖率与功能覆盖率(两类覆盖的分工)与 testplan 与覆盖率映射(覆盖点从哪来);建模细节向下分到 covergroup/coverpoint/bins 与 covergroup options/goal/at_least;收敛闭环接到 覆盖率合并与排除流程、UVM 覆盖率收敛签核 与 回归管理与失败分流;覆盖率的反馈回路最终落在 受约束随机验证 CRV 的约束调整上。
总结
功能覆盖率是从验证计划出发、用 covergroup 定义功能空间、靠 coverpoint 的显式分桶(边界值单拎、illegal_bins 当检查、ignore_bins 修分母)与有选择的 cross 捕捉关键组合、用 option/type_option 控制 goal、at_least 与权重的完整度量体系;它的价值不在单个数字,而在「随机回归 → 多 seed 合并 → 空洞三分(调约束/评审 waiver/提设计 issue)→ 再回归」的收敛闭环——模型可回溯到规格、waiver 可回溯到评审,两个都做到了才叫功能覆盖率签核。