Flash ADC 比较器阵列:2^N 规模膨胀、输入电容与起泡误差纠正的工程账
更新时间:2026-11-19。Flash ADC(闪烁式模数转换器)的基本结构——电阻串、并行比较器、温度计码与气泡错误——在 Flash ADC:并行比较阵列、温度计码转二进制与气泡错误 里已有一轮概念性介绍。本篇换一个视角:不再停留在「它长什么样」,而是拿纸笔算清楚三笔工程账——同一套结构从 2 位扩到 8 位、10 位时,比较器数量、输入电容和功耗各自按什么规律涨;亚稳态在温度计码里制造的气泡,纠错电路到底能纠正到什么程度、什么时候会失效;以及和 Pipeline、SAR 放在同一张表里,Flash 比较器阵列的适用边界究竟在哪。采样、量化与 LSB 的通用语言先读 ADC 采样与量化总览。
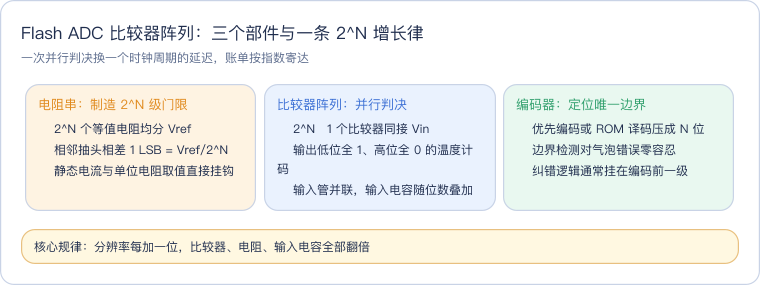
这张概念卡先给全局坐标:电阻串负责制造门限,比较器阵列负责同时判决,编码器负责把温度计码压成二进制。后面三节的算例和推导都挂在这三个部件上,最后两节再回答「气泡怎么纠」和「什么时候该选它」。
本文要回答的问题
- 一个 2 位 Flash 的电阻串上各点电压具体是多少?输入 0.60 V 时三个比较器各自输出什么、编码器为什么给出码 2?
- 扩到 3 位以后,七级抽头电压、温度计码和优先编码结果怎么完整走一遍?
- 比较器数 2^N−1、电阻数 2^N 这条指数律,怎样传导成输入电容、驱动功耗和芯片面积的连锁膨胀?为什么纯 Flash 实际止步于 6~8 位?
- 起泡误差(bubble error)的码流长什么样,多数投票和三点纠错电路为什么能把它压下去,连出两个气泡时为什么又会失效?
- 和 Pipeline、SAR 放在速率、精度、功耗、面积、延迟五个维度上对比,Flash 比较器阵列真正适合待在哪些系统位置?
一、2 位算例:四个电阻、三个比较器与一次完整判决
先从最小的可用结构算起。设参考电压 Vref = 1.00 V,做一个 2 位 Flash,1 LSB = Vref/2^2 = 250 mV。电阻串由 4 个等值电阻 Ru 串联构成,取 Ru = 100 Ω,则串总阻 400 Ω,静态电流 I = 1.00 V / 400 Ω = 2.5 mA,电阻串自身的静态功耗就是 Vref × I = 2.5 mW——注意这笔功耗在转换间隙也一直存在,它和采样率无关。
三个内部抽头从上到下的电压按欧姆定律直接写出:顶端 Vref 经过一个 Ru 降落 0.25 V,所以三个比较器门限依次是 0.75 V、0.50 V、0.25 V。三个比较器 C2、C1、C0 的反相端分别接这三个抽头,同相端全部并接输入 Vin;约定 Vin 高于门限时输出 1。
读图时沿电流方向看:橙色电阻串把参考电压切成等距台阶,蓝色比较器阵列拿 Vin 同时和三个台阶比较,紫色编码器只做一件事——找到温度计码里唯一一个 1 到 0 的边界。整条通路没有反馈、没有逐次试探,这是 Flash 一个周期出结果的结构根源。
现在把 Vin = 0.60 V 代进去。C0 的门限 0.25 V,0.60 > 0.25,输出 1;C1 的门限 0.50 V,同样输出 1;C2 的门限 0.75 V,0.60 < 0.75,输出 0。于是温度计码 C2 C1 C0 = 011,码中 1 的个数是 2,优先编码器输出二进制 b1 b0 = 10,即十进制码 2。重建电压是 2 × 250 mV = 500 mV,量化误差 0.60 − 0.50 = 0.10 V,小于半 LSB(125 mV),判决自洽。
编码器的布尔关系可以从四种合法码直接列出来:000→00、001→01、011→10、111→11。高位 b1 等于 C1——只要 C1 翻转,码值必然不小于 2;低位 b0 = C2 + C0·¬C1,即最高档全 1 时给 1,或者仅最低位为 1 时给 1。2 位时手写几个门还划算,位数一大就改用 ROM 式译码,第二节会看到。
| 输入区间 | C2(0.75 V) | C1(0.50 V) | C0(0.25 V) | 输出码 | 重建电压 |
|---|---|---|---|---|---|
| Vin < 0.25 V | 0 | 0 | 0 | 00 | 0 V |
| 0.25~0.50 V | 0 | 0 | 1 | 01 | 0.25 V |
| 0.50~0.75 V | 0 | 1 | 1 | 10 | 0.50 V |
| Vin ≥ 0.75 V | 1 | 1 | 1 | 11 | 0.75 V |
这张表里藏着 Flash 的两个原生性质:输入单调上升时输出码只增不减,天然没有失码;任何合法码都只有一处 1→0 边界,编码问题被退化成边界定位。第四节会看到,起泡误差的本质就是破坏了这第二条性质。
二、3 位算例:七级抽头、温度计码与 ROM 式优先编码
把位数加到 3,结构原样放大:电阻串变成 8 个等值电阻,1 LSB 缩到 1.00 V / 8 = 125 mV,比较器变成 7 个。仍取 Ru = 100 Ω,串总阻 800 Ω,静态电流降到 1.25 mA、静态功耗 1.25 mW——单位电阻不变时,电阻越多电流越小,这一点和第三节的面积账要连起来看。
七个抽头电压从低到高是 0.125、0.250、0.375、0.500、0.625、0.750、0.875 V,分别接 C0 到 C6。取 Vin = 0.55 V 走一遍:低于 0.55 V 的抽头有四个(0.125~0.500 V),所以 C0~C3 输出 1;高于 0.55 V 的三个抽头(0.625~0.875 V)对应 C4~C6 输出 0。温度计码 C6…C0 = 0001111,1 的个数为 4,编码输出二进制 100,重建电压 4 × 125 mV = 0.500 V,量化误差 50 mV,同样落在半 LSB(62.5 mV)以内。
| 比较器 | 门限电压 | Vin = 0.55 V 时输出 | 对编码的贡献 |
|---|---|---|---|
| C6 | 0.875 V | 0 | 边界以上 |
| C5 | 0.750 V | 0 | 边界以上 |
| C4 | 0.625 V | 0 | 边界以上 |
| C3 | 0.500 V | 1 | 紧邻边界的有效位 |
| C2 | 0.375 V | 1 | 计入 1 的个数 |
| C1 | 0.250 V | 1 | 计入 1 的个数 |
| C0 | 0.125 V | 1 | 计入 1 的个数 |
3 位已经有 8 种合法码,手写布尔表达式开始不划算,工程上改用 ROM 式译码:把 7 位温度计码当作地址,ROM 每个地址存对应的 3 位二进制,非法地址(含气泡的码)留作第四节的纠错映射位。另一种实现是先做边界检测 yi = Ci·¬Ci+1 得到独热码,再用编码树归约成二进制,逻辑级数只有几级门,延迟可控。
一次转换的时间预算用下面的时序关系表达。采样相结束后 Vin 被保持住,比较器阵列进入再生判决,温度计码逐级稳定,随后纯组合的编码器完成译码,下一个时钟沿把结果锁进输出寄存器。
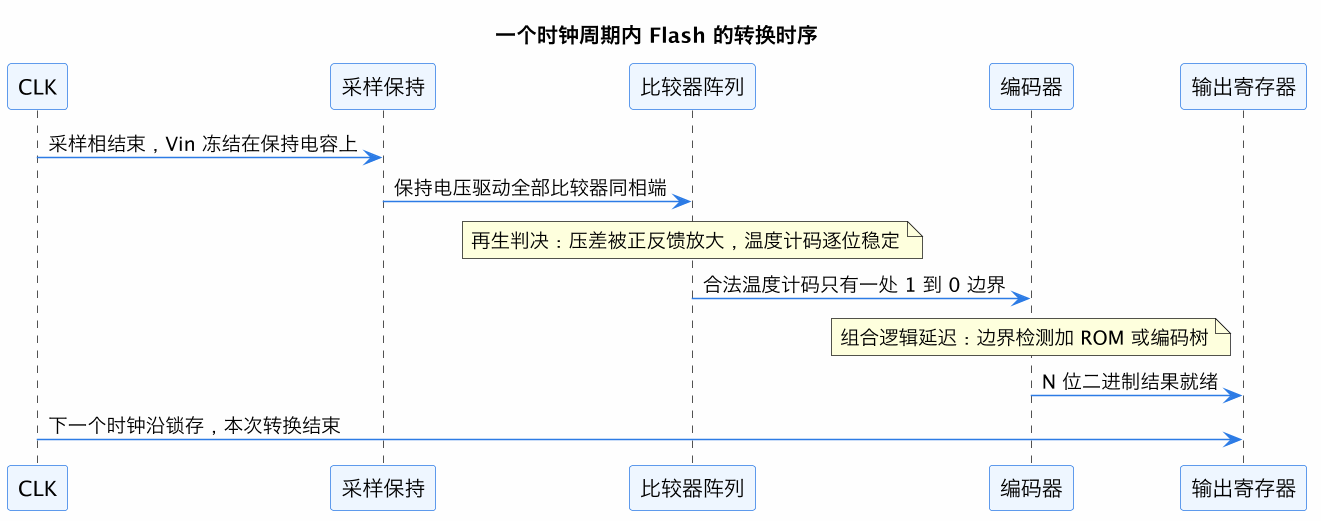
读这张时序图抓住一个要点:Flash 的转换延迟是「比较器再生时间加几级编码门」的纯前向通路,没有 N 个周期的迭代,这是它和 SAR ADC 逐次逼近 最根本的时间结构差异。代价是这个前向通路的宽度——同时工作的比较器数量——按 2^N 增长,第三节就算这笔账。
三、规模推导:2^N 律怎样吃掉面积、功耗与输入带宽
三个计数公式先写死:N 位 Flash 需要比较器 2^N − 1 个、电阻 2^N 个、编码器输入 2^N − 1 路。分辨率每提高一位,这三个数同时翻倍,没有折中空间——这是并行判决结构的内禀属性,不是工艺问题。
第一笔账是输入电容。每个比较器的同相端都接在同一个 Vin 节点上,输入对管的栅电容加上布线寄生记为 Cc,所有比较器在该节点上是纯并联关系:
Cin = (2^N − 1) × Cc + Cwire用一个教材级假设 Cc = 0.5 fF 感受量级(仅作数量级演示,非任何工艺的实测参数):6 位时器件贡献约 31.5 fF,8 位涨到 127.5 fF,10 位达到 511.5 fF,再计入比较器阵列之上的时钟线与信号线布线电容,实际 8 位产品的输入电容落在数 pF 量级是常见现象。
这张图把几十上百个并联输入管按位置收进三个分组,读的时候盯住红色的 Vin 节点:组内每个比较器都往这个节点挂一份 Cc,位数加一位,三组同时扩容一倍。1 对 N 的并联关系在电路上就是一个节点的电容累加,不存在「分摊」。
输入电容直接吃掉带宽。设前级等效内阻 Rs,时间常数 τ = Rs·Cin;N 位量化要求建立误差小于半 LSB,即残差小于满量程的 2^-(N+1),所需建立时间约为 t = (N+1)·ln2·τ ≈ 0.69(N+1)τ。仍用数量级假设 Rs = 50 Ω:8 位、Cin ≈ 0.5 pF 时 τ ≈ 25 ps,建立时间约 155 ps,在 GSPS 采样率下已经占去周期的可观份额;10 位时 Cin 翻四倍,建立时间同步翻四倍,采样率天花板随之塌方。高速链路前端常常要专门的缓冲器来低阻驱动这个节点,缓冲器自身又是一笔功耗。
第二笔账是功耗与面积的相对量级。设单个比较器每次再生判决耗能 Ec、采样率 fs,比较器阵列的动态功耗近似 P = (2^N − 1)·Ec·fs,与比较器数量同规律翻倍;电阻串则面临两难:保持单位电阻不变,串电流随位数下降但电阻总面积翻倍且匹配变差;保持总阻不变,单位电阻越做越小,失配恶化且基准缓冲器的灌电流能力要同步加强。
| 位数 N | 比较器 2^N−1 | 电阻 2^N | 输入电容相对 6 位 | 同采样率下阵列动态功耗相对 6 位 |
|---|---|---|---|---|
| 6 | 63 | 64 | 1.00× | 1.00× |
| 8 | 255 | 256 | 4.05× | 4.05× |
| 10 | 1023 | 1024 | 16.24× | 16.24× |
表中是数量级推算而非工艺实测数据,用来显示增长律:每加两位,硬件规模乘以约四。真正把纯 Flash 钉死在 6~8 位的还有匹配约束。1 LSB = Vref/2^N 随位数指数缩小,而比较器失调与电阻失配服从 Pelgrom 规律——标准差与器件面积平方根成反比,想让失调减半,器件面积要做到四倍。位数每加一位、LSB 减半,单器件面积约需四倍才能守住「失调小于半 LSB」,再叠加器件数量翻倍,匹配受限区的模拟面积每一位近似乘以八。这就是为什么工程上见不到纯 12 位 Flash:不是理论不允许,而是面积、功耗和输入带宽三笔账同时破产。更高分辨率的高速系统改用分级结构,让 Flash 退化成每级几比特的子 ADC,这正是 流水线 ADC:子级粗量化、残差放大与数字校正 的组织方式,每级位数怎么定见 流水线 ADC 每级位数与电容缩放,级间增益误差的传播见 流水线 ADC 级间增益误差。
四、起泡误差:亚稳态怎样污染码流,三点纠错怎样收敛
理想温度计码只有一处 1→0 边界,实际硅片上这个边界会「长毛」。仍用 3 位码举例:输入本应得到 0001111(码 4),若 C2 因亚稳态没有在采样沿前收敛、随机吐出 0,码流变成 0001011——液柱中间夹了一个空洞,这就是起泡误差(bubble error)。它的来源有三类:输入压差过小时比较器进入亚稳态,概率模型与误码率下限在 ADC 比较器亚稳态误码 里有定量推导;输入对管失调与电阻失配挪了个别门限;时钟与 Vin 到达各比较器的时序偏斜让大家采的不是同一瞬间。基础概念也可对照 建立保持时间与亚稳态。
危害在编码器一侧立刻显形。边界检测 yi = Ci·¬Ci+1 在 0001011 上会同时命中 i=3 和 i=1 两处,独热码变成两位有效,ROM 地址落到非法项,输出可能从码 4 直接跳到码 2 甚至更离谱的满量程毛刺码(sparkle code)。
第一种纠正电路是三点多数投票(majority-of-3):编码前对每一路做 Ci′ = MAJ(Ci−1, Ci, Ci+1),两端补边界约定 C7 = 0、C(−1) = 1。对 0001011 逐路计算:i=6 得 MAJ(0,0,0)=0,i=5 得 0,i=4 得 MAJ(0,0,1)=0,i=3 得 MAJ(0,1,0)=0,i=2 得 MAJ(1,0,1)=1,i=1 得 MAJ(0,1,1)=1,i=0 得 MAJ(1,1,1)=1,输出 0000111。码流恢复单调,非单调性被抹掉,但边界从码 4 挪到了码 3——这是必须诚实面对的代价:多数投票不恢复真实值,它把气泡改写成最坏 1 LSB 的偏差,用一次小误差换掉一次不可控的大跳变。
第二种是 ROM 相邻地址纠错:不取单点门限,而是把相邻三位 (Ci+1, Ci, Ci−1) 作为 ROM 地址,只给单调相邻的合法图样分配码字,像 101 这种含气泡图样直接重映射到最近的合法输出。它和多数投票效果等价,区别在实现位置——前者在编码前加一级组合滤波,后者把纠错吸收进译码表,没有额外的级间延迟,但 ROM 面积随码宽涨。
图中红色是问题节点、橙色是纠正动作、绿色是收敛判据、紫色是后续译码,读的时候注意纠错电路的位置:它插在比较器阵列和编码器之间,是编码前的一道独立门级。
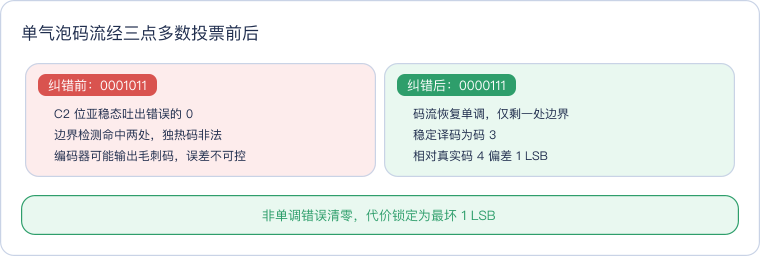
失效边界要一并讲清。多数投票只能对付孤立单气泡:如果两个气泡相邻,例如 0001001,逐路投票后得到 0000001,码值从 4 掉到 1,偏差 3 LSB,纠错失败。相邻双气泡需要更宽的五点投票(MAJ5)、冗余比较器或后台失调校准来覆盖,门数、功耗和延迟同步上升。此外滤波级本身要吃掉一到两级门延迟,在 GSPS 设计里这是实打实的周期预算;而且它处理的是已经发生的错误判决,降低亚稳态发生率仍要靠留足再生时间和前置预放,比较器层面的失调消除手段见 比较器斩波失调。纠错电路是安全带,不是刹车。
五、工程选型:Flash、Pipeline 与 SAR 的五维对比
把三类主流 Nyquist 架构放在同一张决策表里。表中是随工艺代际变化的典型量级,用来显示量级差异与取舍方向,不是任何具体产品的参数手册。
| 维度 | Flash | Pipeline | SAR |
|---|---|---|---|
| 采样率量级 | 1~10+ GSPS | 百 MSPS 至 GSPS | 数 MSPS 至数百 MSPS |
| 实用分辨率 | 6~8 位 | 12~16 位 | 8~18 位 |
| 判决方式 | 2^N−1 个比较器一次并行 | 每级小 Flash 粗量化加残差传递 | 单个比较器 N 次逐次逼近 |
| 转换延迟 | 约 1 个时钟周期 | 数个至十余个周期(流水延迟) | N 个比较周期 |
| 功耗与面积 | 高,随 2^N 膨胀 | 中高,分级后近似线性 | 最低,数字逻辑占比高 |
| 典型场景 | 高速链路前端、粗量化核 | 通信中频、雷达、高速采集 | 传感器、通用采集、便携多路 |
三类架构的选择逻辑可以一句话概括:Flash 卖的是单周期延迟和极致采样率,账单是指数硬件;SAR ADC 卖的是最低功耗和最小面积,账单是 N 个周期的迭代;Pipeline 取中间值,把一个大 Flash 拆成一串小 Flash,用流水延迟换分辨率,其多级工作机制见 流水线 ADC 多级结构。低速高精度端则是 ΣΔ ADC 调制器 的地盘,靠过采样和噪声整形而不是器件匹配换位数。
Flash 比较器阵列在真实系统里主要待三个位置。第一是高速 SerDes 接收机的前端量化,链路时钟动辄数 GHz,只需要几比特判决但容不下多周期延迟,串行编码背景可对照 8b/10b 编解码。第二是 Pipeline 每级内部的子 ADC,1.5~4 位的小 Flash 恰好落在它的甜区,分辨率难题留给残差放大与数字校正。第三是时间交织阵列里的单体通道,多个 Flash 错相采样拼出更高的总采样率,通道间失配的后台校正见 时间交织 ADC 校准。反过来,传感器采集、电池供电设备这类追求能效的场合选 Flash 就是用错了工具——那里是 SAR 的主场。
这一篇在知识体系里的位置
- 上游:ADC 采样与量化总览 给出 LSB、量化误差与架构谱系的共同语言;Flash ADC:并行比较阵列、温度计码转二进制与气泡错误 是本篇的结构概念篇,本篇负责把它的规模律与纠错电路算到数字层面。
- 横向:SAR ADC 逐次逼近 与 流水线 ADC 多级结构 构成选型表上的另外两极,流水线 ADC 每级位数与电容缩放 和 流水线 ADC 级间增益误差 解释 Flash 作为子 ADC 时的系统级约束。
- 机理纵深:起泡误差的概率根源接 ADC 比较器亚稳态误码 与 建立保持时间与亚稳态,失调治理接 比较器斩波失调,多通道拼采样率接 时间交织 ADC 校准,低速高精度对照 ΣΔ ADC 调制器。
总结
Flash ADC 比较器阵列用 2^N 个电阻制造门限、2^N−1 个比较器并行判决、一级编码器定位温度计码的唯一边界,换来约一个时钟周期的转换延迟。2 位与 3 位算例显示,判决过程就是输入与各级抽头电压的逐档比较,编码结果等于温度计码中 1 的个数。指数律的代价分三笔账寄达:输入电容是全部比较器输入管的纯并联,按 (2^N−1)·Cc 叠加并通过 τ = Rs·Cin 压低建立带宽;动态功耗与比较器数量同步翻倍;匹配约束下 LSB 每减半一次、单器件面积约需四倍,模拟面积在匹配受限区每一位近似膨胀八倍,三笔账共同把纯 Flash 钉在 6~8 位。起泡误差来自亚稳态、失调与时序偏斜对温度计码单调性的破坏,三点多数投票与 ROM 相邻地址纠错能把孤立单气泡收敛为最坏 1 LSB 的确定偏差,但对相邻双气泡失效,且无法替代比较器再生时间与预放这些源头治理。选型上,Flash 适合 GSPS 级、低分辨率、单周期延迟的 SerDes 前端与流水线子 ADC,中速高分选 Pipeline、低功耗选 SAR、低速高分选 ΣΔ,没有架构奇迹,只有把指数成本放在系统能承受的那一级。