跨时钟 skew 平衡:树间匹配与接口路径余量分配速查
更新时间:2026-10-05。单棵时钟树内部的 skew 怎么压,CTS 时钟树综合 已经讲过;这一篇解决的是另一个问题:当两棵(或多棵)时钟树之间存在同步数据通路时,它们之间的相对 skew 怎么平衡。单树 skew 是「家里整齐」,跨时钟 skew 平衡是「两家人对齐」,约束对象、优化手段、验收口径都不一样。本篇是速查向,给可直接照做的匹配方法与余量分配口径,底层概念见 时钟树基础。
本文要回答的问题
- 跨时钟 skew 和单树 skew 的本质区别是什么,为什么各树自己很好也会出事?
- 树间匹配(inter-tree latency matching)有哪三种主流做法,各适合什么场景?
- 接口路径的余量(margin)该怎么在两端之间分配?
- 异步域、半同步域要不要做匹配,做到什么程度?
- 验收时看哪些数,怎么判断匹配做够了没有?
一、为什么各树自己很好也会出事
单树 skew 的目标是同一时钟域内所有 sink 的到达时间彼此接近,CTS 工具对此很在行,做到几十皮秒以内不稀奇。但数据通路经常跨越两棵树:比如 CLK_A 域的寄存器发到 CLK_B 域的寄存器,两者同源、同频但分属两棵独立的树。此时 setup/hold 检查看的是两个时钟沿的差值——latency_B - latency_A 直接进时序方程。哪怕 A 树内部 skew 是 10ps、B 树内部 skew 是 8ps,只要 A 树平均 latency 是 1.2ns、B 树是 1.8ns,接口路径就天然背着 600ps 的 skew 项,setup 余量被啃掉一大截。
关键认知:跨时钟 skew 的约束对象不是「某棵树内部」,而是「源树与目的树的 sink 到达时间差」,而且只对接口路径两端相关的那些 sink 有意义——A 树里某个只跟 A 内部说话的寄存器,它晚到早到无所谓。所以优化的粒度天然是「匹配组(matching group)」,而不是整树。
二、树间匹配的三种做法
主流 CTS 流程里,让两棵树的 latency 对齐有三条路线,按自动化程度从高到低排列。
做法一:声明式延迟匹配约束。 现代 CTS 工具支持直接声明「把 CLK_B 的 insertion delay 匹配到 CLK_A」这类约束(不同工具叫法各异,常见 set_clock_tree_balance / balance group 之类)。工具在建树时会以参考树的实测 latency 为目标,给被匹配树补缓冲级数或调整拓扑。这是最省心的方式,适合同源同频、由同一时钟根分出的树。
做法二:锚点(anchor / balance point)配对。 对于跨层次结构的树——比如顶层树和各 block 内部树分段综合——在每段边界放锚点缓冲器,用 set_clock_balance_point 之类的命令指定「这些锚点的 latency 要两两相等」。好处是每段可以独立收敛,顶层只要保证锚点间对齐;代价是分段接口要预留锚点的物理位置和缓冲空间。
做法三:手工 padding。 老式或混合 mesh/tree 场景(见 clock mesh 与 tree 混合),工具约束表达不了,就手工在较短的一路插入延迟链(delay cell 或 buffer chain),把两路 latency 拉齐。灵活但难维护——每次 ECO 后 latency 漂移都要重算,而且 delay cell 对 PVT 波动的响应和真实树不完全一致,留量要比前两种多。
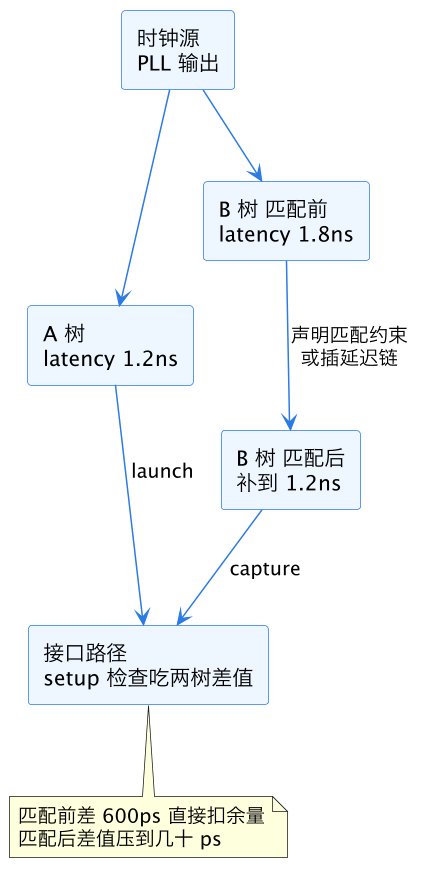
读这张图抓住一点:匹配动作发生在 B 树上,目标值取自 A 树的实测 latency,不是 spec 里的标称值。先把参考树做完、量准,再动被匹配树,顺序反了就是白做。
三、接口路径余量怎么分配
树间匹配把「时钟差」压下去之后,剩下的问题是接口路径本身的数据延迟余量怎么在两端之间分。经验口径如下表:
| 分配项 | 常用口径 | 说明 |
|---|---|---|
| 树间残余 skew | 周期的 3%-5% | 匹配后两树差值的签核取值,含 OCV 退化 |
| 源端 clock uncertainty | 见 clock uncertainty 设置 | jitter 加 matched 前的保守量 |
| 数据路径余量 | 两端各留一半 | 源域末级走线和目的域入口走线各占约一半预算 |
| CRPR 回赠 | 参考 CRPR 分析 | 同源分叉前的公共段可以拿回一部分悲观量 |
实践里最常见的错误是把余量全堆在一端:比如目的域入口处留了 40% 周期的余量,源域末级却贴脸走线,结果源端一个 ECO 就把接口打爆。正确的姿势是把接口路径当成一个整体预算,两端各分一半,并且把分配写进 block 级的时序预算文件,作为 数据流 S4:CTS 与布线阶段 交接契约的一部分。
四、哪些域要匹配、做到什么程度
不是所有跨时钟路径都值得做匹配,按域间关系分三档处理。
同源同频同步域:必须做,做到残余 skew 进周期 3%-5% 那一档,这是本篇主线的适用场景。
同源整数倍频域:做「沿对齐」而不是「全延迟对齐」——关心的只是对齐的那个公共沿上的差值,匹配约束写成对特定沿的相位对齐即可,其余沿由分频关系天然保证。约束写错成全延迟匹配会白白拉长高频树的延迟。
异步域:不做延迟匹配。异步域间靠 sdc 异步时钟组约束 切掉检查、靠同步器兜底,强行匹配纯属浪费缓冲器。但要注意 RDC(复位域交叉)路径有时需要类似的复位释放沿对齐,口径另算,见 CDC 与 RDC 检查。
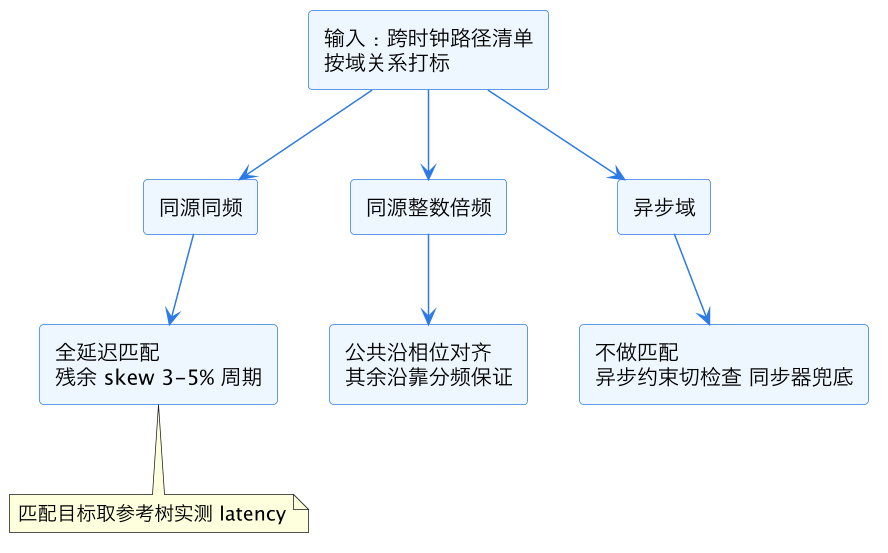
这张分流图就是接到跨时钟 skew 问题时的第一步:先按域关系分桶,再决定上不上匹配。跳过分类直接对所有跨域路径上匹配约束,是新手最常见的过度设计。
五、验收看哪些数
匹配跑完之后,建议盯四个数。第一,匹配组内各树 latency 的差值分布,签核 corner 下最大差应落在周期 3%-5% 以内,只看 typical corner 不算数——OCV 会把 typical 下漂亮的差值拉开。第二,被匹配树补出来的延迟级数:如果 B 树为了对齐 A 树多插了十几级缓冲,要评估多出来的 latency 对 hold 和功耗的影响,必要时反过来抬 A 树,两端往中间凑。第三,接口路径的 setup/hold 余量复检,确认匹配生效后余量真实变大,而不是被 uncertainty 的保守量吃掉。第四,ECO 之后的漂移:匹配值是从实测来的,任何一次改变树结构的 ECO 都可能让匹配失效,要把「匹配组 latency 差」挂进 数据流 S5:签核收敛 的看板做持续监控。和 useful skew 优化 同处一个设计时还要确认两者不打架——useful skew 是故意偏,树间匹配是故意齐,约束作用域必须分开。
这一篇在知识体系里的位置
本篇是 CTS 专题里「多树协同」这一格的速查页:单树方法论在 CTS 时钟树综合,缓冲器选型在 CTS buffer 与 inverter 选择,uncertainty 预算在 clock uncertainty 设置,流程坐标在 数据流 S4。跨时钟 skew 平衡把这些串起来:用单树手段实现树间目标,用签核手段守住结果。
总结
跨时钟 skew 平衡管的是多棵时钟树之间的相对延迟差,只对接口路径两端相关 sink 有意义:同源同频域做全延迟匹配(声明约束优先、锚点配对次之、手工 padding 兜底,目标取参考树实测 latency、残余差压到周期 3%-5%),整数倍频域只做公共沿相位对齐,异步域不做匹配走同步器;接口余量两端各分一半,验收盯签核 corner 下的树间差值、补出来的延迟级数、接口余量复检和 ECO 后漂移四个数。