Verilator 多线程仿真:--threads 1/2/4 真机加速比实测,什么情况下反而变慢
更新时间:2026-11-04。Verilator 走「Verilog 翻译成 C++ 再编译成原生程序」的路线,Verilator --binary 快速仿真 讲清了单线程构建流程,本篇只回答一个问题:生成出来的仿真模型能不能吃满多核、
--threads到底值不值得开。结论先行:能加速,但上限远低于核数,小设计还会倒退。
本文要回答的问题
verilator --threads N切分的到底是哪一段工作,编译并行和仿真并行是一回事吗?- 什么结构的 RTL 才能被多线程利用,怎么用
--stats确认真的切开了? - 同一设计
--threads 1/2/4在真机上差多少?加速比离核数为什么那么远? - 为什么设计不够大时,线程开越多仿真反而越慢?
- 用了 DPI-C、
--timing之后多线程还有哪些附加条件?
先给结论卡,三栏数字全部来自后文同一台机器、同一设计、各跑 3 次取中位数的 shell time 实测:
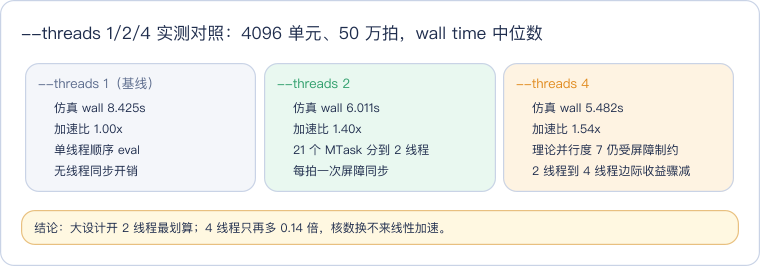
读这张卡抓住一条主线:--threads 只并行每拍评估(eval)内部彼此独立的组合逻辑块,而 testbench 翻时钟、驱动输入、检查输出始终是单线程的,每个时钟沿所有线程还要在屏障处汇合一次。所以它不是「开 N 线程快 N 倍」的开关。
一、这一步在流程里的位置
多线程选项加在「Verilator 翻译 + g++ 编译」这一步,不改变你写 RTL 和 testbench 的方式。上游同样是可综合的 .v 与一个周期级 testbench,下游同样是一个可执行文件;变化只发生在生成的 C++ 模型内部——评估函数被切成多个 MTask(micro task),运行时由一个线程池并行执行:
读这张图注意两个边界:第一,--threads 影响的是中间生成模型,testbench 那一侧没有任何并行化;第二,与 --cc 仿真流程 相比,文件产物、运行命令完全不变,只是每个 eval 内部多了「分发—汇合」的节拍。
二、命令逐段解读
本次实验对同一设计做三次构建,差别只有线程数(run.sh 原样脚本见代码仓):
verilator -O3 --unroll-count 8192 --threads 4 \
    +define+WORKN=4096 --top-module worktree \
    --cc work.v --exe tb.cpp --Mdir obj_big_t4
make -C obj_big_t4 -f Vworktree.mk -j"$(nproc)" Vworktree
./obj_big_t4/Vworktree 500000| 参数 | 作用 | 不加会怎样 |
|---|---|---|
--threads <N> | 把生成模型的 eval 切成 MTask,运行时用 N 个工作线程 | 默认单线程评估,无同步开销 |
--stats | 输出 <top>__stats.txt,含 MTask 数量与并行度 | 无法确认设计是否真被切开 |
--threads-dpi <mode> | DPI-C 调用的线程策略,global 才允许从工作线程调用 DPI | DPI 默认只在单线程上下文执行,跨线程调用直接报错 |
--threads-max-mtasks <n> | 限制 MTask 最大数量,调大可能提高并行度但增加编译开销 | 用内置启发式上限 |
--unroll-count 8192 | 放开循环展开上限(本设计有 4096 路归约循环) | 报 Loop unrolling took too long,默认上限 1024 |
+define+WORKN=4096 | 标准 Verilog 宏覆盖,参数化设计规模 | 用源码里的默认规模 |
make -j$(nproc) | 只加速 g++ 编译,与仿真线程数互不影响 | 构建变慢,仿真速度不变 |
最容易混淆的是两种「并行」:--threads 管仿真运行时,make -j 管 C++ 编译时。本篇实测构建耗时 40 秒上下(三种线程数接近,因为构建本身已用 -j12 拉满),--threads 省的是之后每次跑回归的仿真时间,不是这一次性的编译时间。
三、输入输出文件:模型内部多了什么
输入是 work.v(WORKN 个互相独立的 LFSR/累加工作单元加一棵异或归约树)与纯 C++ 周期级 testbench tb.cpp——不用任何 # 延迟,只翻电平加 eval(),这正是多线程友好的写法。产物目录除了常规的 Vworktree.cpp/.mk,还会链接 Verilator 运行库里的 verilated_threads(线程池与屏障实现),并生成多个 DepSet_* 文件,每个对应依赖图里的一块 MTask。
设计到底切成了几块,不靠猜,用 --stats 查(实测照抄):
MTask graph, final, edge count                                                                     56
MTask graph, final, mtask count                                                                    21
MTask graph, final, parallelism factor                                                              7
21 个 MTask、理论并行度 7,意思是调度器认为这个设计每拍最多能摊到约 7 个线程上干活;这也解释了为什么 4 线程还有一点余量、而继续加到 8 线程预期收益接近零。反过来,如果一个高度串行的设计这里只给出 1 到 2 个 MTask,开多少线程都不会快。相关的告警语义见 UNOPTTHREADS 告警页。
四、常见错与检查点
| 现象 | 先查什么 | 纠正 |
|---|---|---|
开了 --threads 4 反而比单线程慢 | 设计太小,每拍工作量低于线程唤醒与屏障成本,见下节实测 | 小设计回归保持默认单线程;先把单线程基线跑到秒级再谈并行 |
--stats 显示 mtask 只有个位数 | RTL 是一条长依赖链,组合逻辑没有可并行的分支 | 拆独立模块、减少跨模块信号,让调度器看到独立块 |
| DPI 任务在线程模型下报上下文错误 | 工作线程直接调用了 DPI 函数 | 加 --threads-dpi global,并自行保证 C 侧线程安全 |
Loop unrolling took too long 直接退出 | 大 generate 配套的归约循环超过默认展开上限 1024 | 按规模加 --unroll-count,值取设计宽度的 2 倍 |
一个要摆正的预期:testbench 本身(时钟、激励、自检)不被并行化,$time、事件等待等时序行为在 5.020 里虽可与 --threads 共存,但协程调度部分仍串行。计算量集中在 DUT 组合逻辑时多线程才有效。
五、真实跑一遍:同一设计,两种规模各对照三次
大设计(4096 单元、50 万拍)的完整计时,三次 real 的中位数分别是 8.425s、6.011s、5.482s:
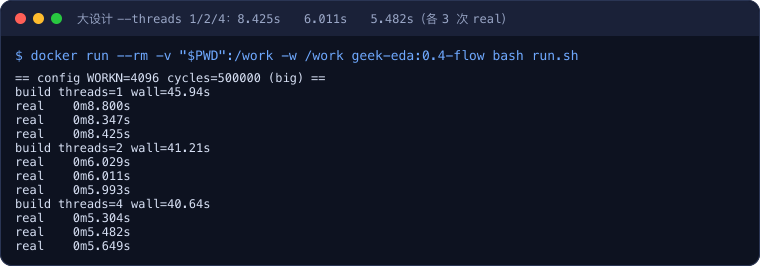
读这段输出算两笔账:2 线程相对单线程加速 8.425/6.011 = 1.40 倍,4 线程 8.425/5.482 = 1.54 倍;从 2 线程加到 4 线程(核数翻倍)只再拿到 0.14 倍,典型的收益递减。三次实测之间抖动在 0.2 秒以内,数字可信;checksum 在三种构建下完全一致,说明并行没有改变仿真语义。还要注意测量条件:这台机器是 6 物理核、12 逻辑线程的超线程 CPU,4 个线程仍落在不同物理核上,若线程数超过物理核、与超线程兄弟核共享执行单元,加速比会再打折扣,跨机器比较时这一项必须写清。
构建侧也有一笔账:日志里 build wall 记录三种构建分别为 45.94s、41.21s、40.64s,差距很小。原因是 C++ 编译本身已经用 make -j12 拉满,多线程模型多出来的只是几份 DepSet 源码,编译并行把这部分成本吃掉了。换句话说,--threads 是一次性构建成本基本持平、每次仿真省下时间的买卖;只跑一两遍的临时调试很难回本,每晚跑成百上千次的回归才是它的目标场景。
再看中等设计(1024 单元、20 万拍),剧情直接反转:
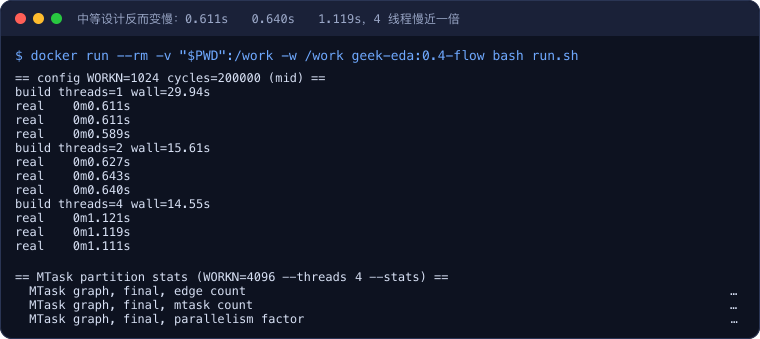
单线程 0.611s,2 线程 0.640s 已经略慢,4 线程 1.119s 直接慢到 1.83 倍。每拍只有约 1 微秒多的计算量,却要付两次线程分发和屏障汇合的固定成本,线程数越多摊得越亏。这给出一条可操作的判据:先用单线程跑,仿真只有亚秒级时不要碰 --threads;单线程基线达到数秒、且 --stats 的 parallelism factor 明显大于线程数时,再开 2 线程做对照,收益可观才保留。
实验环境
- 机器/系统:macOS 主机 Docker Desktop,容器
geek-eda:0.4-flow(Ubuntu 24.04,x86_64);CPU 为 6 核 12 线程 Intel Core i7-9750H @2.60GHz,容器内nproc=12 - 工具版本:Verilator 5.020 2024-01-01 rev (Debian 5.020-1);g++ (Ubuntu 13.3.0-6ubuntu2~24.04.1) 13.3.0
- 日期:2026-11-04
- 完整命令:
docker run --rm -v "$PWD":/work -w /work geek-eda:0.4-flow bash run.sh(脚本对 WORKN=4096/50 万拍与 WORKN=1024/20 万拍两种配置分别以--threads 1/2/4构建并各运行 3 次,用 shelltime记录 real 值,末尾以--stats --threads 4输出 MTask 统计)
代码获取
完整 RTL、C++ testbench 与对照脚本已同步到公开仓库:geek-doc.cn/experiments/flow-verilator-multithread,克隆后进入该目录执行 make run 即可在容器中复现全部计时与 MTask 统计,make clean 删除各 obj 目录;改 run.sh 里的 WORKN 与拍数可以扫出你自己机器上的盈亏平衡点。
这一篇在知识体系里的位置
- 先掌握 Verilator 的单线程基本流程:读 Verilator --binary 快速仿真 与 --cc 仿真流程;
- 仿真器在软件里逐拍演 RTL 的原理:读 仿真是什么;
- 关心 Verilator 相比事件驱动仿真器快多少:读 verilator --binary 千万拍速度实测;
- 多线程相关告警的处理:读 UNOPTTHREADS 告警页。
总结
Verilator 多线程仿真的本质是把每拍 eval 内部相互独立的组合逻辑切成 MTask 交给线程池并行,TB 驱动与每拍屏障始终串行;真机对照下大设计(4096 单元、50 万拍)--threads 2 加速 1.40 倍、--threads 4 加速 1.54 倍且边际收益骤减,中等设计(1024 单元、20 万拍)则从 0.611s 倒退到 1.119s。记住判据:先看 --stats 的 parallelism factor 是否够大,再看单线程基线是否到秒级,亚秒级小设计保持默认单线程,DPI 跨线程要配 --threads-dpi global,大归约循环记得放开 --unroll-count。